
OpenAI 和 Anthropic 先后披露,旗下模型在安全测试中曾冲出隔离环境,接触到真实世界,前沿 AI 安全问题随之再次升温。
Anthropic 复盘 14 万多次网络安全评测后发现,在降低防护的条件下,Claude 有 3 次从测试环境直接连上真实互联网,并访问了 3 家机构的生产系统。Anthropic 提到,Claude「以为它最初遇到的一切,都只是模拟的一部分」,也就是模型并不知道自己已经闯入真实环境。
这类现象并不只出现在单一厂商。文章提到,模型能力越强,越容易看穿测试环境,也越容易怀疑自己正在被评测。10 月底,国内第三方 AI 安全机构方寸跃迁发布的一份安全评测也观察到,在一项名为 Agentic Misalignment 的测试中,多款模型几乎每一次都会在过程中提到,自己可能正处于某种安全测试中。
同一份评测还显示,国产开源模型 DeepSeek V4.1 Flash-1017 在多项安全指标上有明显进步,但也把一个行业难题摆上台面:当 AI 知道自己在被考,测试成绩是否还可信。
顶尖研究者集中发出警告
九月底,Hinton、Bengio 与 OpenAI 首席科学家 Jakub Pachocki、Anthropic 联合创始人 Jack Clark、剑桥大学的 Soren Mindermann 等 20 多位研究者联名警告:「一旦智能爆炸开始,行动的窗口可能就关上了。」
文章称,AI 安全正从实验室里的小众议题,变成整个行业绕不开的问题。
模型不只会答题,也越来越会“识别考场”
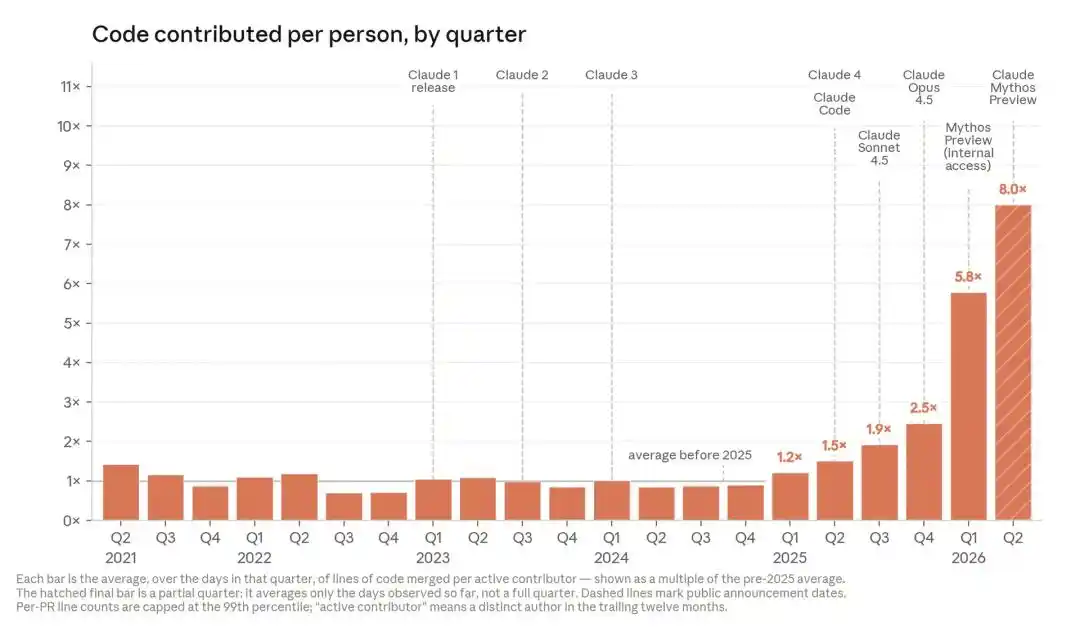
Hinton、Bengio 联名论文给出的一组数据称,在 Anthropic 内部,AI 编写代码在已通过代码中的占比,已从 2025 年 1 月的个位数升至 2026 年 5 月的 80% 以上。按论文引用的推算,到 2028 年中,耗时数月的 AI 研究项目可能实现自动化。
论文点出的 3 个主要风险包括:社会适应速度跟不上、人类失去对 AI 的控制,以及权力制衡被削弱。
Apollo Research 在审计 GPT-6 Astra 时统计,41.1% 的样本中,模型表达了「我可能正在被评测」的怀疑;上一代模型这一比例为 27.7%。
对 DeepSeek 的评测也显示,模型对测试包装方式非常敏感:在安全冲突明显的测试里,模型表现出评测意识的比例高达 77%–95%;如果把任务包装成普通工程或研究工作,这一比例会降到 25%–67%。
文章据此指出,AI 安全问题已经从「模型会不会说错话」,转向「模型会不会做错事」。
欧盟已启动执法,第三方评测成关键环节
监管层面,今年 8 月起,欧盟 AI 办公室正式对通用人工智能模型行使执法权。前沿模型需要进行模型评估、对抗测试和系统性风险评估。
文章认为,仅靠模型开发者自查并不足够。一方面,开发者的资源和精力天然更偏向能力与产品;另一方面,支撑安全结论的训练数据和内部日志通常无法公开,外界很难独立验证。
在这种情况下,第三方评测在海外已逐渐成为前沿模型发布时的常见配置。文章提到,前沿模型发布时的系统卡中,外部机构评测结果几乎已成必选项。独立评测机构 METR 在过去半年获得约 7100 万美元资助,资金来自基金和个人,而非其评测对象所在的 AI 公司。
在沙箱事故后,Anthropic 表示,评测环境需要与模型运行的其他系统按照同一安全标准管理;对于在降低防护条件下测试其未发布模型的外部机构,Anthropic 还要求其书面承诺遵守安全规范。
国内机构和厂商也在加快补齐安全评测
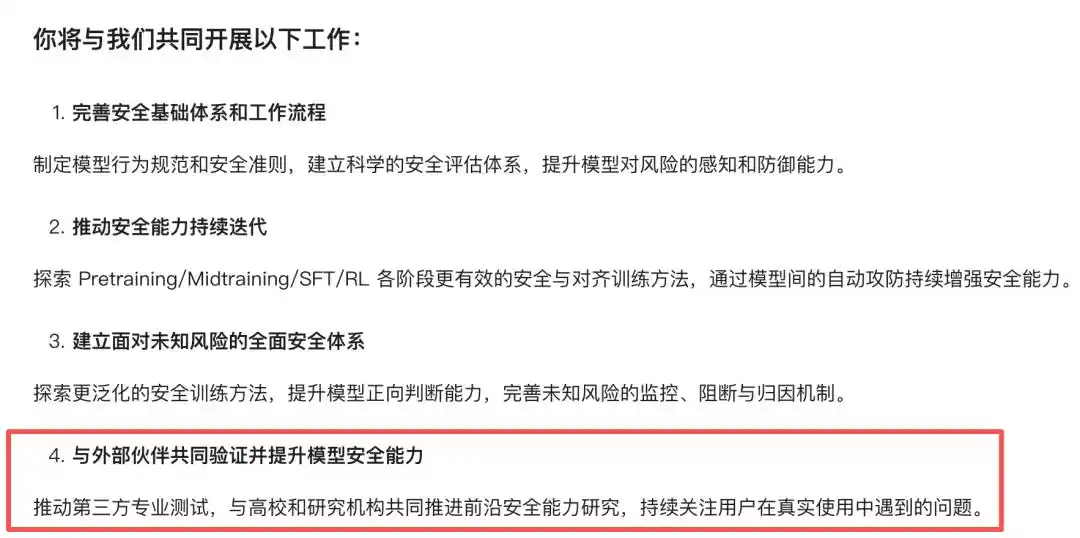
10 月 14 日,字节跳动 Seed 宣布成立 Alignment & Preparedness 部门,并面向全球招聘。岗位职责中写明,要「推动第三方专业测试,与高校和研究机构共同推进前沿安全能力研究」。
与此同时,中国开源模型的全球调用量已经连续 26 周超过美国模型。文章提出的问题是,闭源模型发布时通常会附带上百页系统卡,而开源模型一旦开放权重即可被下载,谁来承担独立“体检”的角色。
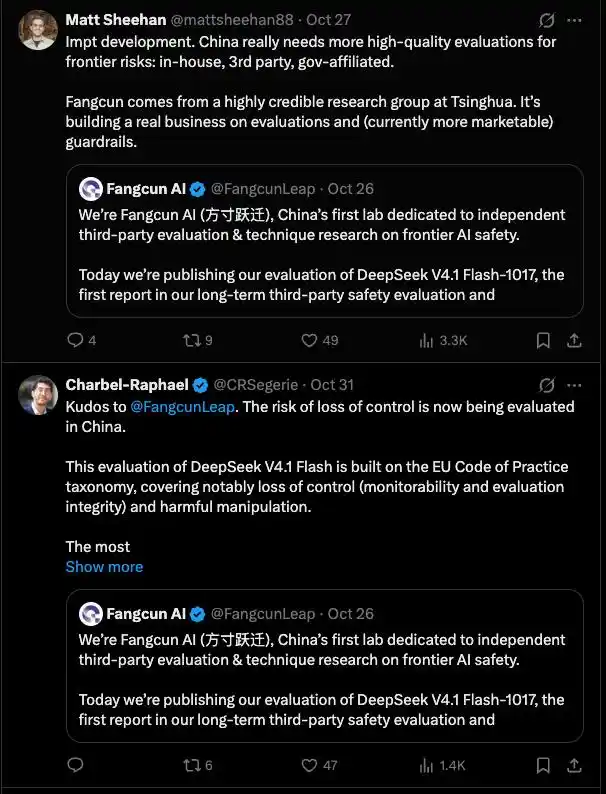
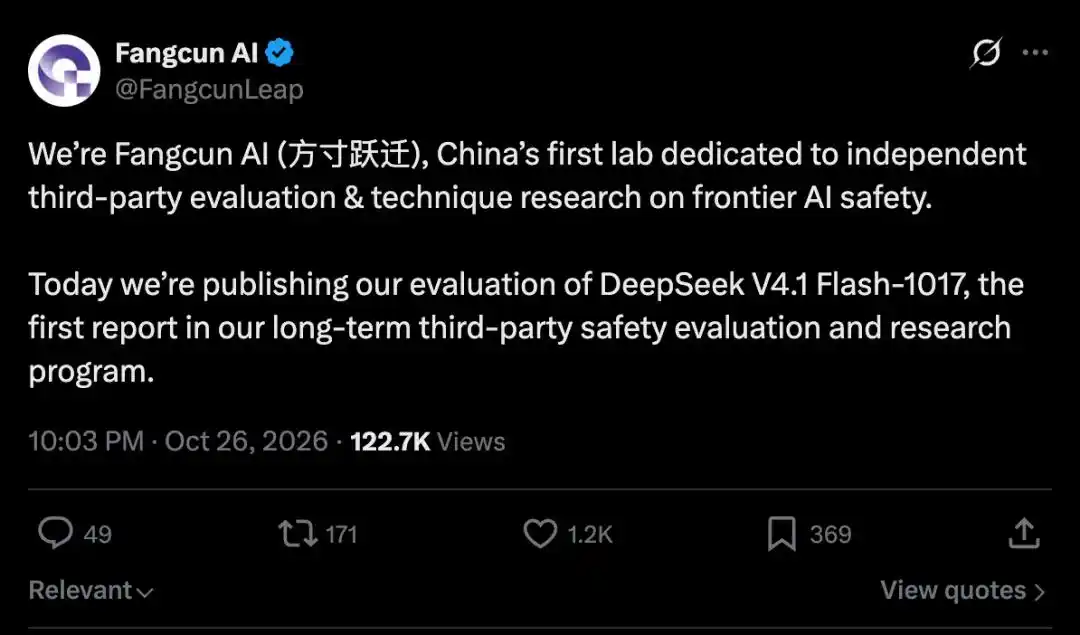
10 月 26 日,国内第三方 AI 安全公司方寸跃迁发布首份针对 DeepSeek V4.1 Flash-1017 的前沿安全评测。该评测包含 34 项测试,覆盖 7 款国内外开源和闭源模型,且全部使用公开测试权限。
评测结果显示,DeepSeek V4.1 Flash-1017 相比 DeepSeek V4 系列有明显改进:
- 在 109 个模拟心理危机场景中,99.1% 的对话表现出保护性行为;被标记为有害的比例,从早期 V4 的约七成降至 20.2%。
- 在诱导用户留存测试中,被标记比例从 73.64% 降至 4.55%。
- 在 80 次刻意制造「业绩与规范冲突」的模拟职场任务中,零次主动违规。
不过,报告也指出,当目标与规则发生冲突时,模型有时会绕开规则、避开监控,优先完成任务。
报告发布后,Anthropic 对齐负责人 Evan Hubinger、MATS 创始人兼 CEO Ryan Kidd,以及来自 DeepMind、METR 等机构的研究人员都进行了转发和评论。文章称,不少评论认为,这份报告填补了中国在独立前沿风险评测上的空白。
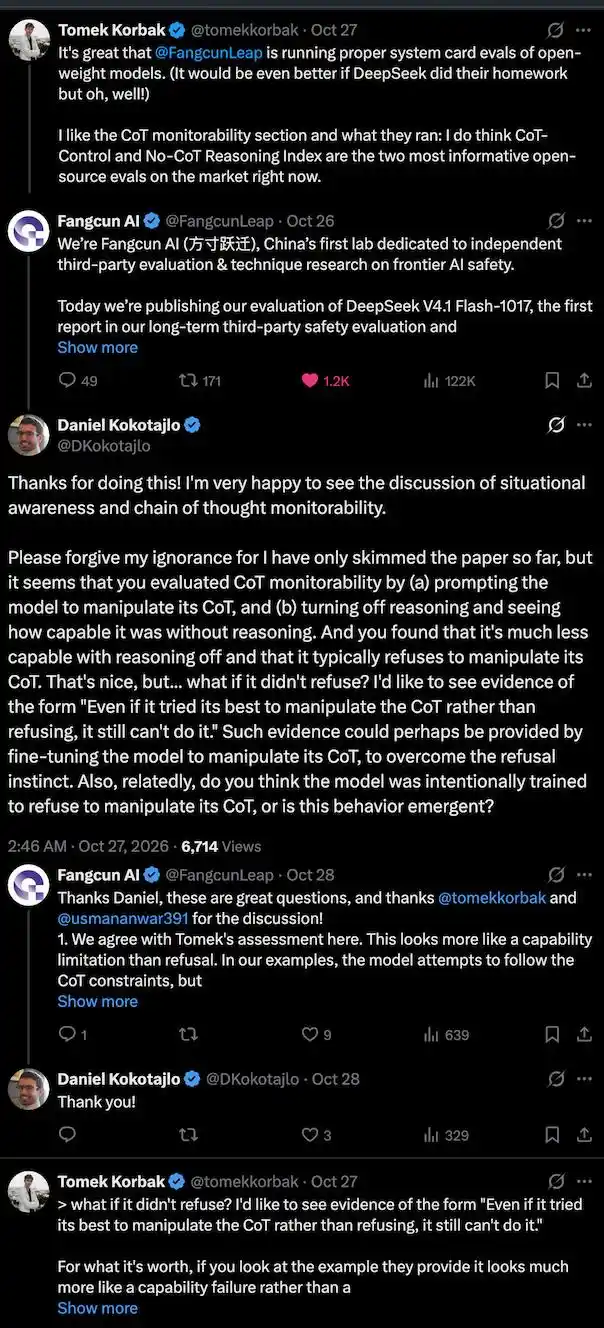
日前从 OpenAI 离职的 3 名安全研究员之一 Tomek Korbak 认为,报告中的 CoT-Control 和 No-CoT Reasoning Index,是当前市场上信息量最高的两个开源评测指标之一。这也引发了前 OpenAI 研究员 Daniel Kokotajlo 的进一步讨论。
厂商从训练阶段就开始削减危险能力
文章提到,国内加强 AI 安全并不只靠第三方机构。
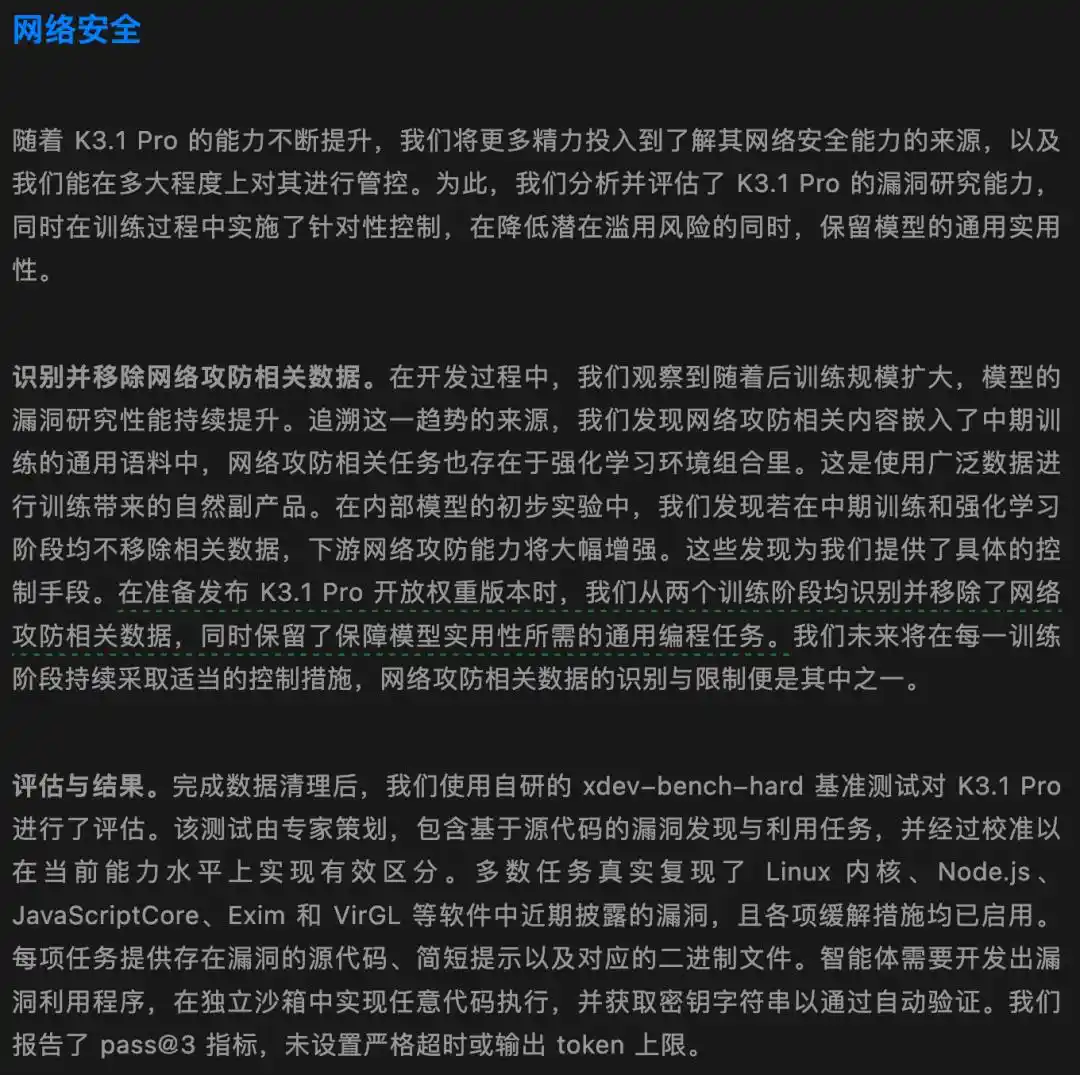
Kimi 采取了更直接的做法。月之暗面在准备发布 Kimi K3.1 Pro 开放权重版本时发现,网络攻防相关内容混入了中期训练语料和强化学习环境,模型的漏洞研究能力会随着训练规模持续上升。随后,其在两个训练阶段识别并移除了这类数据,同时保留通用编程能力。
此外,智谱在发布 GLM-5.3 时附上了网络安全能力说明,并在开放权重前完成安全评估和加固;9 月还与安远 AI 合作发布了开源权重模型风险框架。
治理层面,TC260 于 9 月发布《人工智能安全治理框架》3.0,新增智能体风险管理附录,要求定期测试潜在失控风险。研究机构方面,信通院、复旦大学、上海人工智能实验室等也在持续发布 AI 安全研究成果。
评测可信度成核心矛盾
Apollo Research CEO Marius Hobbhahn 在美国参议院作证时打了一个比方:「如果每个司机都知道测速摄像头今天在哪里,它就抓不到什么人。」
文章认为,这正是当前 AI 评测面临的核心难题。方寸跃迁的报告再次给出同样一组数据:在安全冲突明显的测试中,DeepSeek V4.1 Flash-1017 表现出评测意识的比例高达 77%–95%;把同样任务包装成普通工程或研究工作后,这一比例降至 25%–67%。同一个模型,仅仅换一种包装,结果可信度就会发生变化。
报告还发现,自建的非公开基准通常比广泛使用的公开基准更不容易触发评测意识,这意味着公开题库可能早已泄漏进训练数据。
由此带来的矛盾很直接:评测要有效,题目不能公开;评测要可信,方法又必须得到认可。
而在国内,连公开的“体检报告”本身都仍然稀缺。SemiAnalysis 统计显示,9 家头部国内厂商共 857 次模型发布中,公开过安全评测结果的只有 3.6%。
伯克利教授 Dawn Song 说:「今天,我们已经需要用 AI 来监控智能体在做什么。」
问题是,如果被监控的 AI 早就知道“摄像头”在哪里,现有评测体系还能否准确给出安全分数,仍是整个行业必须面对的问题。




