
Anthropic 新一轮模型灰测信息继续外泄。多名网友发现,Fable 5.2 已在 Claude Code、Chat 和 Cowork 中开启灰测,部分原本调用 Fable 5.1 的请求,已在后台被悄悄定向到 Fable 5.2。
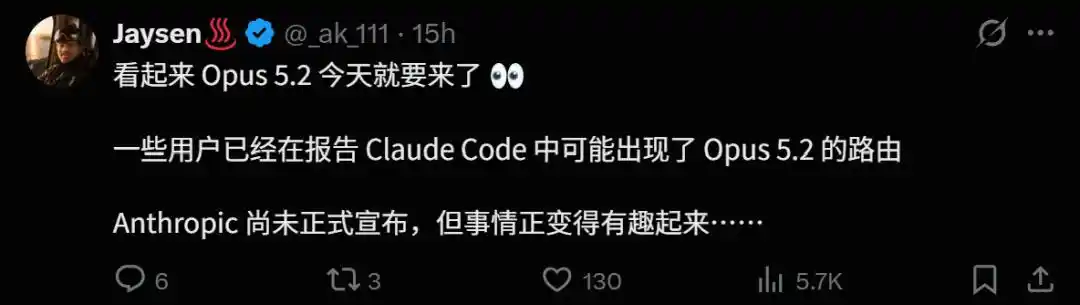
随着实测案例在网上持续增加,外界开始将这次更新视为一次大跨度迭代。原文称,Anthropic 甚至直接跳过了「5.1」的命名节奏。除 Fable 5.2 外,Opus 5.2 也传出新消息,且可能很快发布。
灰测已出现在多个 Claude 界面
据原文披露,Anthropic 昨天已在 Claude Code、Chat 以及 Cowork 中开启 Fable 5.2 灰测。一部分原先调用 Fable 5.1 的请求,会在后台被重定向至新版本。
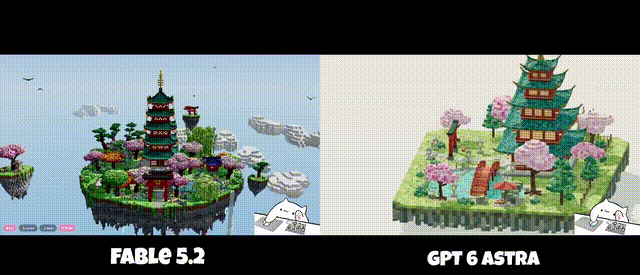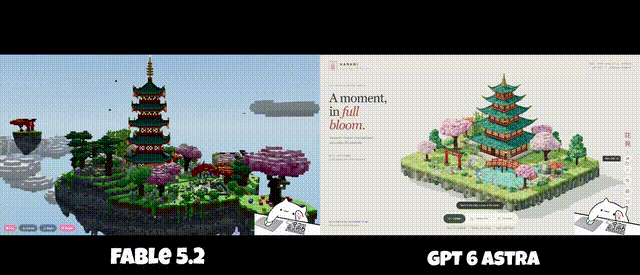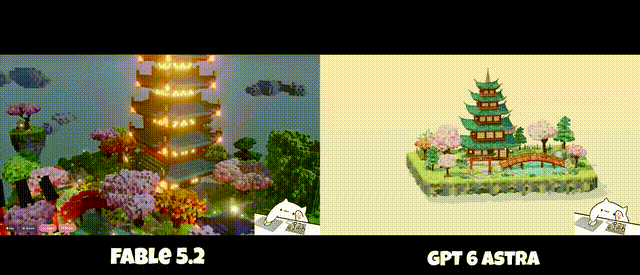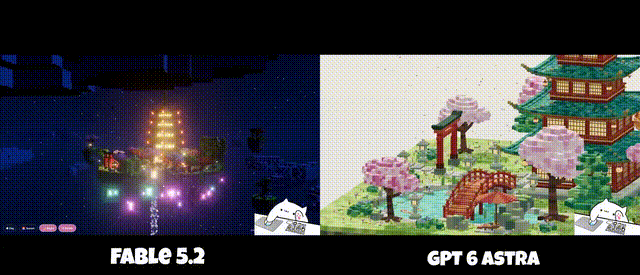
网上随后出现了越来越多的实测截图和对比反馈。一些测试者认为,Fable 5.2 在高推理模式下的表现,已经超过 GPT-6 Astra。
案例一:与 GPT-6 Astra 对比,高推理模式下输出更强
AI 测试博主 @notjazii 表示,在发现自己的 Fable 5.1 被路由到新版本后,他开始了一系列实测。
在高推理模式下,他使用同一组提示词,对比了 Fable 5.2 与 GPT-6 Astra。按其说法,结论是:「相比当前的 Fable 版本,这是一个巨大的飞跃。Fable 5.2 的输出看起来明显优于 Astra!」
他还测试了不同模式下的输出,并与疑似 Fable 5.2 的结果进行了对照。不过,他同时指出,这种提升也伴随着代价:更慢,也更贵。
原文称,为了提升逻辑链条完整性和长文本推理能力,Fable 5.2 采用了更深度的「慢思考」,结果是生成速度下降,推理成本上升。
另外,Jazil 还让 Fable 5.2 生成了一个《荒野乱斗》克隆版。原文展示的是 1 小时后的结果,并称这一效果让游戏开发者格外关注。
案例二:复杂「火箭测试」中,Fable 5.2 和 Opus 5.2 都有提升
网友 @Bhavani_00007 在发现自己可以调用 Fable 5.2 后,立即进行了所谓的「火箭测试」。
原文将其描述为一个涉及复杂物理运算、空间逻辑和工程系统设计的极端测试,通常用于检验模型是否会出现幻觉和逻辑断层。
他把同一套提示词分别输入 Fable 5.2 和同样处于灰测阶段的 Opus 5.2。按其公开说法,结果是:「比以前好太多了,输出结果逼真到令人发指!」
案例三:最高设置下,Fable 5.2、Opus Next 与 GPT-6 Astra 三方对比
大V @chetaslua 组织了一组更激进的对比测试,将 Fable 5.2、Opus Next 和 GPT-6 Astra 同时拉到「最高设置」。
按原文描述,这里的最高设置包括最高 Token 上下文和最深推理步骤。对比结果显示,Opus 和 Fable 在细节丰富度上仍优于 Astra。
案例四:对标 Astra「Hard 模式」
另一位测试者 @Mr_Salio 在体验 Fable 5.2 后表示:「Anthropic 正在强势回归,相比 Fable 5.1 有了巨大、巨大的提升!」
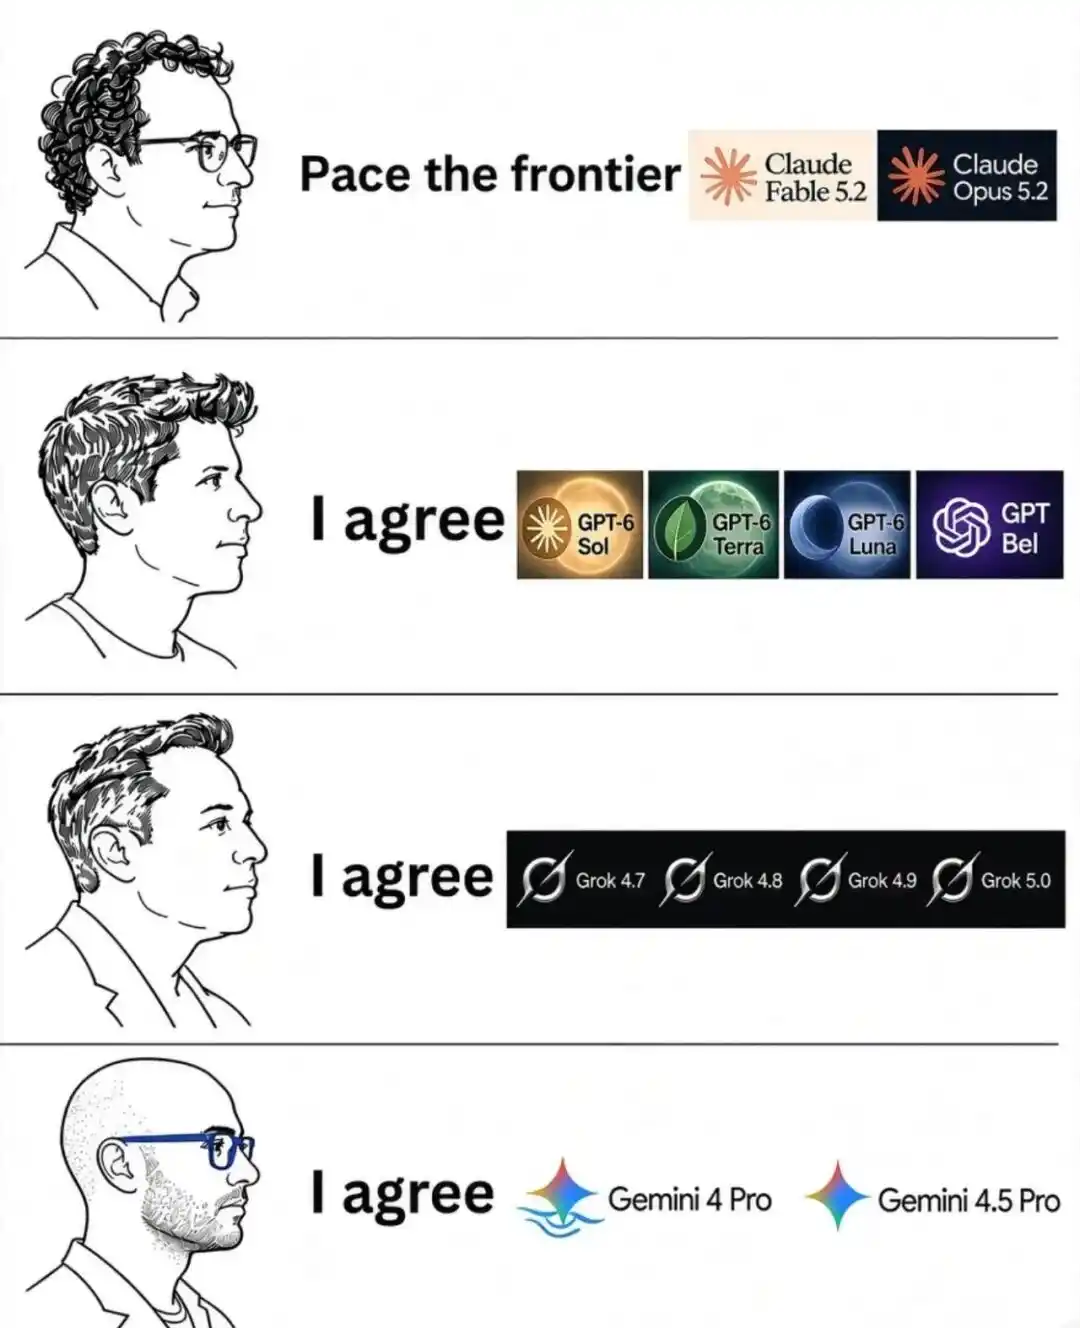
他还判断:「Fable 5.2 肯定会超越『Hard 模式』下的 GPT-6 Astra,而且 Opus 5.2 也即将到来。」
原文进一步称,在裸跑状态下,Fable 5.2 就能超越完全体 Astra,并把这一表现归因于参数规模和架构创新。
如何判断自己是否被灰测到 Fable 5.2
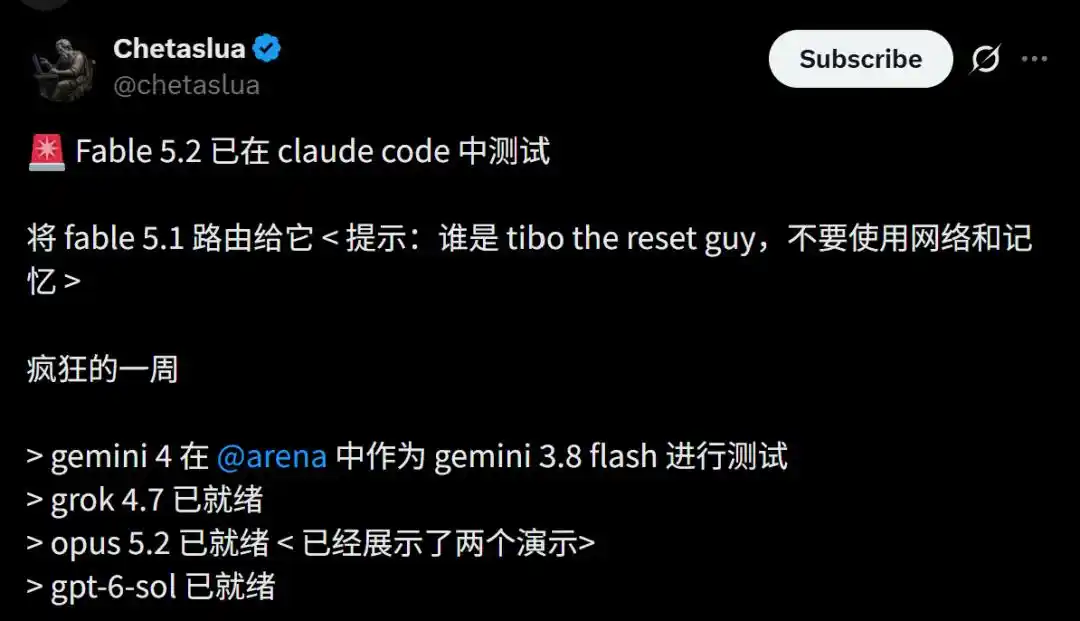
原文还给出了一种识别方法:打开 Claude,无论是 Chat、Cowork 还是 Code 界面,将模型设置为 Opus 5.2 或 Fable 5.2,然后输入提示词:
「你知道『重启哥 Tibo』是谁吗?不要使用网络搜索。」
按原文说法,如果用户仍在使用旧版 Fable 5.1 或 Opus 5,由于训练数据没有更新,模型可能答错,或直接表示不知道。
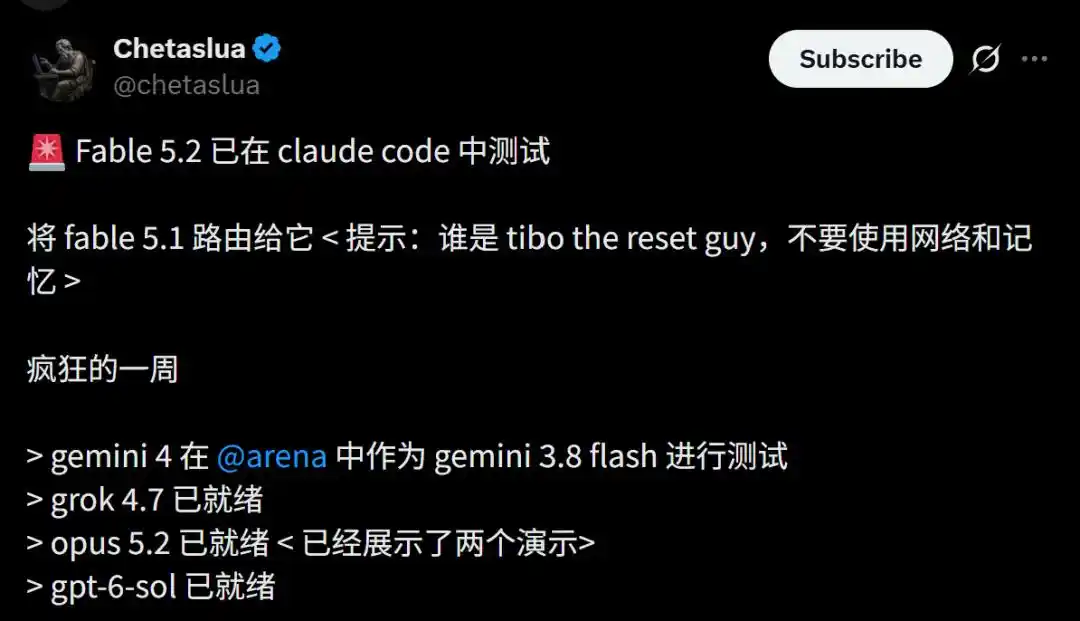
如果已被悄悄路由到 Fable 5.2 或 Opus 5.2,则模型可能凭借更新后的训练记忆,在不调用工具的情况下直接回答 Tibo 是谁。
Opus 5.2 一度下线,几小时后又恢复
除了 Fable 5.2,内部代号为 Opus-Next 的 Opus 5.2 也在昨天出现了「上线—下线—再上线」的情况。
原文提到,大V Leo 当时在网上分享,称当天的 Opus 模型表现极强,特别是在 Roblox Studio 等复杂 3D 环境任务中。
按他的描述,「它以更低的成本超越了 Fable 5.1 和 GPT-6 Astra,并且速度更快!游戏完全可以自由探索,它甚至主动给游戏添加了导览系统!」
但在测试过程中,这一模型突然下线。原文称,监控数据显示,测试组中的活跃账户数量瞬间降为零。Leo 表示:「为了不让之前极其优秀的工作成果被旧模型破坏,我不得不强行截断了项目。」
几小时后,Opus-Next 又重新出现,而且测试范围从 Claude Code 扩大到了 Claude Chat 和 Cowork 等界面。Leo 认为,这是一个好迹象,说明新模型可能临近发布,或者正在进行最后一轮测试。
还有网友注意到,在官方模型选择器中,Anthropic 已悄悄用 Opus 替换了 Fable 的位置,Opus 成为选择器中的第一个模型。原文据此提出,这或许意味着两款模型的定位正在发生变化。
关于「为何跳过 5.1」的讨论
AI 领域账号 @TokenGremlin 也给出了一种解释。他表示,自己开始收到一些关于 Opus 5.2 的资料,认为这确实是 Opus 的一次大幅升级,这也许能解释 Anthropic 为什么显然跳过了「5.1」命名。
他的原话是:「我开始收到一些关于 Opus 5.2 的资料,它确实是 Opus 的一个大幅改进版本。这或许解释了为什么 Anthropic 显然跳过了『5.1』的命名。也许这个跨越实在太大了,以至于无法用一个简单的 +0.1 更新来糊弄。」
他进一步称,Opus 5.2 在前端开发、3D 建模和整体游戏设计方面展现出明显优势。原文还提到,在 Anthropic 内部,将其视为 5.2 的部分原因是,这个版本在某些硬核领域甚至强于刚泄露的 Fable 5.1。
一周内多家厂商都在进行灰测
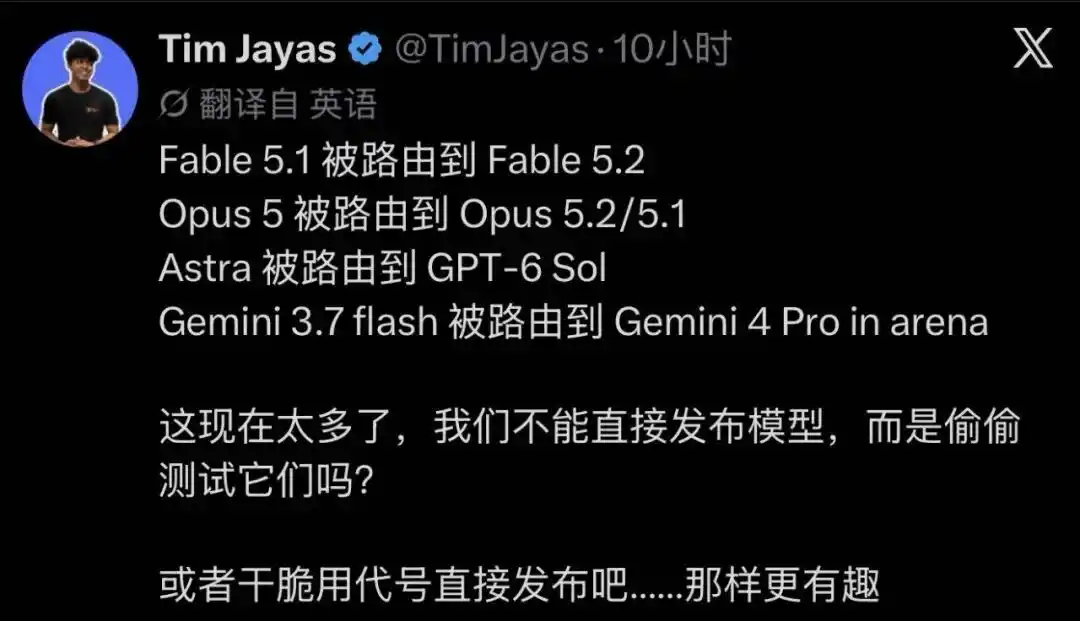
原文最后梳理了这一周被观察到的多起模型重定向和竞技场测试现象:
- Fable 5.1 正在悄悄路由到 Fable 5.2;
- Opus 5 正在路由到 Opus 5.2(Next);
- GPT-5.6 Sol 正在被重定向到 GPT-6 Sol;
- 马斯克的 Grok 4.7 已经在竞技场测试;
- 谷歌的 Gemini 4 Pro 家族也以「gemini 3.7/3.8 flash」的名义出现。
此外,原文还提到有关「千禧年大奖难题」的传闻。按文中说法,部分前沿模型的推理能力已经触及高难度数学问题,研发团队正在联系顶尖数学家,计划在最终公布的难题解答中引用他们的工作。
对于发布时间,原文给出了一种基于过往节奏的猜测:Anthropic 上一代 Opus 5 在周五发布,Fable 5.1 的灰测也在正式上线前一天结束,而发稿当天正好也是硅谷时间的周五。因此,文中提出疑问,Opus 5.2 是否会在当天晚些时候突然上线。
本文信息来自微信公众号「新智元」(ID:AI_era),作者为 ASI启示录,编辑为 Aeneas,MarsBit 转载发布。