OpenAI 于 9 月 8 日发布 ChatGPT Images 2.5,主打更锐利的细节、更丰富的纹理、更自然的光照,以及在编辑时更好保留未被要求修改的部分。公司称,与 Images 2.0 相比,图像生成延迟最多下降 50%;API 现已提供两款新模型——GPT-Image-2.5 Flare 和 GPT-Image-2.5 Sunburst,其中 Flare 为默认快速版本,Sunburst 则面向更高精度的编辑场景。
这次测试是 Decrypt 在 5 月那轮对比的延续。上一次,GPT Image 2 与 Nano Banana 2 在 8 个项目里互有胜负,GPT Image 2 赢下更多类别,但在提示词约束堆叠过多时,画面会出现明显的过度锐化伪影。新一轮测试要看的重点也很直接:OpenAI 的新模型有没有把这个问题修掉。
Decrypt 表示,这一轮继续使用同一评测视角,保留或调整了此前几轮中的 6 个类别,并向两款模型输入同样的提示词。Google 一侧使用的是 Nano Banana 2,也就是 Gemini 3.1 Flash Image,而不是速度更慢、偏重审慎生成的 Nano Banana Pro。文章将这次对比定义为同档位对决:OpenAI 的新一代“快速且精细”模型,对上 Google 的“快速且精细”模型。
OpenAI 在 2.5 版本上改了什么
Decrypt 认为,OpenAI 的图像模型此前几代都有比较鲜明的缺陷。最早的 GPT Image 1 长期带有偏暖、偏黄的色偏,网络上甚至给它起了「尿黄滤镜」的外号;OpenAI 既没有完整解释,也没有彻底修复。到 GPT Image 2,这个问题被另一类问题取代:当提示词限制太多时,输出图像会被过度锐化,呈现出粗糙、处理痕迹很重的伪影。
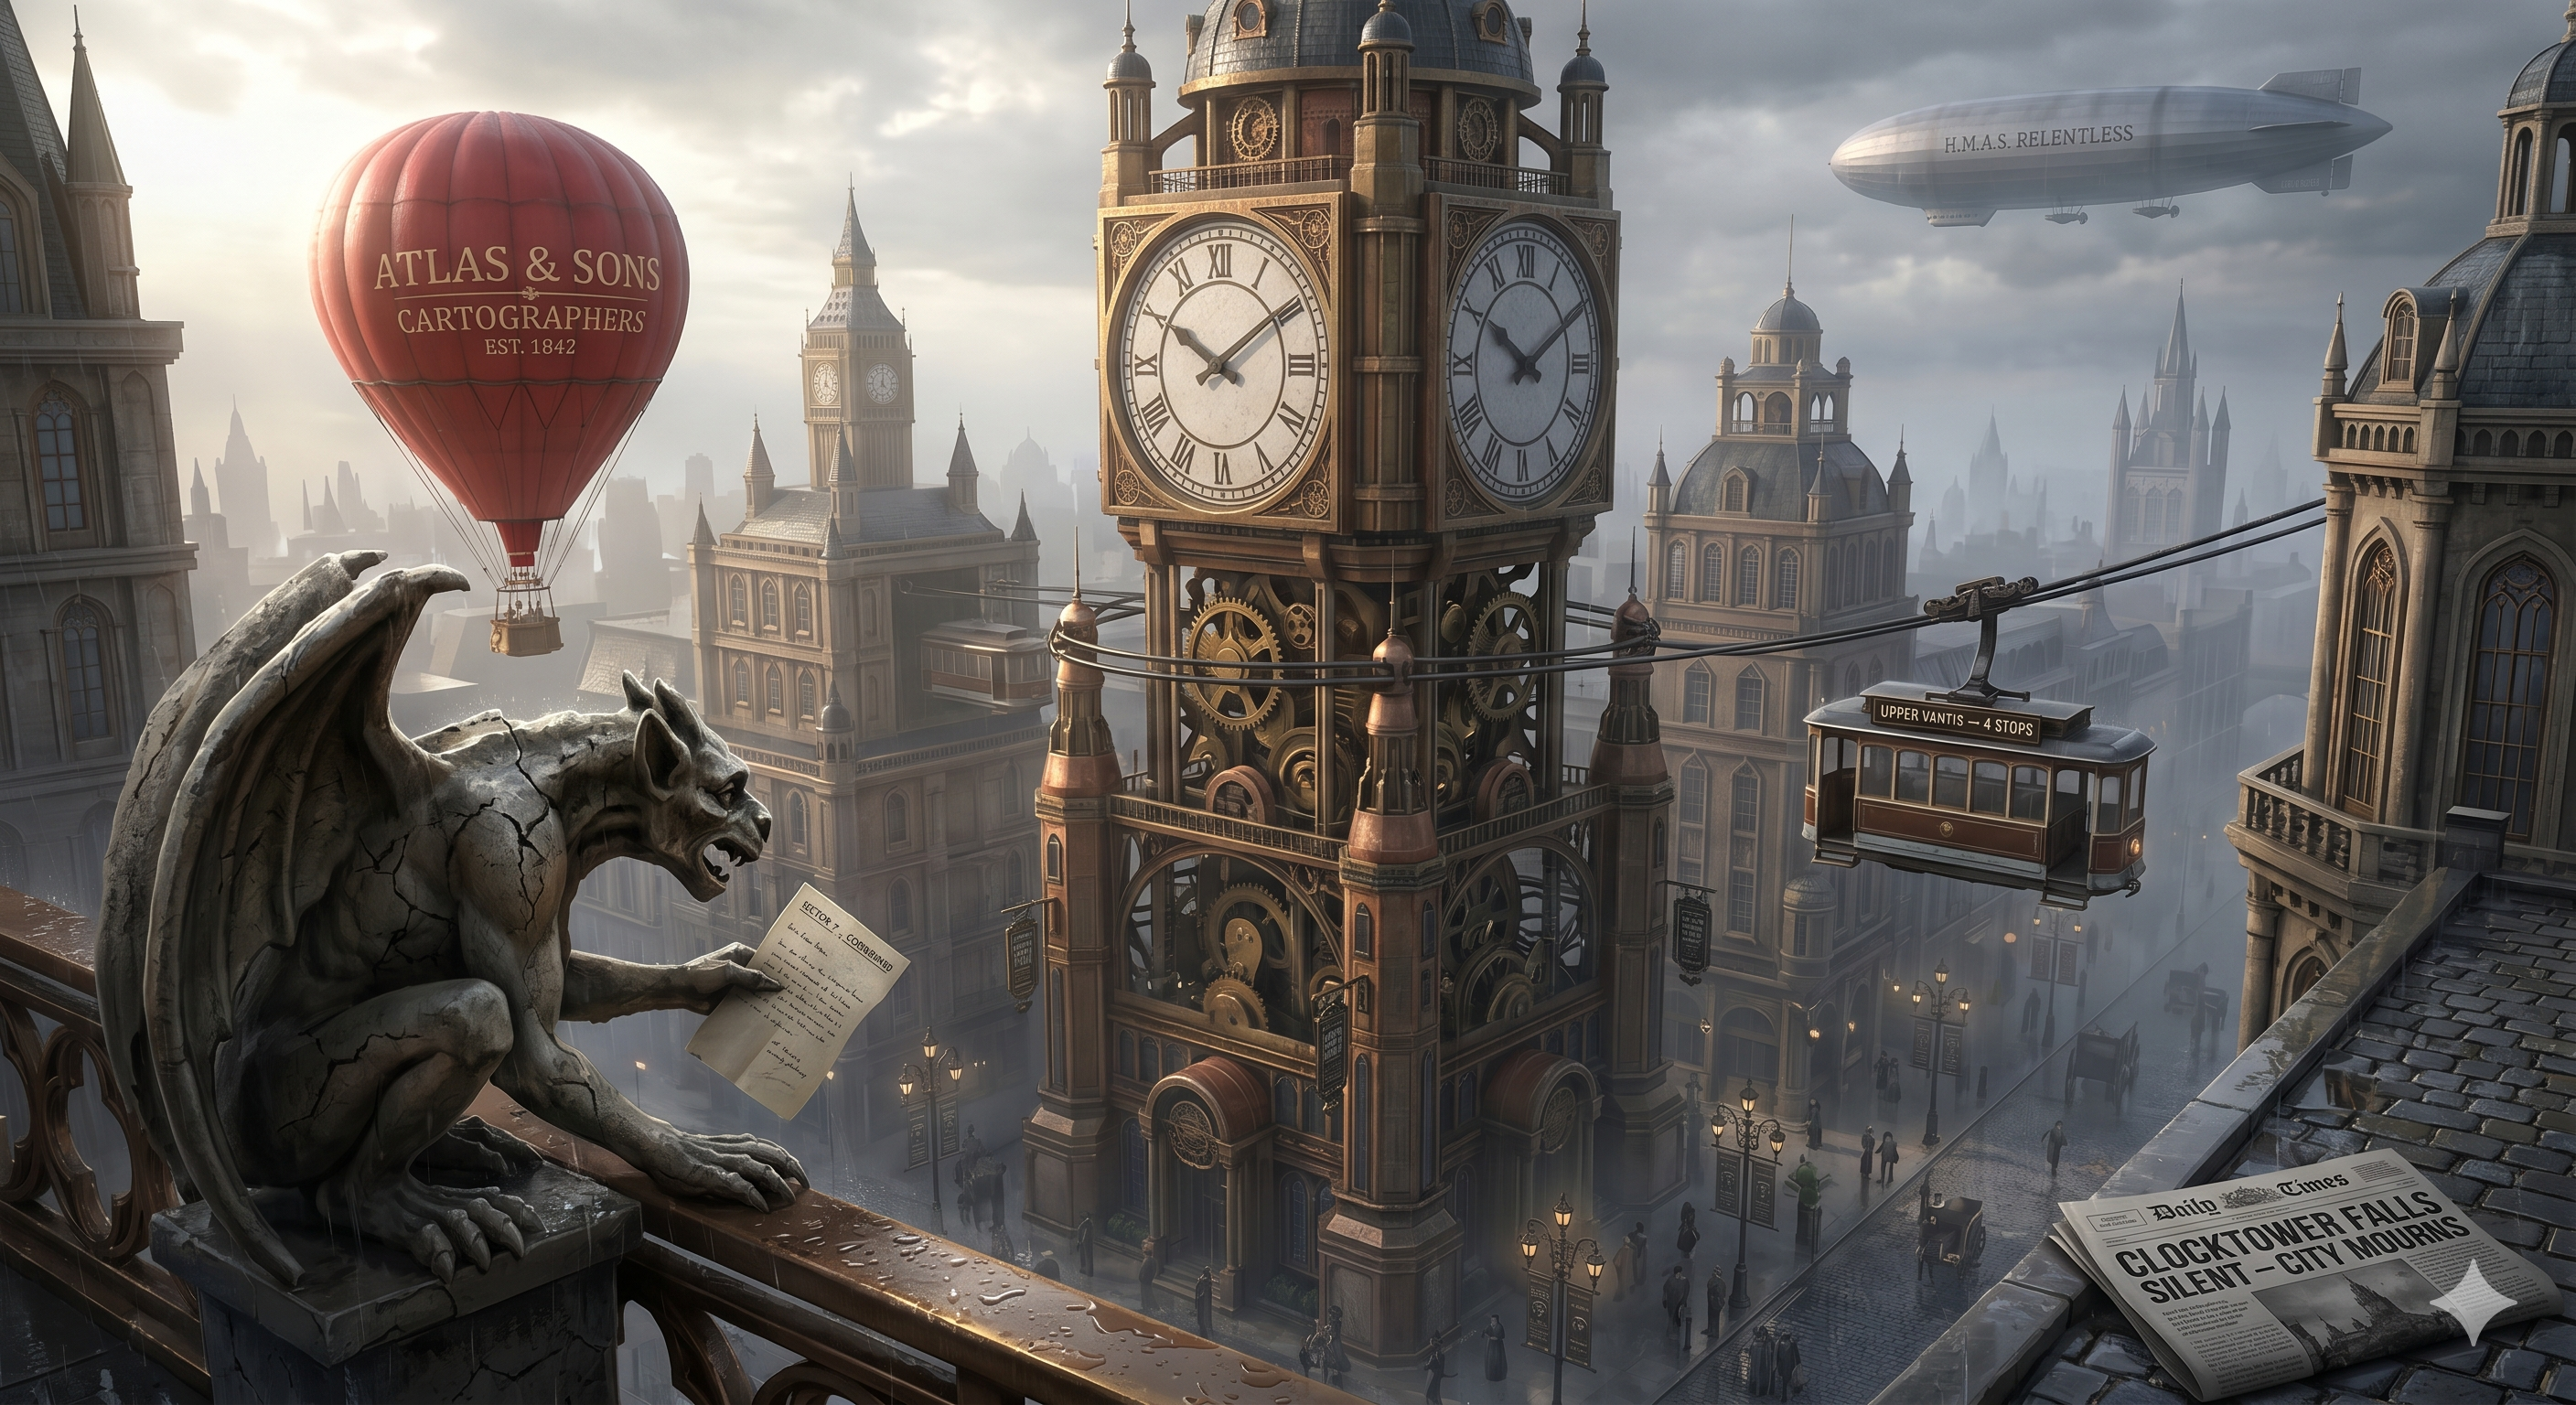
而在本轮测试中,Decrypt 没有再看到这两类问题。文章称,使用 Images 2.5 生成的所有图像,在高复杂度下都保持了色彩平衡和细节,没有再出现前两代中出现过的偏黄或过度锐化问题。评测认为,这是一次能直接看出来的修复,尤其在蒸汽朋克和人像测试里最明显;这两张图也被称为三代 ChatGPT 图像模型中,照片一致性最强的输出。
除了对比图中不容易直接体现的画质调整,OpenAI 还加入了几项与工作流相关的新功能,包括 Sketch,可在 ChatGPT 内直接绘制草图作为生成参考;提示词分享;针对图像特定区域的行内评论;以及海报和周边商品的格式模板。API 侧的质量档位也从低档扩展到了新的 high 和 max,高于 Images 2.0 原有上限。
文字密度测试:Kellerman's Hardware 街景
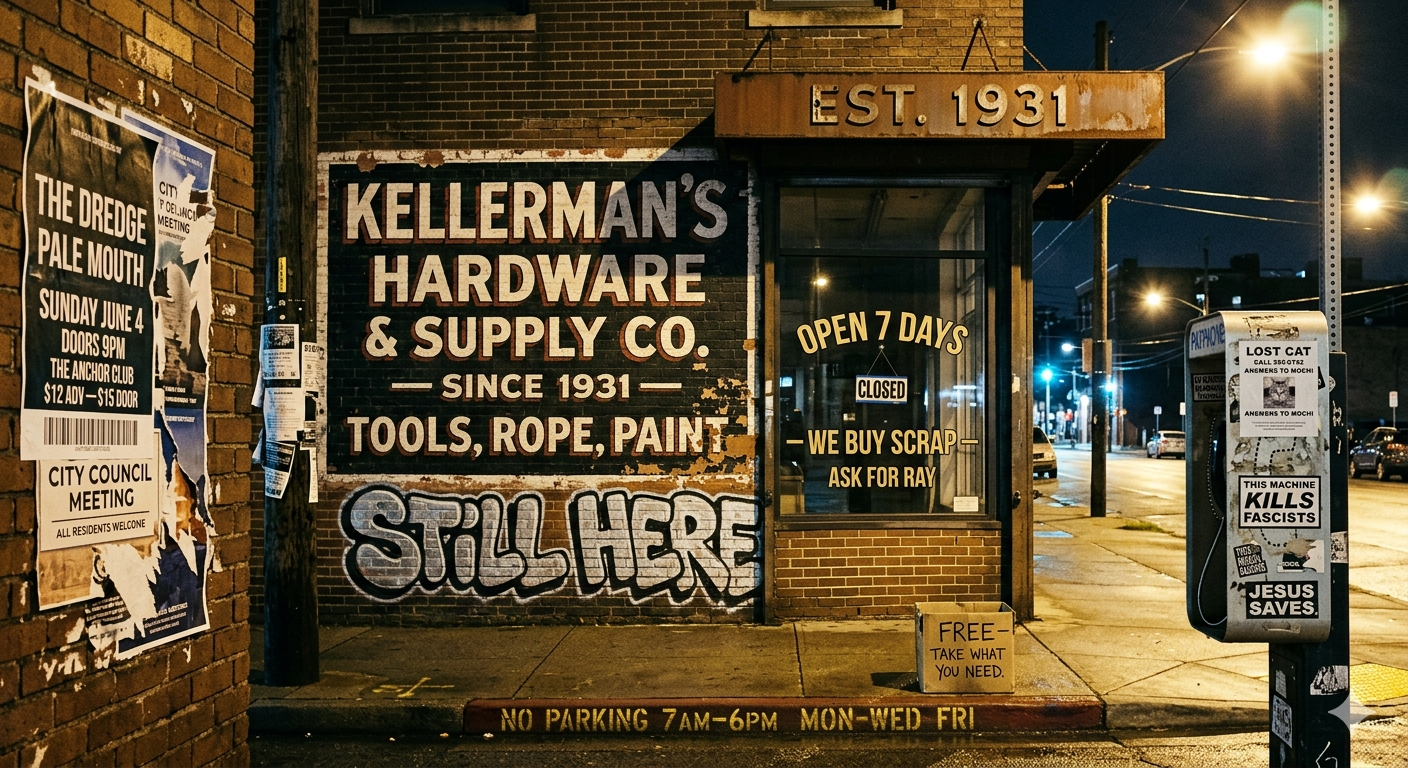
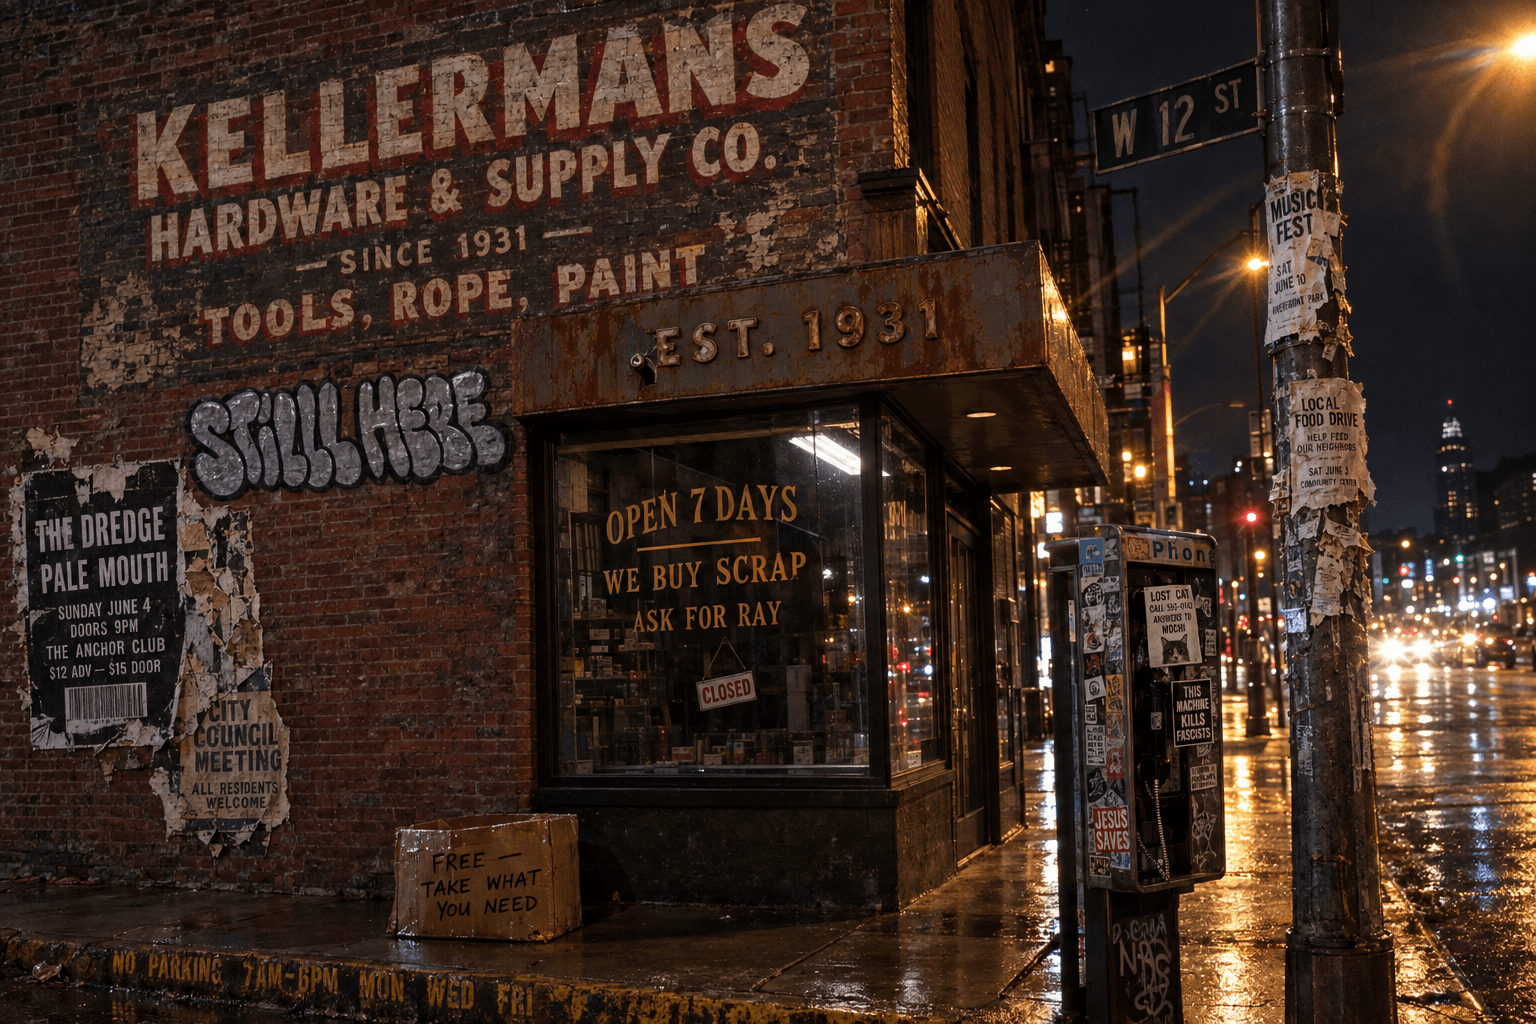
这一组被描述为高压测试:场景设定在凌晨 2 点的街头路口,几乎每个表面都有可读文字,包括幽灵招牌、喷漆涂鸦、橱窗贴字、破损演出海报、模板喷涂的路沿文字,以及贴满贴纸的公用电话亭。
Decrypt 认为,Nano Banana 2 几乎把所有文字都处理干净了。唯一的问题,是公用电话亭上的一张贴纸出现了自身文本重复且乱码的情况,但属于不太容易察觉的小瑕疵。
ChatGPT Images 2.5 则补上了 Nano Banana 2 完全略过的一处细节:提示词中提到的路灯杆,上面钉满了彼此重叠、已经破损并经风吹日晒的传单。只是它自己的街头艺术标签读起来像「STILLL HERE」,多了一个 L;而幽灵招牌里的「KELLERMAN'S」撇号也缺失或无法辨认。对于一款把精准文字渲染作为卖点的模型来说,同一张图里出现两处独立的可读性问题,被认为是明显失分。
从审美上看,Decrypt 认为 OpenAI 的图像更写实;但如果只看文字呈现,Nano Banana 2 处理得更仔细。这一项的胜者是 Nano Banana 2。
空间感知测试:蒸汽朋克钟楼
这是一组高难度航拍构图测试:画面需要有 5 个景深平面,中间是一座巨大的钟楼,钟面要用可辨认的罗马数字显示不同时间,前景到背景还分布着另外 6 个文字元素。
Decrypt 认为,ChatGPT Images 2.5 在氛围感上明显更强:屋顶上升腾的蒸汽清晰可见,中景有一条河流穿过,5 个景深层之间的色调变化也更丰富,这次生成中的文字同样更易读。
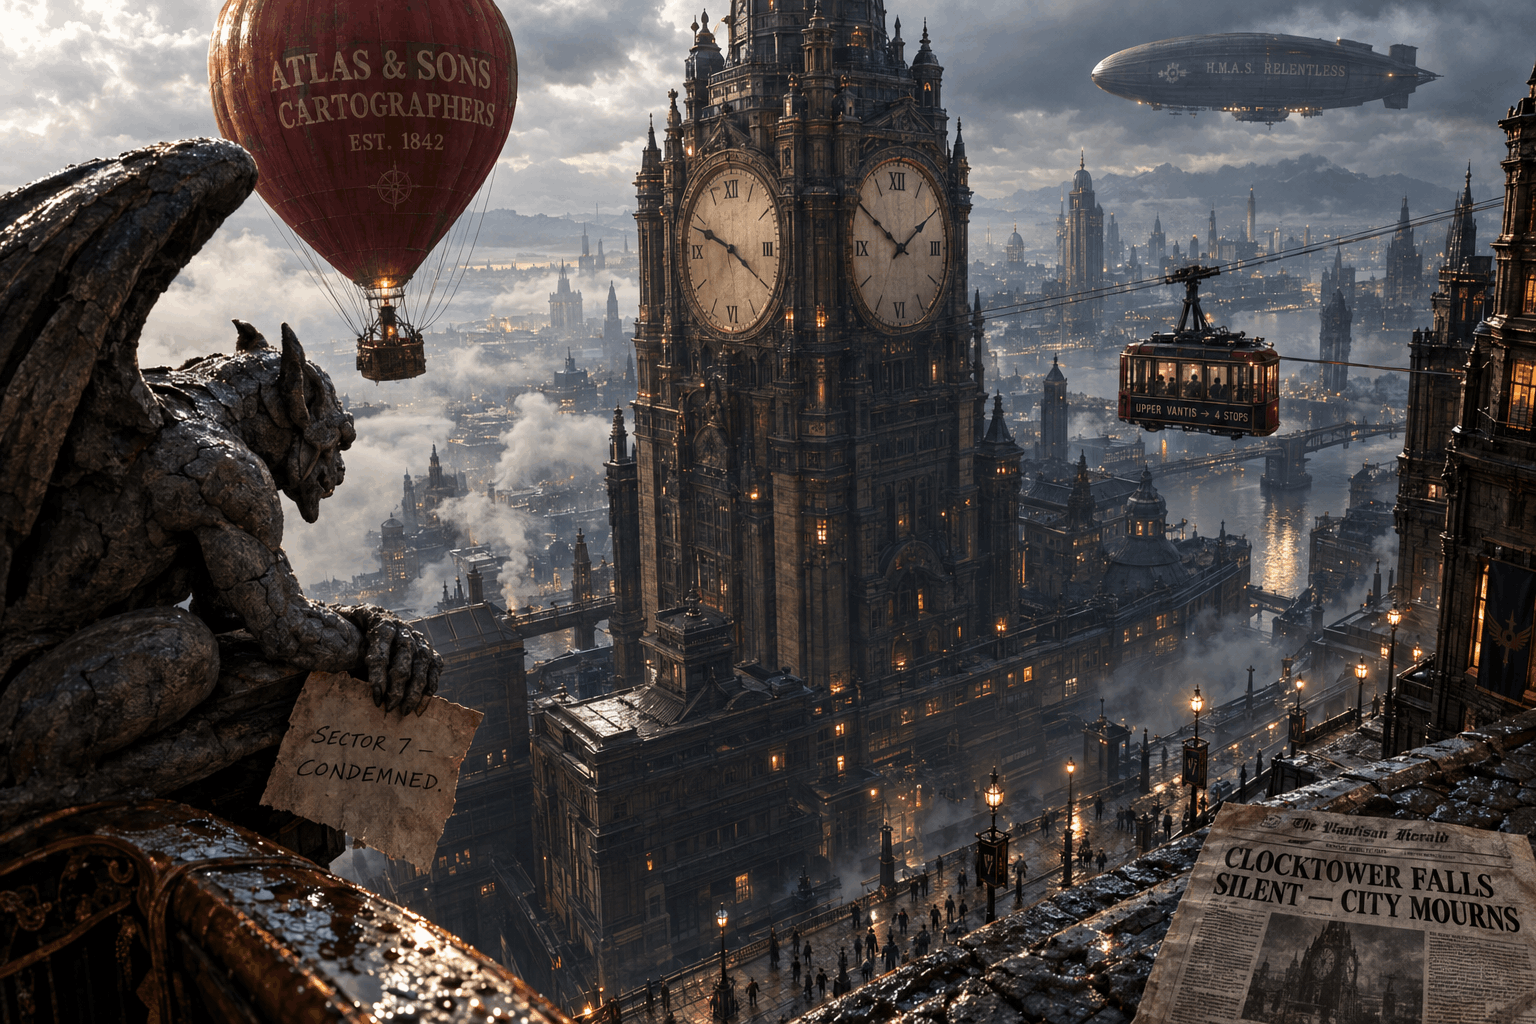
Nano Banana 2 的氛围相对平,但它可见的两个钟面都渲染出了清晰的罗马数字——XII、III、VI、IX——只是指针位置相似,并不符合提示词要求的不同时间。
这一项中,Decrypt 将胜者给到 GPT Images 2.5,理由是它在不牺牲真实感的情况下,更好地遵循了提示要求。
插画测试:动漫灵媒
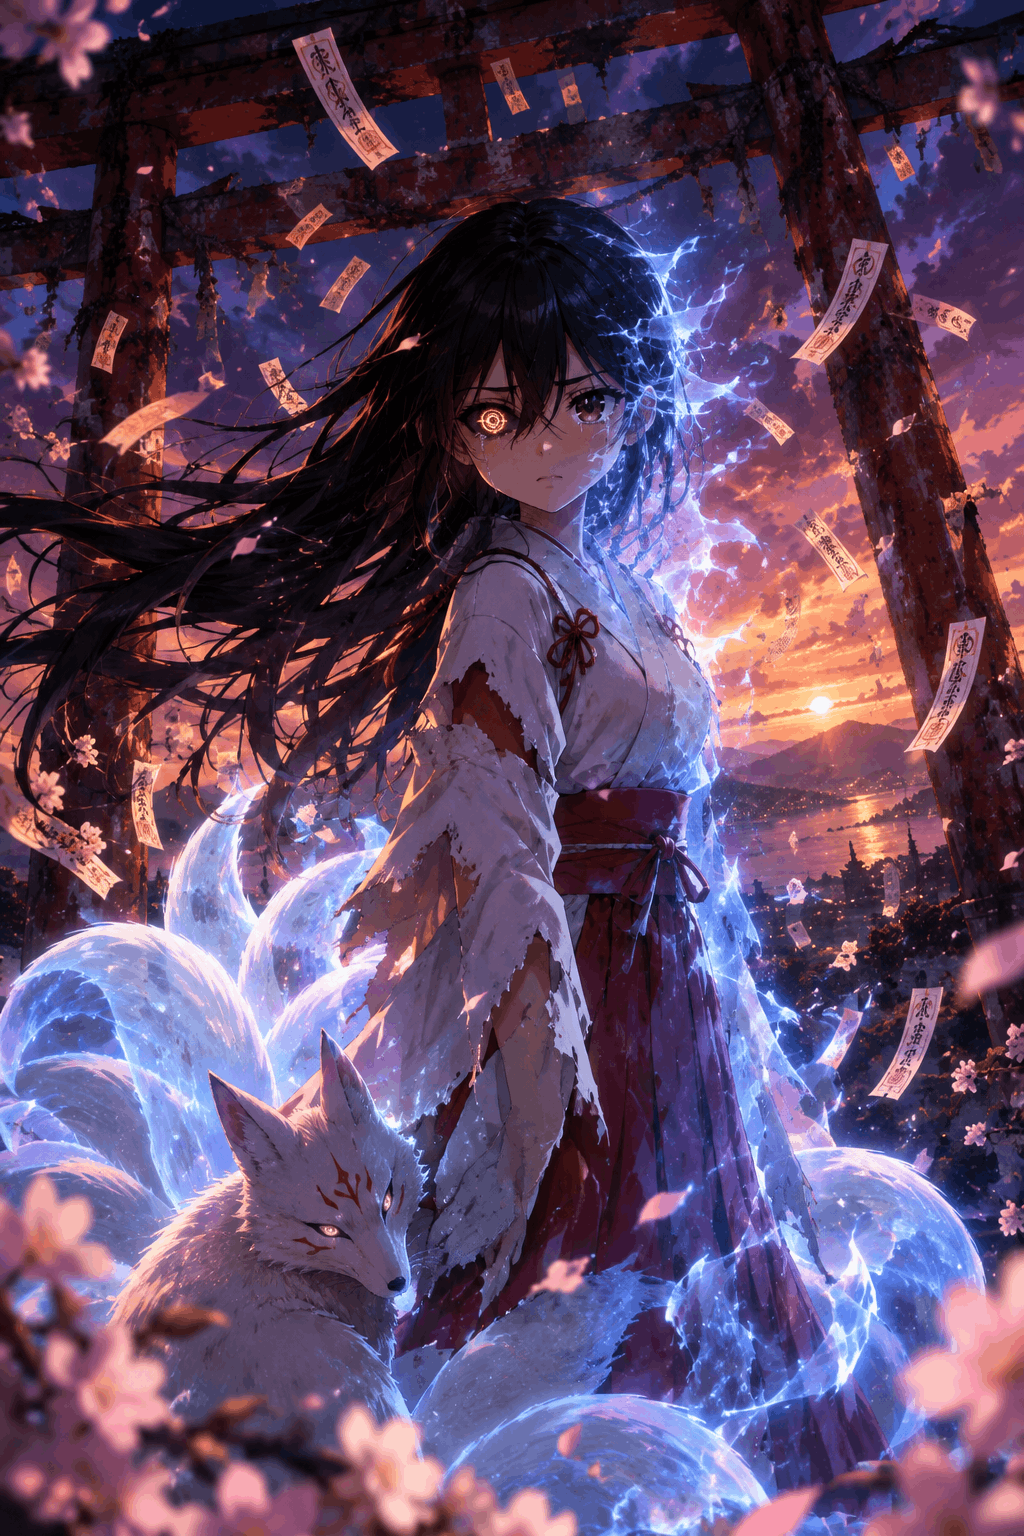
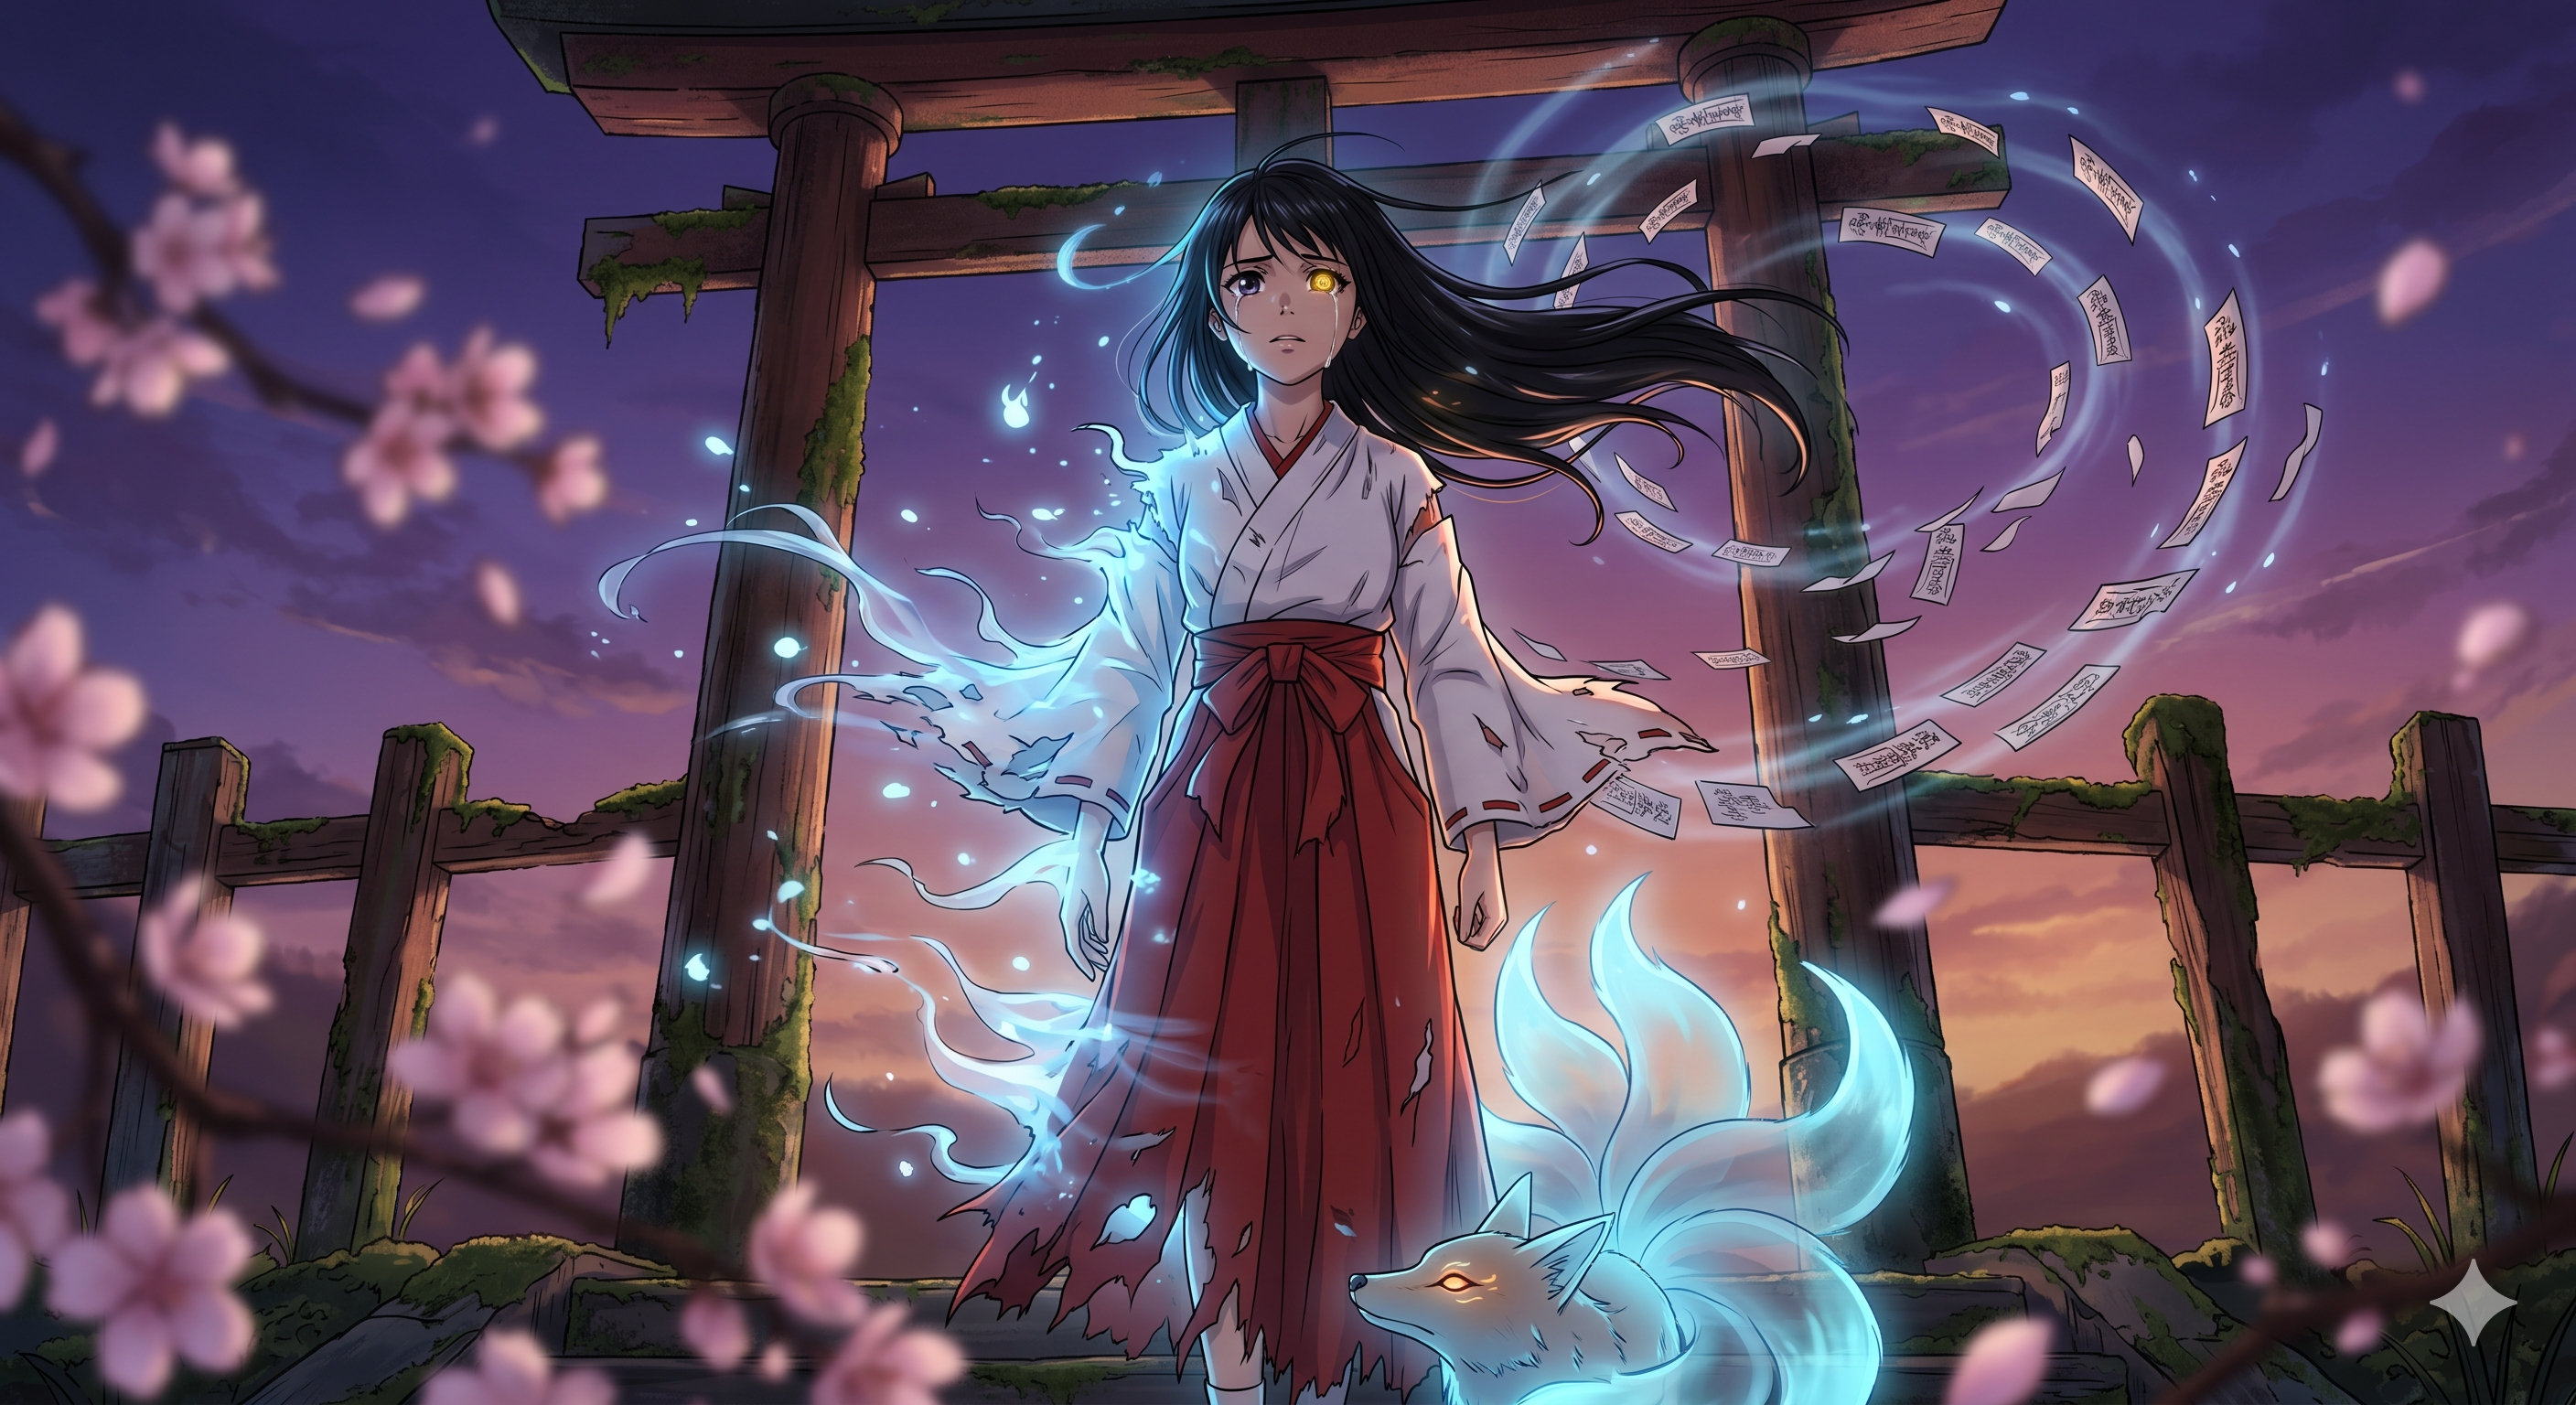
这个提示词要求生成一张带有 ufotable 风格主视觉效果的插画:一名女孩站在鸟居前,正转化为灵性能量,身旁有一只九尾狐,天空则是新海诚式的暮色绘景。
Decrypt 认为,ChatGPT Images 2.5 交出了整个系列测试里最好的天空:画面里有真实的太阳圆盘、水面反射和山体剪影,足以支撑对「新海诚感」的描述。人物双眼的不对称设计也处理得不错。不过模型没有严格照着「溶解为能量」来表现,而是把这一描述改写成头发间穿过的电流裂纹效果,而不是提示词里那种流动、半透明的消散感。
Nano Banana 2 的蓝白色轻烟状能量轨迹,更贴近这句要求的字面意思。但两款模型都没能画出令人信服的九尾狐。
综合视觉冲击力后,Decrypt 把这一项判给了 ChatGPT Images 2.5,尽管它在具体指令理解上存在一定偏移。
写实测试:屋顶建筑师
这组是电影感人像,包含一长串彼此独立的约束:米色风衣、圆框眼镜、蓝图必须拿在左手、黄金时刻光线、浅景深、胶片颗粒。
Decrypt 认为,ChatGPT Images 2.5 的光线表现非常出色,太阳圆盘直接出现在人物身后,皮肤微观纹理也很好。虽然皮肤还是偏平滑,但整体场景非常写实,像是模拟相机拍摄的照片。
文章还提到,一个有意思的现象是,加入一些通常会让照片显得「质量变差」的命令,反而会提高真实感。举例来说,在提示词里加入「realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera」等关键词后,得到的生成图更像真实拍摄。
Nano Banana 2 保留了更完整的构图,但人物把蓝图拿在右手而不是左手;同时它还生成了一个多数结果都会省略的、可读的蓝图标签:「PROJECT: 124 DUANE ST」。
这一项中,Decrypt 给出的结论是:单次输出看,Nano Banana 2 获胜;如果看反复迭代,GPT 更强。
研究能力测试:比特币时间线
两个平台都支持在出图前先做研究,因此 Decrypt 要求它们生成一张儿童绘画风格的宽屏比特币历史时间线信息图,并对事实准确性设下严格门槛。文章称,这是整轮比较里最重要的项目,也是差距最大的地方。
ChatGPT Images 2.5 生成了一张整洁的双行信息图,里面列出了多个具体日期,但其中有一个年份是错的:它把 2023 标成美国比特币 ETF 获批的年份。美国证券交易委员会实际上是在 2024 年 1 月 10 日批准首批现货比特币 ETF,整整晚了一年。文章也补充称,2023 年获批的是比特币期货 ETF,因此这也可能是一个解释层面的问题。
Nano Banana 2 的输出结构性较弱,但展示了相近事件。Decrypt 认为,这也说明该模型在重复提示下的变化不大。不过它把 ETF 批准和第四次减半写成「2023–2024」区间,而不是直接给出一个错误年份,因此至少没有技术性错误。
由于这个类别考察的正是「代理式推理」能否给出准确信息,Decrypt 将胜者判给了 Nano Banana 2,并强调一个自信却错误的日期比别的问题更严重。
抽象概念测试:由虚构词构成的提示词
这一项几乎完全由没有实际含义的词组成:「A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.」菜名、地点、同伴以及活动都没有词典定义,两款模型都必须先自行发明这些东西,再决定如何呈现。
ChatGPT Images 2.5 的解法,是直接把这些无意义词写进画面文字里。「Lyxin」出现在一家流线型未来主义餐厅上方的霓虹招牌中;「Lakishkark」则被印在女人身边那位外星同桌正在玩的桌游盒子上。原本抽象的虚构词,在它们变成可读招牌后,立刻获得了具体指向。
Nano Banana 2 走的是相反路线。它构建了一幅带有明确文化氛围的温暖场景:危地马拉市场摊位、穿传统 huipil 的女性、一个类似兽人的生物演奏着弦乐器和管乐器混合体。它把「plays」理解为演奏音乐,而不是玩游戏,这同样成立。但画面里没有任何元素能对应「Lyxin」或「Lakishkark」,这些虚构词从头到尾都没有以可见文字出现。
这一项里,Decrypt 将胜者给到 ChatGPT Images 2.5,理由是当提示词本身不给出其他线索时,把未定义概念转成清晰可读的标签,是更字面的回答。
最终结论
Decrypt 统计称,Nano Banana 2 在这一轮 6 个项目里拿下 3 项,整体基本可以算打平。文章认为,实际选择会更多取决于用户期待什么,以及与模型互动的方式。
就这次测试看,ChatGPT Images 2.5 的确修掉了前代长期存在的过度锐化问题;而在插画项目里,它生成的画面也可能是两轮完整测试中,双方产出过的单张视觉效果最强作品之一。
Decrypt 认为,两者真正拉开差距的,不是整体画质,而是一些很小但可核验的失误,比如文字密集场景里的拼写错误,或研究型信息图中的错误年份。若只看总体审美和成品质量,两款模型大致处在同一水平。