
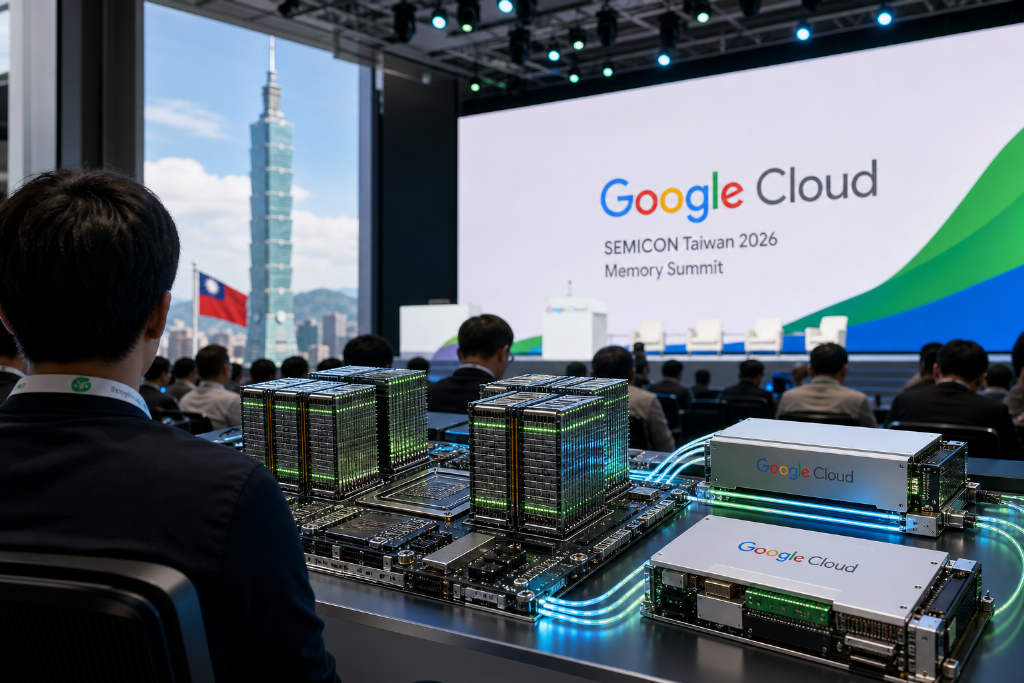
ChainCatcher消息,SEMICON Taiwan 2026存储器高峰论坛于9月1日登场。Alphabet旗下谷歌云(Google Cloud)供应链基础架构高级总监Nikhil Cherian指出,随着多模态与混合专家架构普及,AI运算已从算力受限转向内存受限,高性能内存已占AI服务器硬件物料清单成本的75%以上。
面对容量、带宽与功耗瓶颈,谷歌通过推理与训练硬件分流、无损量化软件算法等软硬件双轨策略,突破AI内存瓶颈。
硬件分流:TPU 8i与TPU 8t
谷歌在硬件架构上采取分流策略,推出针对低延迟推理的TPU 8i以及专攻超大规模训练的TPU 8t。TPU 8i配备288GB高带宽内存,芯片上SRAM容量扩增3倍至384MiB,将动态对话状态与键值缓存置于芯片内部,实现零片外延迟。TPU 8t通过9600颗芯片组成超大型计算集群,HBM共享池化达到2PB规模,消除芯片外数据传输瓶颈,并搭配TPU Direct Storage技术。
TurboQuant:3位无损量化
谷歌开发出免训练的TurboQuant无损量化算法,将大模型的键值缓存从32位压缩至3位,在精确度零损失的前提下将内存占用缩小6倍,带来8倍注意力运算加速。该算法还导入旧世代DRAM整合技术,延长零部件生命周期。
本文最初由 Bit.Fan 发布。 欲了解更多加密货币新闻与市场洞察,请访问 www.bit.fan.