
何恺明团队在 arXiv 发布的 VISTA 论文,最近在 X 上引发广泛讨论。论文围绕 ARC-AGI-3 这一测试提出一个直接判断:过去半年里,顶尖大模型并不是推理能力不够,而是在进入考场时被限制了视觉输入和记忆方式。
论文给出的结果很醒目。Claude Opus 5 在 VISTA 系统下,完成 ARC-AGI-3 的 25 个公开游戏,183 关全部通关,每个游戏都是 100 分,总分满分;GPT-5.6 Sol 也完成全部通关,拿到 99 分。论文还称,Claude 总共走了 7302 步,只有首次游玩人类的 0.43 倍。
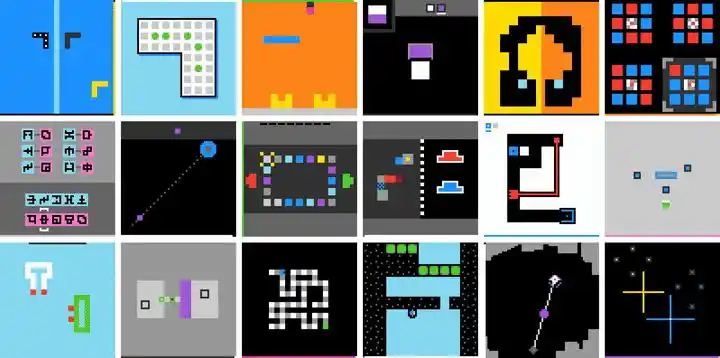
ARC-AGI-3 由 Keras 之父 François Chollet 和 ARC Prize 基金会在今年 3 月推出,题目是一组交互式像素小游戏。游戏开局没有说明,也没有规则提示,参与者只能靠观察和试错摸清玩法。
这套测试的评分方式也很严格。论文提到,官方找来近 500 名首次接触的人类参与者做实测,AI 不仅要通关,步数还不能高于人类,才能拿到满分。
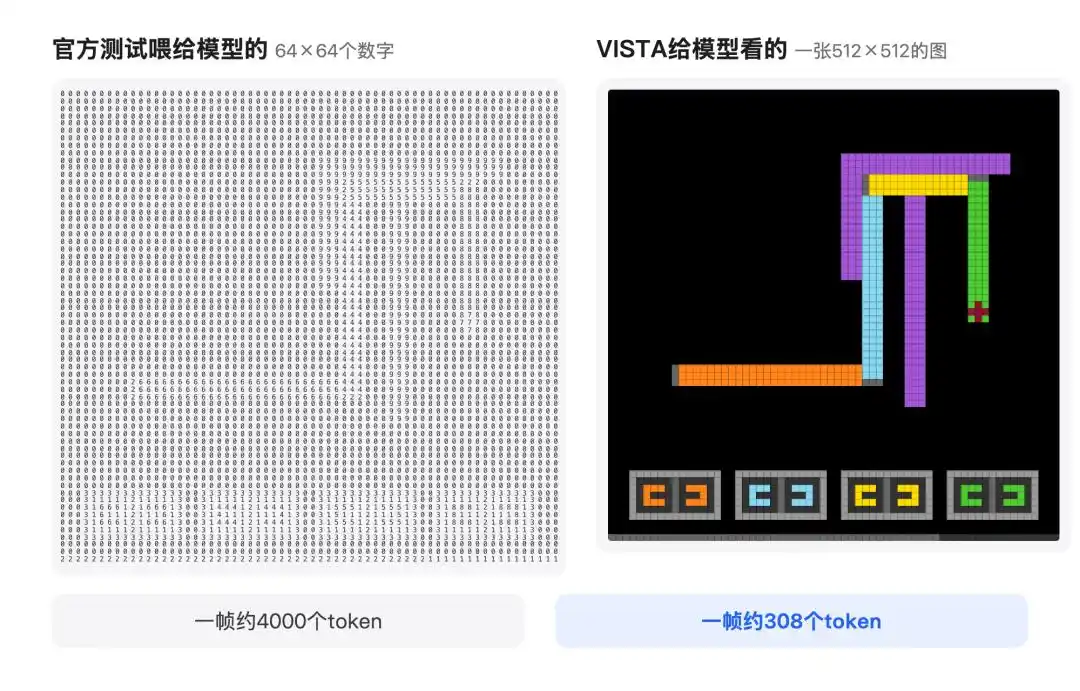
问题在于,官方给大模型的输入并不是人类看到的游戏画面,而是一张 64×64 的数字表。对人类来说,画面里有角色、机关和路线;对模型来说,则只剩下 4096 个数字。论文把这种差异形容为让人闭着眼,只靠别人报坐标去玩游戏。
先把数字表换回图像
VISTA 做的第一步很简单:把数字表换成图片,其他设置不变。
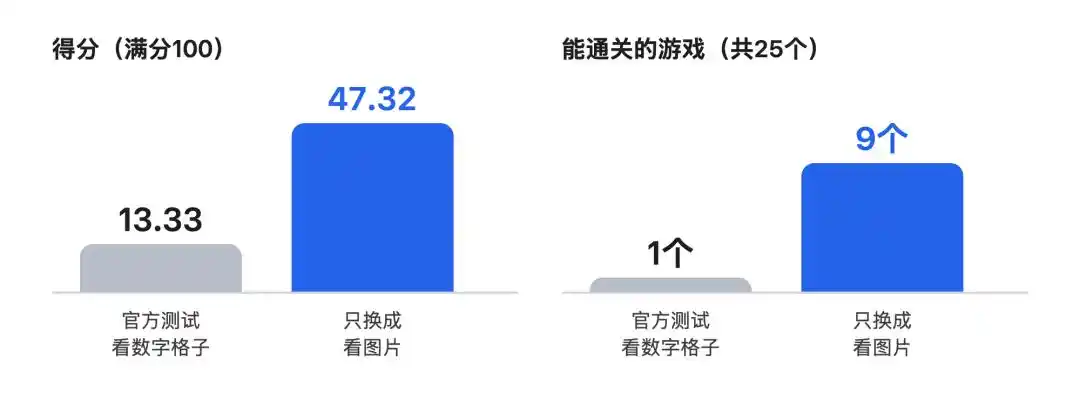
论文称,只做这一项调整,GPT-5.6 Sol 的分数就从 13.33 分升到 47.32 分。与此同时,图像输入的 Token 开销反而更低:一个数字格子约消耗 4000 个 Token,而一张 512×512 图片只需要 308 个。
按论文数据,一局游戏跑下来,文本版总共消耗 7190 万 Token,图片版为 3070 万,分数却更高。仅仅把输入从数字表改成图像,大模型就多拿了约 34 分。
论文还给出另一组对比:只把数字换成图片后,GPT-5.6 Sol 的成绩涨了三倍多,能通关的游戏数量从 1 个增加到 9 个。
再给模型一本可回看的“相册”
论文认为,能看见还不够。ARC-AGI-3 一局游戏往往有几百步,多模态模型常见的问题是图像只看一遍,等上下文变满后,旧画面会被删除,或者被压缩成几句文字摘要。模型如果想回头核对细节,原始画面已经不在上下文里。
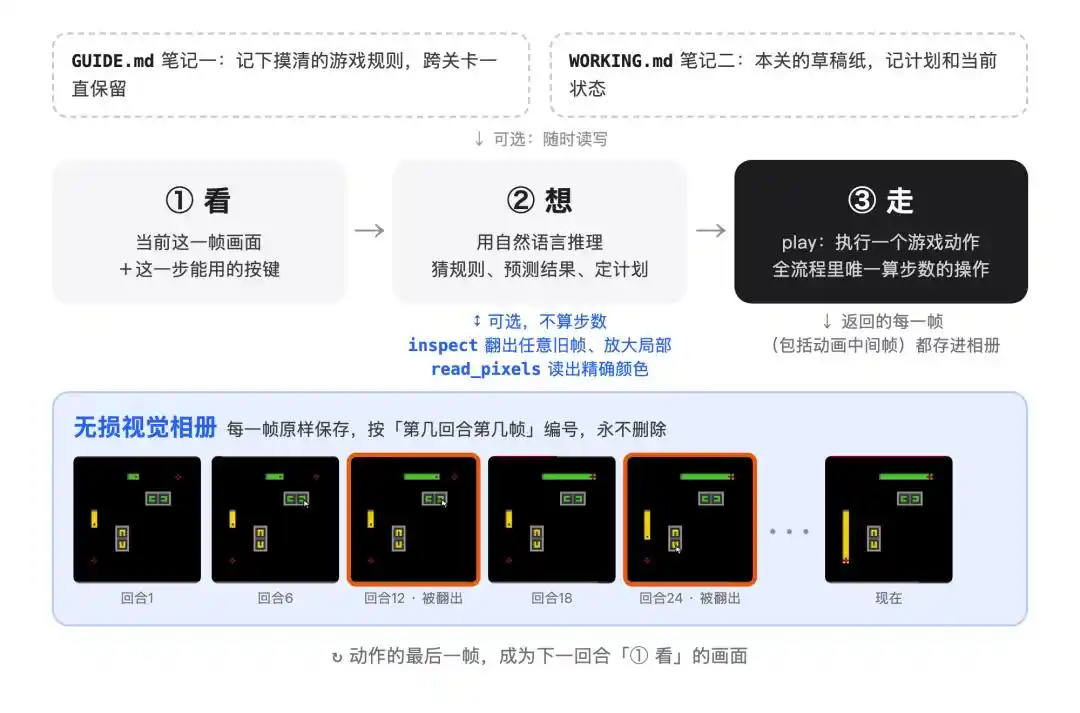
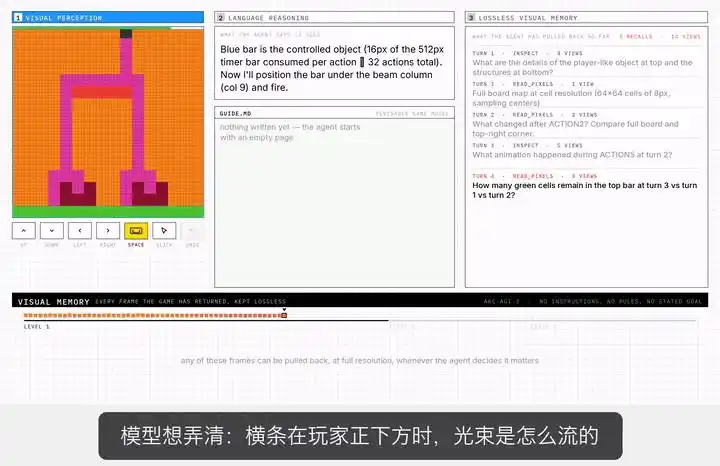
VISTA 的核心机制,是一套无损视觉记忆系统。游戏过程中产生的每一帧画面,包括动画帧,都会按编号原样保存。模型需要时,可以通过 inspect 调出任意帧,做并排比较、局部放大,也可以用 read_pixels 读取精确颜色。
论文特别强调,翻看这些存档画面不计入步数,只有真正对游戏做操作时才计步。团队把这套机制称为“显式注意力”,也就是由模型自己决定回看哪一帧、查看哪一块区域。
除视觉记忆外,VISTA 还给模型配了两个文本文件:GUIDE.md 用来记录游戏规则,WORKING.md 作为草稿纸。一个完整回合里,模型先看画面、推断规则,需要时翻相册,最后才执行一步操作。
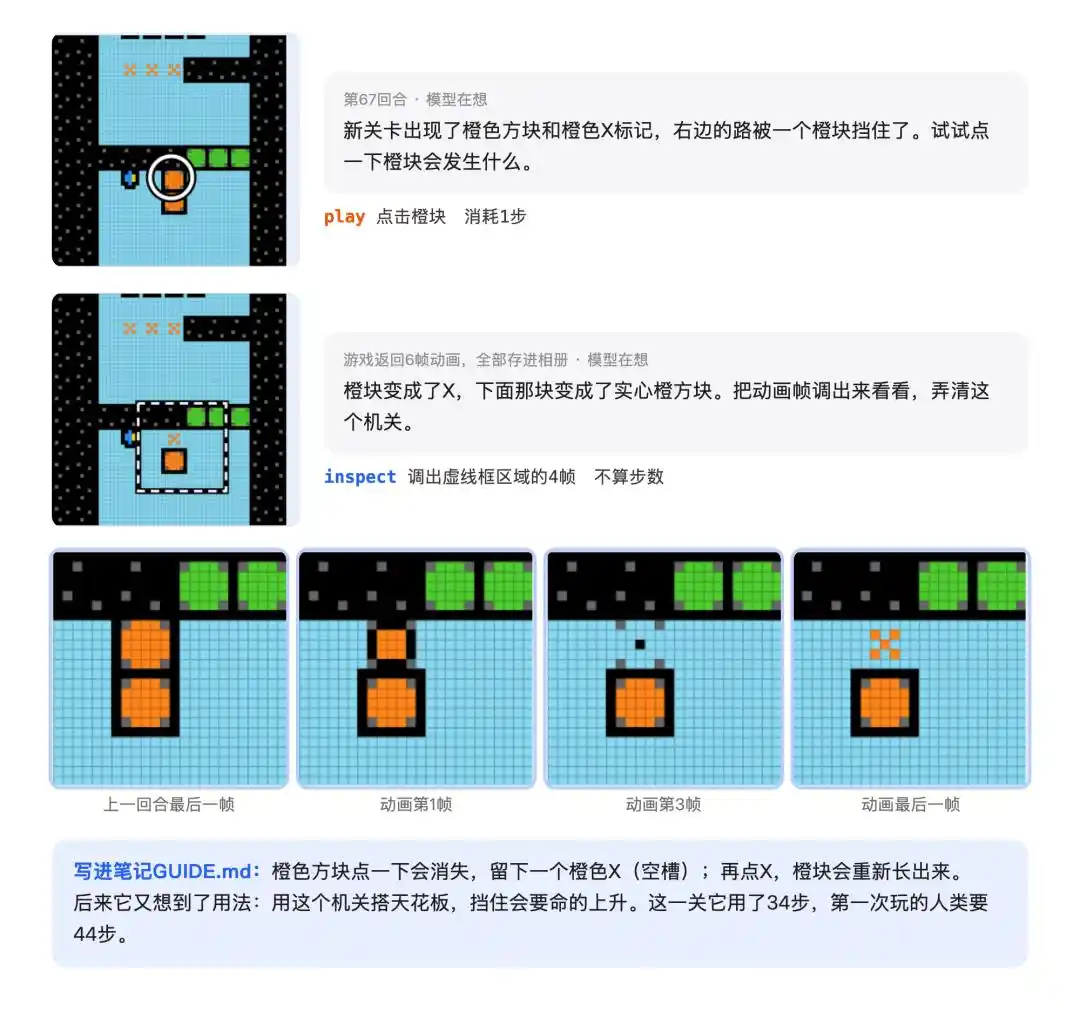
论文记录了一个具体案例。在 BP35 游戏第 3 关,画面里出现一个橙色方块,模型点击后,橙块变成了 X。它没有立刻继续,而是调出上一回合最后一帧和刚刚出现的三帧动画,放在一起比较。
几回合后,模型又发现点击 X 可以让橙块重新出现,并在笔记里写下:「这就是我要的工具,用它搭天花板,挡住会要命的上升。」这一关里,首次游玩的人类平均需要 44 步,模型用了 34 步。
在《吃豆人》任务中,迷宫里的豆子吃掉后不会恢复。论文称,模型在第 13 回合和第 36 回合,两次主动回看开局第一帧,用来重新确认迷宫地图并规划路线。
上下文更长、图片更大,成绩反而下降
论文还测试了两种常见思路:增加上下文长度,以及提高图像分辨率。结果都没有带来更好成绩。
在上下文实验中,默认 200K 上下文被拉高到 780K 后,每局游戏的 Token 消耗从 3070 万升到 1.057 亿,但成绩从 99 分降到 93.9 分。
图像尺寸实验也类似。图像放大到 16 倍后,每帧 Token 增加到 1229 个,成绩降到 88.3 分;只放大 4 倍时,成绩为 99.7 分,反而高于默认的 8 倍设置。
论文给出的解释是,图像过大带来的额外 Token 会占用上下文空间,但模型并没有因此看得更清楚。团队在博客中表示,VISTA 的设计刻意追求极简。
系统中没有新训练的模型,每个游戏使用的提示词也完全相同,总共只有四句话,没有一句在教模型具体怎么玩。
不靠写程序,也能把分数拉到满分附近
过去一个夏天,ARC-AGI-3 的高分方案多走“代码路线”。文中提到的 Tycho 和 Schema,都是让大模型针对每个游戏写出可运行程序,再构造模拟器反复试错。
以跳棋游戏 LF52 为例,Schema 仅这一项就写了约 4000 行 Python。相比之下,VISTA 中的模型只是在笔记里用自然语言写下三句话,就完成了同样的规则归纳。
按论文说法,VISTA 是第一个不依赖写程序,就在 ARC-AGI-3 上做到满分或接近满分的系统。论文认为,这一点在游戏之外更重要,因为真实世界里并不会有人提前写好一套 4000 行模拟器供模型调用。
成绩方面,Claude Opus 5 打通了 25 个游戏的全部 183 关,每个游戏都是 100 分;GPT-5.6 Sol 同样全部通关,拿到 99 分。论文还举了 m0r0 这个游戏的例子:人类需要 1107 步,Claude 只用了 219 步。文中称,这两份成绩在 ARC Prize 官方平台上都有记分卡。
从 3D 画面到网页游戏,VISTA 也做了扩展测试
论文称,这套 0 训练、偏机械化的 harness 具有较强泛用性。
在带透视的 3D 画面任务中,VISTA 拿到 84.12 分。把 GPT-5.6 Sol 接入 34 个网页游戏后,任务成功率为 63.3%,覆盖《马里奥》、2048、《我的世界》等任务,成绩高于首次接触的人类参与者的 55.3%。
在静态视觉题上,VISTA 也有应用。论文举例称,在 BabyVision 的一道连线题中,不使用 VISTA 时,模型把驼鹿和兔子连错;加入 VISTA 的放大查看能力后,模型答对了题目。
论文还提到,一个在官方实现下几乎交白卷、只拿到 1.89 分的 320B 开源模型,接入 VISTA 后成绩升到 66.93 分,提升约 35 倍。
何恺明团队连续三篇论文押注“ARC 是视觉问题”
论文把 VISTA 放在何恺明团队过去一年的研究脉络中来看。当前 ARC 测试的主流解法,长期由大语言模型主导,重点放在文本推理上;而何恺明团队连续三篇论文都在强调同一个方向:ARC 首先是视觉问题。
第一篇 VARC 使用 1800 万参数的小型视觉模型,从零训练后,仅凭图像输入就追平了人类平均分。第二篇 NAT-ARC 让模型先在 ImageNet 上做视觉预训练,再观察其抽象推理能力变化。第三篇就是这次的 VISTA,不再训练小模型,而是直接给前沿大模型补上视觉输入和可回看的记忆机制。
文中提到,串起这三篇论文的是何恺明的博士生胡珂雅。她本科毕业于上海交大 ACM 班,在三篇论文中分别担任两篇第一作者、一篇第二作者。VISTA 的另外两位共同第一作者是 MIT 博士生 Qiushi Han 和 Linlu Qiu,MIT 副教授 Cathy Wu 也在作者名单中。
论文最后把问题指向更真实的环境。过去几年,行业主流路线是持续扩大模型规模、延长推理链,把智能提升主要押在模型本身。VISTA 展示的则是另一种路径:同一个 Claude,从 40 分到满分,变化来自模型外部的一双“眼睛”和一本“相册”。
ARC Prize 联合创始人 Mike Knoop 也在文中被引用称,越来越多的“学习”会发生在模型权重之外。按这篇论文的判断,下一步竞争点,是谁能让模型更清楚地看见世界,并把看到的内容保留下来。何恺明团队接下来瞄准的,是充满真实画面的具身环境,因为在那里,没有人会预先把世界翻译成一张数字表。