
最近,AI 开发者社区里频繁出现一个新名字:Jev。
过去几天,Jev 在 X、GitHub 和 Agent 开发者社区迅速传播。公开案例显示,有人用它在 40 秒内分析 724 条实时广告,有人把它接入 Claude Code 清理上下文,也有人把它用于 AI Agent 的任务验收,或接入浏览器 Agent,让系统决定下一步该点击哪个按钮、进入哪个页面。
9 月 20 日,LangChain 也发布了一项 Jev-as-a-Judge 实验,测试 Jev 作为 Agent 评估器的表现。连 OpenAI「重置之神」Tibo 也参与了对 Jev 的宣传。
Jev 是什么
TypeSafe AI 于 9 月 15 日正式发布 Jev,并把这类模型称为「System One Models」。按照 TypeSafe 的定义,这类模型接收一段程序状态或文本信息,然后快速返回结构化判断结果以及对应概率。
简单看,Jev 是一种专门处理「判断题」的 AI。它更适合回答这类问题:是不是销售线索、是否需要人工介入、属于哪一类问题、结果质量处于哪个等级。
Jev 刚发布时就已受到关注。几天后,相关讨论热度继续上升,相关推文累计已有 3700 万人围观。
以客服邮件为例,开发者可以让 Jev 同时判断「这是销售线索吗?」「用户情绪是否激烈?」「是否需要人工介入?」「属于账单、技术还是销售问题?」Jev 返回的会是一组概率结果,例如销售线索 0.91、需要人工介入 0.12、技术问题 0.83,应用程序可以据此直接进入下一步流程。
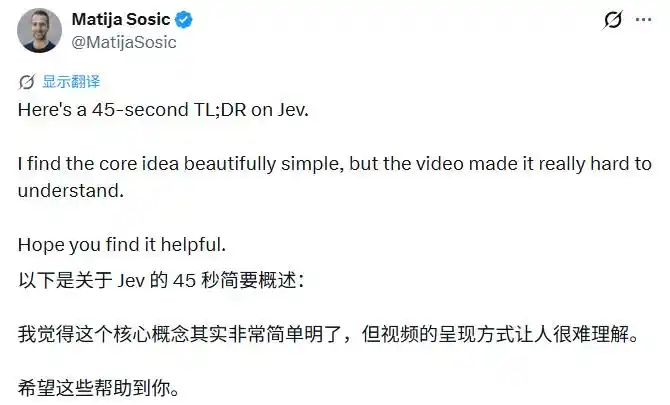
Wasp 联合创始人兼 CEO Matija Sosic 也在 X 上发布了一段 45 秒的视频,对 Jev 进行解读。
三类核心判断形式
目前,Jev 提供三类核心判断形式:Noul、Choice 和 Score。
- Noul:负责 Yes/No 类型判断;
- Choice:从给定选项中选择答案;
- Score:根据预设标准进行评分。
每个结果都会附带概率或置信度,多道问题也可以围绕同一份输入同时完成判断。
为什么 Agent 开发者开始集中使用 Jev
Jev 很快找到的一个高增长场景,是给 Agent 当「裁判」。
当前的 AI Agent 往往需要连续完成几十甚至几百个步骤。写代码、调用工具、搜索网页、修改文件之后,系统还要继续判断任务是否已经完成。这类问题与 Jev 的工作方式高度贴合。
开发者可以把 Agent 的执行记录交给 Jev,再让它判断「目标是否完成?」「结果是否符合要求?」「是否存在遗漏?」「当前结果质量属于哪个等级?」
LangChain 最新公布的实验采用了类似思路。该实验让 Jev、GPT-5.6 Luna、GPT-5.6 Terra 和 Claude Sonnet 4.6 对固定的 Agent 输出反复评分。在这组规模较小的测试中,Jev 平均每次调用耗时约 0.44 秒,成本约 0.00035 美元,同时在连续评分的一致性上表现突出。
LangChain 也强调,这仍是早期、小规模测试,后续还需要在更多 Agent 和真实生产任务中继续验证。
广告分析案例推动 Jev 进一步出圈
Jev 在广告分析上的一组数据,也让它在开发者圈外获得更多关注。
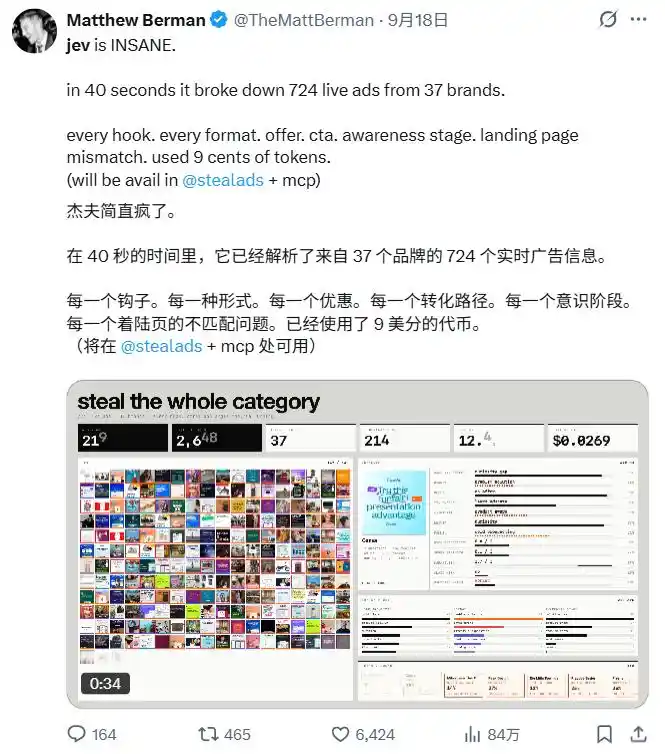
开发者 Matthew Berman 分享的一次实验显示,系统使用 Jev 分析了来自 37 个品牌的 724 条实时广告,对广告的 Hook、形式、Offer、CTA、用户认知阶段以及广告与落地页的一致性进行分类,总共产生 8724 次判断。
根据开发者公布的数据,这批任务大约在 40 秒内完成,Token 成本约 9 美分,每条广告的中位处理时间约 216 毫秒。相关案例已经被收录进 Jev 社区案例库。
Claude Code 和浏览器 Agent 也在测试 Jev
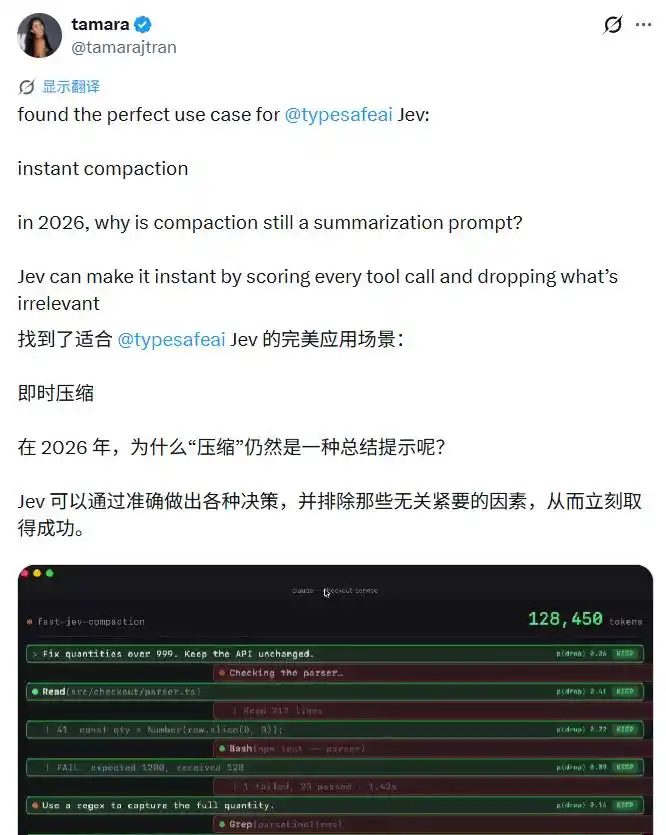
另一个在开发者圈传播很快的项目是 fast-jev-compaction。
这个 Claude Code 插件把大量工具调用和终端输出交给 Jev 评分,由 Jev 判断哪些内容仍与当前任务相关,再根据结果压缩发送给模型的上下文。项目上线后很快获得大量关注,并出现了多个移植版本。
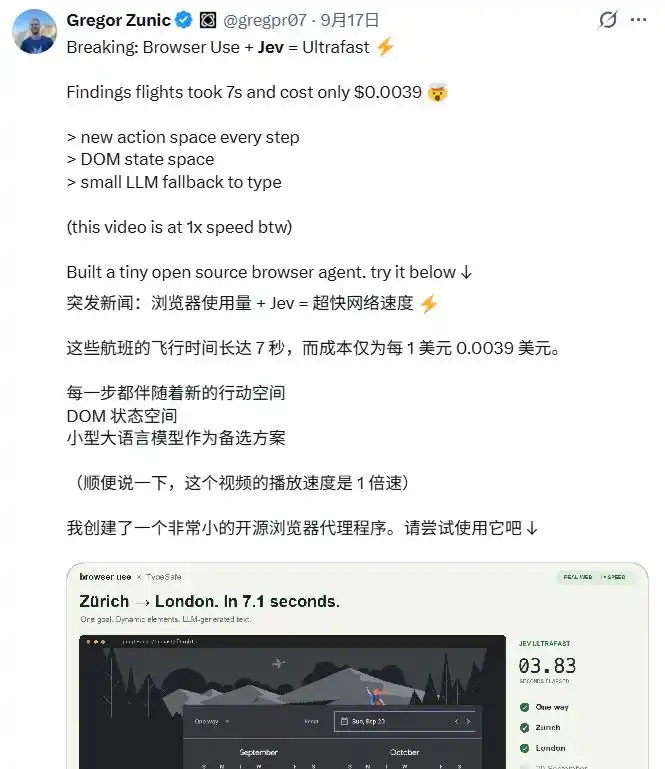
浏览器 Agent 也是 Jev 的热门实验场。当前已有多个开源项目采用「浏览器读取页面—生成候选动作—Jev 选择动作—浏览器执行」的循环。
在一个公开的航班搜索 Demo 中,开发者报告整个搜索过程大约耗时 7 秒,成本约 0.004 美元。
低延迟和低成本是关注焦点
这些案例解释了 Jev 为什么会在 Agent 开发者中快速升温。
很多 Agent 步骤本质上都是高频决策:该点击哪个按钮、该调用哪个工具、这条信息是否相关、当前任务是否结束、某个结果是否通过验收。当这类判断每天出现几十万甚至几百万次时,延迟和成本就会直接进入系统设计。
TypeSafe 在自家的 workflow benchmark 中表示,Jev 在部分任务上最高达到约 193.6 倍速度提升和 444.6 倍成本优势。TypeSafe 同时说明,这些结果处于其预计实际收益的高端区间,测试集也由公司模型能力团队制作,因此这些数字更适合作为技术路线的早期参考。
System One 和 Jev 的命名含义
「System One」来自 Daniel Kahneman 在《Thinking, Fast and Slow》中提出的 System 1 概念,也就是快速、直觉式的判断系统。
「Jev」则来自经济学家 William Stanley Jevons。TypeSafe 借用了「杰文斯悖论」的含义:当一种资源的使用效率大幅提高,其总体使用量反而可能迅速增长。
放到 AI 场景里,这个指向很直接。当一次智能判断的价格下降几个数量级,开发者会开始在过去不会频繁调用模型的环节加入 AI。
一条日志是否重要、一封邮件属于什么类型、一个 Agent 是否完成任务、一条广告处于什么认知阶段、一个网页动作该选择哪个按钮,这些细小判断叠加起来,可能形成下一代 Agent 系统中的庞大调用量。
仍处于 early access 阶段
Jev 目前仍处于 early access 阶段。围绕它的浏览器 Agent、代码 Agent、广告分析、评估器和上下文管理实验,才刚刚开始。
TypeSafe 提出的方向是,把 Jev 做成隐藏在软件流程中的「智能 if 语句」基础设施。它是否能在更多真实生产任务中延续当前表现,还要看后续验证结果。