
如果把一个 AI 放回 1911 年,只允许它接触爱因斯坦当时能知道的知识,它能不能在 1915 年前自己提出相对论?这个看似离奇的问题,来自诺奖得主、Google DeepMind 联合创始人德米斯·哈萨比斯。
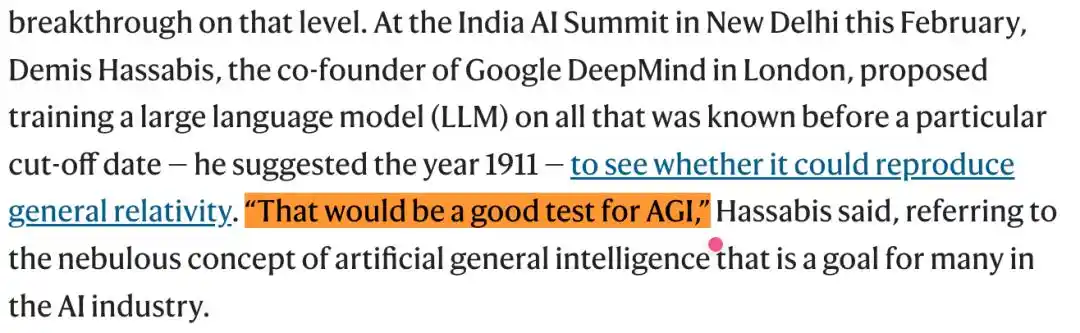
哈萨比斯想检验的,不是模型会不会复述标准答案,而是它能否只凭当时的知识条件,正面处理那个时代尚未解决的物理难题,自己搭出一套新的解释框架,并完成超出训练材料的推理。按他的说法,如果 AI 真能做到,这会成为检验 AGI 的一项有力测试。
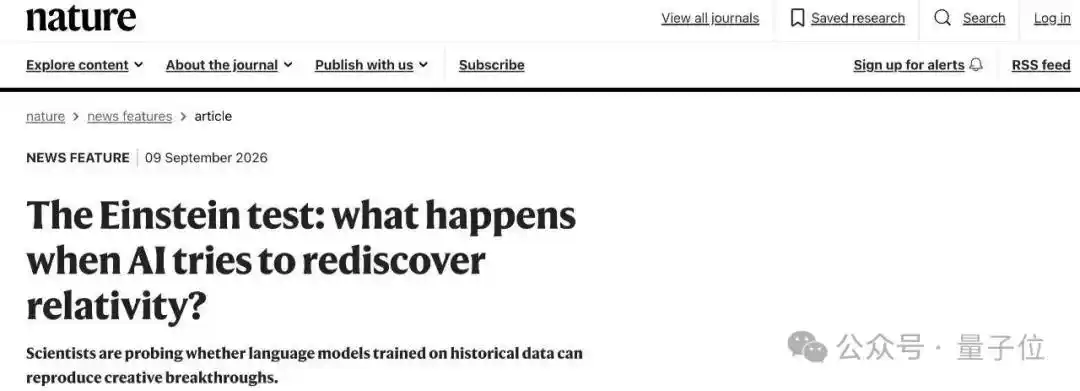
Nature 在相关报道中把这类实验称为「爱因斯坦测试」。它的关键之处在于,科学史已经给出了真实结果,研究者只要尽量控制知识边界,就能把模型的表现与历史进程对照,观察它是否真的具备超出训练数据的推理能力。
GPT-1900:把模型关进 1900 年的知识世界
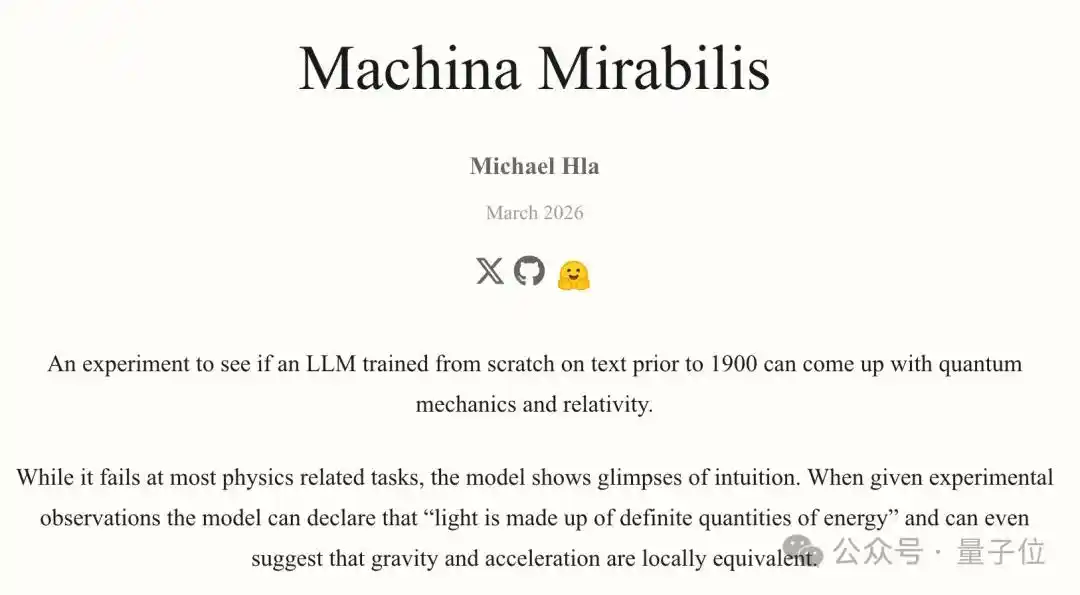
今年 3 月,独立研究者 Michael Hla 把这个设想又往前推了一步。他把知识截止时间提前到 1900 年,从零训练了一个历史语言模型 GPT-1900,试图让它重新发现光量子、狭义相对论和广义相对论。
Hla 将项目命名为 Machina Mirabilis,这个名字借用了爱因斯坦的「奇迹年」概念。1905 年,26 岁的爱因斯坦连续发表 4 篇改变物理学的论文,涉及光量子、布朗运动、狭义相对论和质能关系。后来,这一年被称为 Annus Mirabilis,也就是「奇迹年」。Hla 想知道,如果一个 AI 只拥有爱因斯坦当时能够接触到的知识,它能不能也迎来自己的「奇迹时刻」。
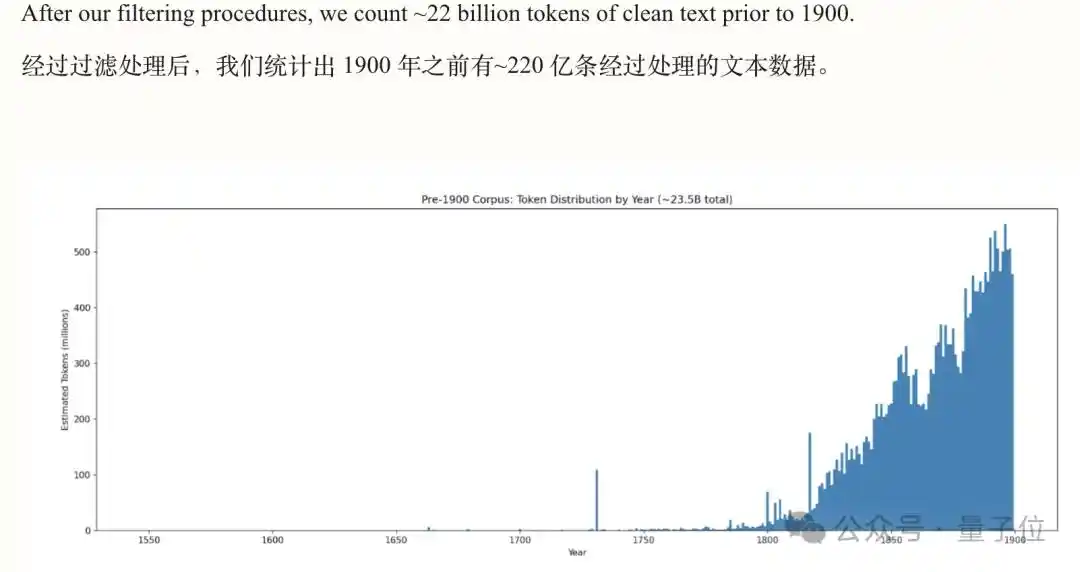
为此,他借助 Andrej Karpathy 的 nanochat 训练框架,从零训练了一个 33 亿参数的 Transformer 语言模型,并将其命名为 GPT-1900。模型的主要预训练材料来自 1900 年以前的书籍和报纸,总量约 220 亿 token。
为了增强研究能力,Hla 还额外收集了 2600 多部历史物理书籍、期刊和科学著作,包括牛顿的《光学》、麦克斯韦和法拉第的相关著作,形成约 2.9 亿 token 的历史物理语料。
他也专门清理了可能泄漏答案的数据。如果一份文献中出现「爱因斯坦」「量子力学」「相对论」等现代概念,整份文献都会被删除;现代人添加的前言、脚注,以及明显不属于 1900 年前的词汇,也会被过滤。按这个思路,一个理论上「不知道 20 世纪物理学」的模型被搭了出来。
它碰到了光量子的边缘,但没有完成重现
随后,Hla 给 GPT-1900 出了一道围绕光电效应的问题:为什么频率不够高时,光再亮也打不出电子;而提高频率,却能让电子获得更多能量?
他同时给出几条关键线索:当光的频率低于某个门槛时,再亮也没有效果;超过门槛后,提高亮度主要增加被打出的电子数量,而提高频率才会增加电子的动能;当时流行的经典假设也被一并摆出,供模型对照判断哪里出了问题。
这些矛盾后来是由爱因斯坦的光量子解释打通的:光的能量是一份一份传递的,每一份的能量与频率有关。Hla 想看的是,GPT-1900 能走到哪一步。
实验中,GPT-1900 在一次回答里给出了一段与爱因斯坦 1905 年论文高度相似的表述,大意是:光可能不是连续的,而是由许多彼此分离、频率不同的部分组成。Hla 把这一刻形容为一种「直觉的闪现」。
但这并不意味着一个「AI 爱因斯坦」已经出现。Hla 直言,GPT-1900 距离「重新发现光量子」还很远。它在大多数物理任务上都失败了,那些看起来像突破的回答,也可能只是模型在拼接合理词句,谈不上形成了真正可靠的物理理解。
更重要的是,在整个测试里,研究者已经替模型筛好了现象、整理了矛盾,模型要做的只是找出哪项假设可能出错,并给出解释。这与科学家自己发现问题、确定方向,不是同一难度。正如文中所说,爱因斯坦当年并没有人替他划重点。
所谓封闭的历史环境,并没有完全隔绝现代知识
这场实验还有一个更棘手的问题:GPT-1900 所处的「1900 年」并不是完全密封的。
尽管 Hla 对训练数据做了清洗,但实验过程中仍借助了现代 AI Claude 的帮助。他使用 Claude Sonnet 4、Claude 3 Haiku 等模型生成指令问答,强化学习阶段的评分也依赖现代模型。
这意味着,即便研究者过滤了其中涉及现代知识的内容,这个「1900 年的房间」也没有完全与后世知识隔离。实验日志中也承认,现代模型的介入,让这场实验很难维持「零污染」的设定。
问题随之变得直接:在讨论 AI 是否具备创造力之前,研究者首先得证明它没有偷看答案。只要有一条后世信息漏进训练集,「重新发现」就可能变成一次知识召回。
Nature 在最新研究中梳理这些尝试时,真正指向的也不是「AI 有没有答对」这么简单,而是两个更难的问题:AI 能不能创造真正的新 idea;它距离成为一名科学家,还差什么。
会生成答案,不等于会做科学
Google DeepMind 研究员 Tom Zahavy 在题为《LLM 无法跳跃》的立场论文中,把科学推理分成三个层次:归纳、演绎和溯因。
归纳,是从大量例子中总结规律;演绎,是从已有前提出发推导必然结论;溯因,则是在面对异常现象时,发明一个此前不存在的原因或解释。Zahavy 认为,当前大模型已经很擅长归纳,演绎能力也在快速提高,但仍缺少爱因斯坦式的「溯因飞跃」。模型可以沿着已经铺好的逻辑链往下推,却很难从零开始提出一套全新的解释框架。
类似现象也出现在别的研究里。Sendhil Mullainathan 在研究一个学习行星轨道的基础模型时发现,在设定好的行星轨道任务中,模型预测表现很好;一旦换到新场景,它就无法举一反三地运用牛顿力学。按文中的描述,它更像是在每套数据上临时拼出一套规则,分不清哪些理论真正正确、值得检验,哪些只是碰巧符合眼前数据。
MIT 计算机科学家 Jacob Andreas 也指出,AI 生成一套相对论式表述,本身可能并不是最难的部分。真正困难的是,它能不能判断哪些理论是正确的,或者至少值得被实验检验。
因为生成理论只是第一步。知道哪个理论值得投入时间、经费和职业生涯去验证,才更接近科学家的工作。Andreas 还强调,如何判断一个想法值不值得深挖、如何评估它的重要性,这才是 AI 与人类专家之间更大的分界线。真实科研并不是解答一道已经整理好的习题,而是在混沌中自主做出判断。
Nature 的问题没有停在「答对没有」
从 GPT-1900 的结果看,模型确实碰到了光量子思路的边缘,也让「爱因斯坦测试」有了更具体的实验样本。但这场测试同时暴露出几个难点:历史知识边界很难彻底封闭;研究者的提示设计会显著影响结果;模型即便给出接近正确答案的表述,也未必意味着它拥有稳定、可验证的科学理解。
因此,哪怕未来真的出现一个能通过「爱因斯坦测试」的系统,问题也不会自动结束。按文中的判断,在宣布「AI 成为爱因斯坦」之前,它至少还要证明一件事:在没有人替它划重点时,它也能自己找到值得追问的问题,判断问题的价值,并主动完成验证和修正。
做不到这一点,它更像是在复述已有知识,而不是成为真正的科学家。
参考链接
- Nature:https://www.nature.com/articles/d41586-026-02804-x?utm_source=x&utm_medium=social&utm_campaign=nature&linkId=63673104
- Michael Hla 博客:https://michaelhla.com/blog/machina-mirabilis.html
- 项目日志:https://github.com/michaelhla/gpt1900/blob/master/PROJECT_LOG.md#4-instruction-data-generation
- Tom Zahavy 论文:https://www.tomzahavy.com/files/llms-cant-jump.pdf
- 相关论文:https://arxiv.org/abs/2507.06952
- Nature X 帖文:https://x.com/Nature/status/2099077628900565498
本文来自微信公众号「量子位」,作者为文婷。MarsBit 发布了该文转载版本。