
OpenAI 旗下主打极速生成的 GPT-5.3-Codex-Spark 将在下周退役。Codex 负责人 Tibo 发文称,这款模型的使用量一直在下降,团队手中也已经有了「明显更好的模型」,「是时候给未来腾地方了。」
他随后还补充了一句自嘲式评论:「真不敢相信,我们居然发布过名字这么长的模型!!」
从发布时间算起,GPT-5.3-Codex-Spark 存续约 7 个月。按照文中披露的数据,它的生成速度可达每秒 1200 个 Token,是 OpenAI 第一个脱离英伟达技术栈运行的模型,也是 OpenAI 与 Cerebras 那笔 750 兆瓦、总价值超过 200 亿美元算力订单的首个交付成果。
退役消息公布后,讨论焦点转向独立额度
Spark 的退场并没有引发太多对模型本身的惋惜。Hugging Face 的 Vaibhav Srivastav 在评论区留言,感谢它的服役,并称其是第一个「最快的小子」,希望用户能在退役前再发一条 prompt,感受这段时间以来的变化。
但更多评论显得相当直接。有人问「所以它到底是干嘛用的?」也有人调侃,OpenAI 要退役 Codex-Spark 了,那仅存的 67 个重度用户可能会难过。
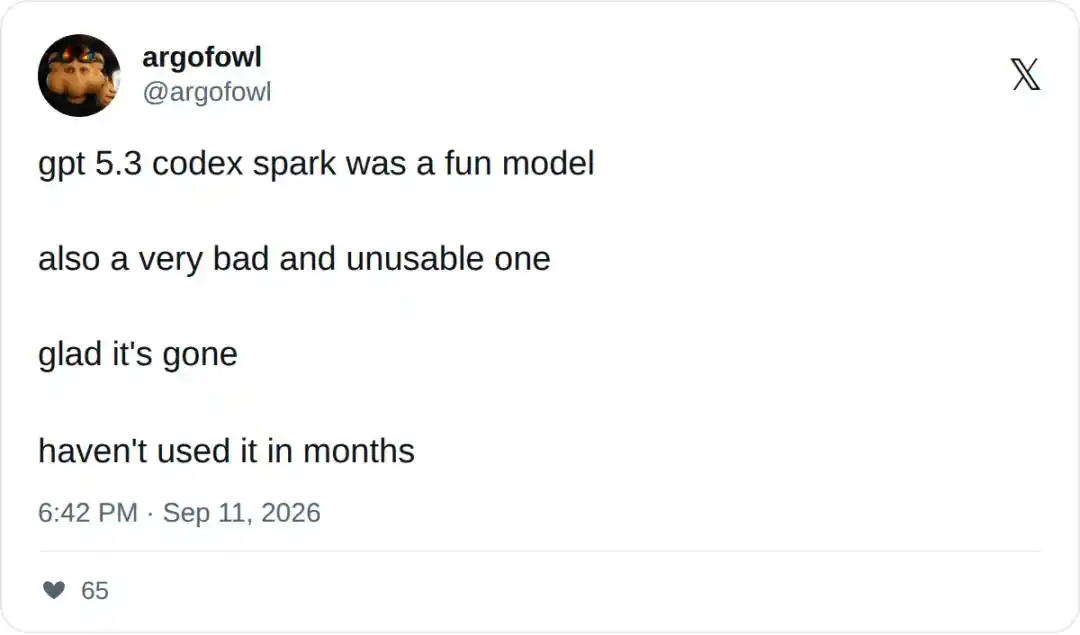
开发者 argofowl 的评价更尖锐。他称 Spark 是一个「好玩的模型,也是个极度糟糕、根本没法用的模型」,并表示自己已经好几个月没有再碰过它。
还有开发者提到,在几个规模不小的项目里,他几乎没有真正用过 Spark。即便是理解项目上下文、分析日志这类基础任务,Spark 也会很快把上下文窗口塞满,迫使他另开一个对话继续。
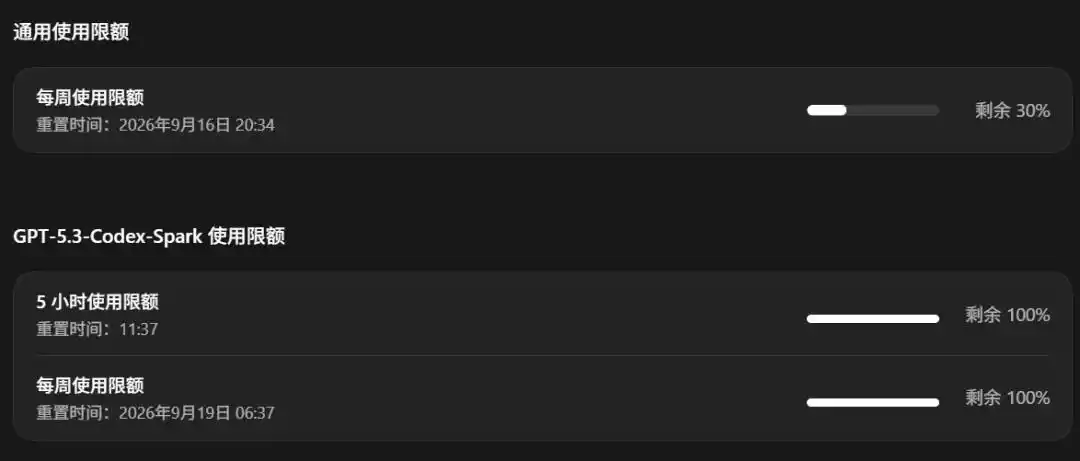
真正让部分开发者感到可惜的,不是模型能力,而是 Spark 附带的一份独立配额。知名开发者 Chubby 公开表示,他想要一个「GPT-6-Spark」,原因就在于 Spark 拥有一套不占主额度的独立套餐。
在 Astra 额度非常紧张的情况下,不少开发者把 Spark 当成主额度耗尽后的「备用油箱」。因此,退役消息传出后,社区首先关心的也是这部分备用额度是否会保留。
2 月上线时,Spark 被包装为实时编程模型
时间回到 2 月 12 日。Spark 上线时声势很大,被定义为 OpenAI 首个专为实时编程设计的模型,支持 128k 上下文,生成速度超过每秒 1000 个 Token。
按照 OpenAI 当时给出的数据,客户端与服务器之间的往返开销下降 80%,每个 Token 的处理开销下降 30%,首 Token 延迟减少一半。与传统逐行输出的体验不同,代码会以大段形式快速出现在屏幕上。
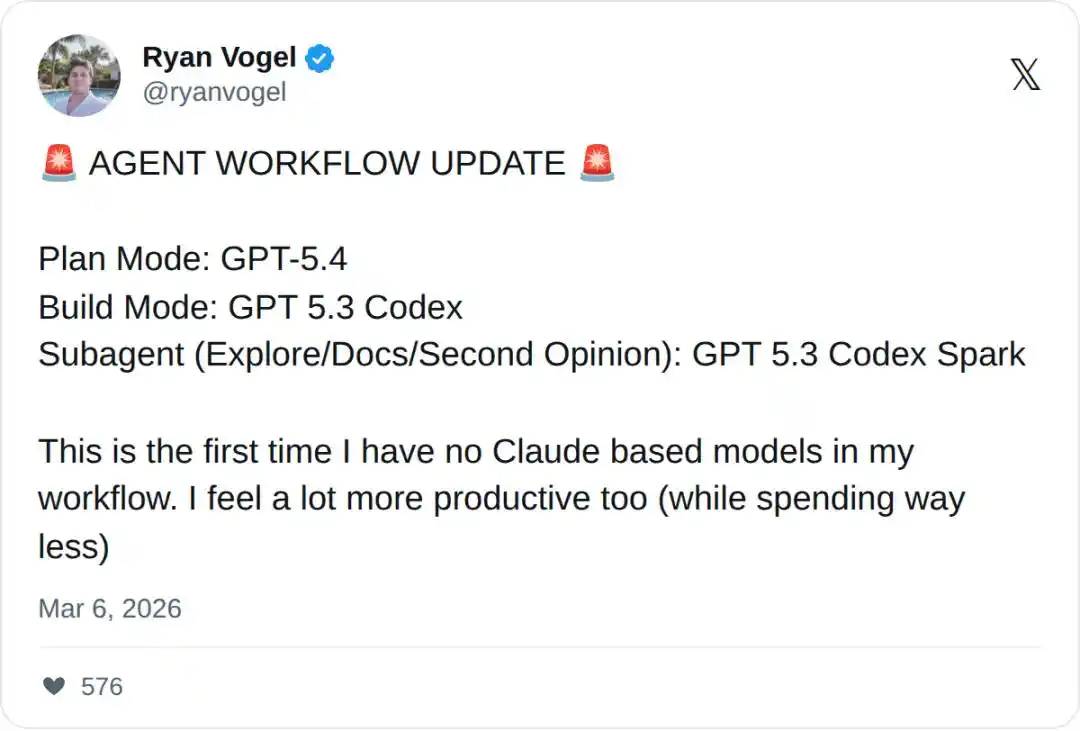
首批试用者中确实有人给出积极反馈。开发者 Ryan Vogel 把 Spark 直接纳入正式工作流:GPT-5.4 负责规划,GPT-5.3-Codex 负责构建,Spark 用于探索代码库、查文档和提供第二意见。他说,这是自己第一次在工作流里完全没有使用 Claude 模型,而且「效率更高,花得更少」。
Instructor 作者 Jason Liu 当时还一次性开启 20 个 Spark 子代理搜索文件系统,并喊出「RAG 已死」。之后不久,他加入了 OpenAI 的 Codex 团队。
Spark 之所以受到关注,还因为它承载了 OpenAI 在底层算力上的一次重要尝试。它是 OpenAI 第一个运行在英伟达技术栈之外的生产模型,底层算力来自 Cerebras 的晶圆级芯片 WSE-3。它也被视为 OpenAI 与 Cerebras 算力合作落地后的第一份答卷。
速度很快,但准确率明显落后
热度并没有持续太久。Spark 的问题很快暴露出来:由于单块晶圆无法容纳旗舰模型,它本质上是一个为了极限速度做出能力妥协的蒸馏版小模型。
在 Terminal-Bench 2.0 评测中,Spark 的准确率为 58.4%,明显低于完整版 GPT-5.3-Codex 的 77.3%。OpenAI 自己披露的 SWE-Bench Pro 曲线也显示,Spark 虽然能把任务时长压缩在 1 到 2 分钟,但准确率只在 47% 到 51% 之间。
相比之下,完整版 GPT-5.3-Codex 在 3 分钟时就能达到 51%,到 9 分钟时升至 56%,16 分钟可达 57%。也就是说,Spark 节省下来的几分钟,代价是准确率低了约 5 到 6 个百分点。
连官方宣传中的「15 倍提速」也遭到开发者质疑。Spark 发布第二天,开发者 Nicholas Van Landschoot 就在 X 上发长文分析对比条件,称所谓 15 倍速度提升,是拿 Spark 去对比开启最高推理强度的 GPT-5.3-Codex。
按他给出的说法,在同等准确率条件下,Spark 实际只快了 1.37 倍。
进入真实编码场景后,这类差距被进一步放大。开发者反馈集中在几个问题上:会凭空捏造 API 端点,JSON 格式不稳定,多步任务中容易跑偏。培训机构 Turing College 对它的总结很直接:「没有智能的速度,只是更快地失败。」
对程序员来说,等待 17 分钟拿到一份能跑通的代码,往往比 2 分钟收到一堆 Bug 更划算。以速度作为核心卖点的 Spark,也因此逐渐走向边缘化。
Ultrafast 模式上线后,Spark 失去定位
真正让 Spark 失去存在空间的,是 Cerebras 在 8 月 13 日发布的 Ultrafast 模式。
这一次,运行在晶圆上的不再是经过缩减的 Spark,而是旗舰模型 GPT-5.6 Sol。Cerebras 通过将大型旗舰模型按层切分,部署在多台 CS-3 节点上并构成流水线,在保持「与标准版同等智能」的前提下,把速度提升到每秒 750 个 Token。
Cerebras 给出的对比显示,Ultrafast 比标准档快 14 倍,中间还有一个 Priority 档位,速度约为标准档的 2.5 倍。Cerebras CEO Andrew Feldman 的评价是:「速度与智能,不再互斥。」
在 GDP-Val 的 6 个质量对齐任务中,标准档 Sol 平均耗时 7.7 分钟,其中 7.5 分钟消耗在模型生成本身。切换到 Ultrafast 后,同样任务总耗时降到 83 秒,其中模型生成耗时 68 秒,剩余 15 秒为工具调用等非推理开销。
按这组数据计算,端到端速度提升约 5.6 倍,而回答质量几乎没有差别。
这直接削弱了 Spark 继续存在的理由。Spark 最初的设计逻辑,是用智能换速度;但仅过去半年,同一家公司的晶圆系统已经能运行完整旗舰模型,速度只慢了四分之一,能力却没有缩水。
在 Cerebras 产能有限的情况下,一个无人问津的缩小版模型,与一个需要排队使用的旗舰版模型占用同批晶圆资源,取舍并不难判断。
OpenAI 模型库近三个月持续更新
Spark 并不是 OpenAI 近期唯一退场的旧模型。过去三个月里,Codex 相关产品线持续进行替换。
- 6 月 2 日,GPT-5.2 与 GPT-5.3-Codex 退役;
- 8 月 31 日,GPT-5.4 与 5.4 Mini 退役,用户整体迁移至 5.6 世代;
- 9 月 11 日,轮到 GPT-5.3-Codex-Spark。
随着旧一代型号退出,Codex 的命名方式也转向 Sol、Terra、Luna、Astra 这一套新体系。像「GPT-5.3-Codex-Spark」这样带有版本号和产品线后缀的长名称,已经越来越像上一阶段留下的产物。
更重要的变化在于,「快」这件事不再需要单独做成一个专用模型,而是被整合进旗舰模型的不同服务档位中。正如推理强度可以分为 Light 到 Max,OpenAI 现在也把速度划分为 Standard、Priority 和 Ultrafast,并与底层算力和付费方式直接绑定。
回过头看,Spark 更像一个过渡阶段的探路者。它证明了 Cerebras 的晶圆级芯片可以承接生成式 AI 的生产级流量,也证明推理任务可以脱离英伟达生态运行。等到验证完成、旗舰模型正式接管,这类过渡性模型自然会退出舞台。
随着各家平台把竞争焦点放到底层硬件利用率,下一轮比拼的目标也随之变化:不再是谁能做出更快的缩水模型,而是谁能让最强旗舰模型跑出更高的速度。