
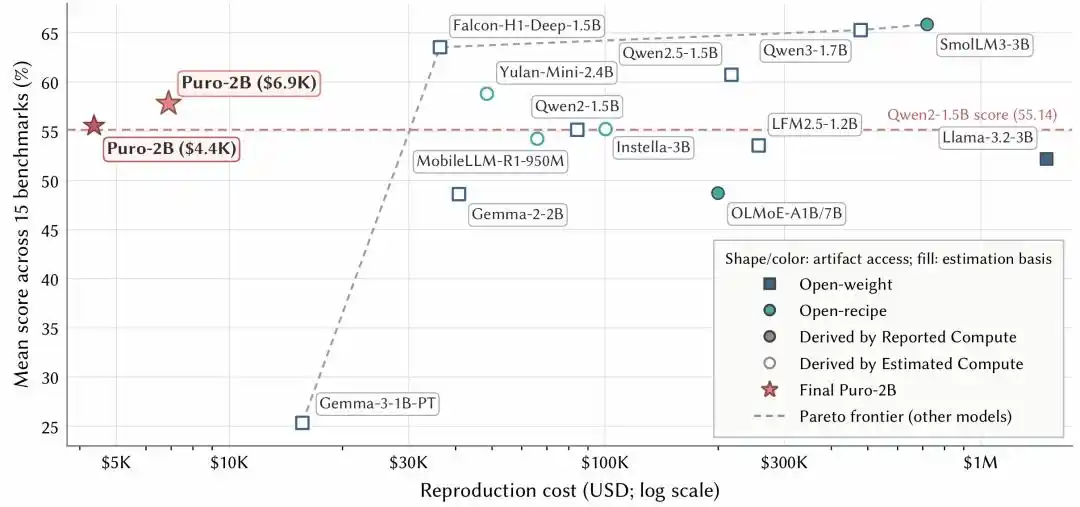
想从 1 亿级参数的小模型,迈到十亿参数、万亿 token 规模的预训练,成本一直是门槛。Qwen 系列虽然开源了权重,但没有完整公开预训练配方;OLMo、SmolLM 等项目公开得更彻底,数据和训练细节也更透明,不过复现代价依旧不低。文中给出的估计显示,即使是十亿级参数,复现 OLMoE-1B/7B 和 SmolLM3-3B 的算力成本也分别约为 20 万美元和 71.9 万美元。
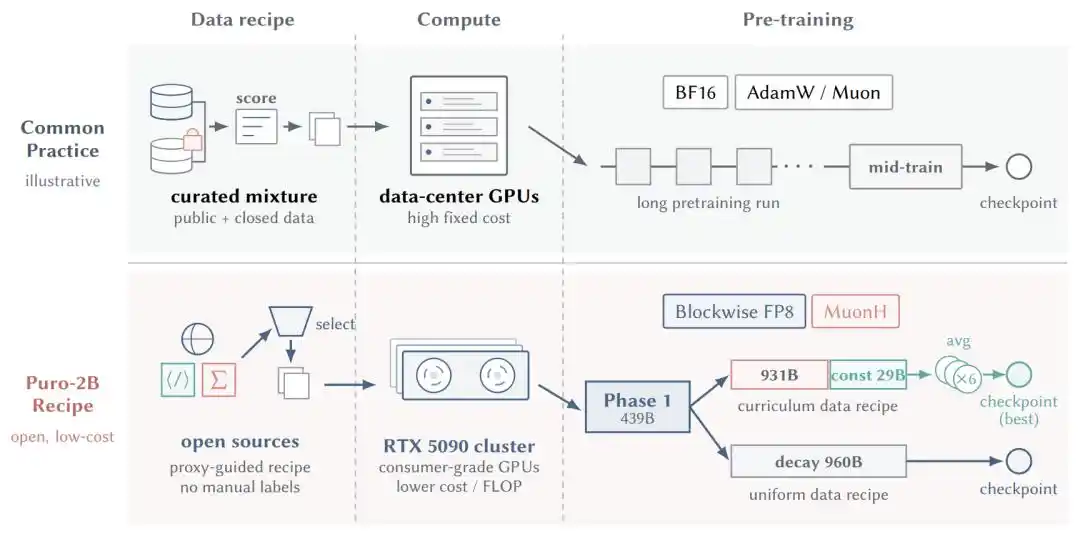
清华大学陈文光教授与吕凯风教授团队围绕这个问题推出了 Puro-2B(普罗-2B),并将训练数据、训练框架、训练配置和模型权重全部开源,目标是一套真正能“训得起”的低成本预训练方案。
Puro-2B 开源了什么
按照论文介绍,团队在消费级显卡 RTX 5090 的计算集群上,从头训练了一个约 20 亿参数的模型,最多使用了 1.4 万亿 token。
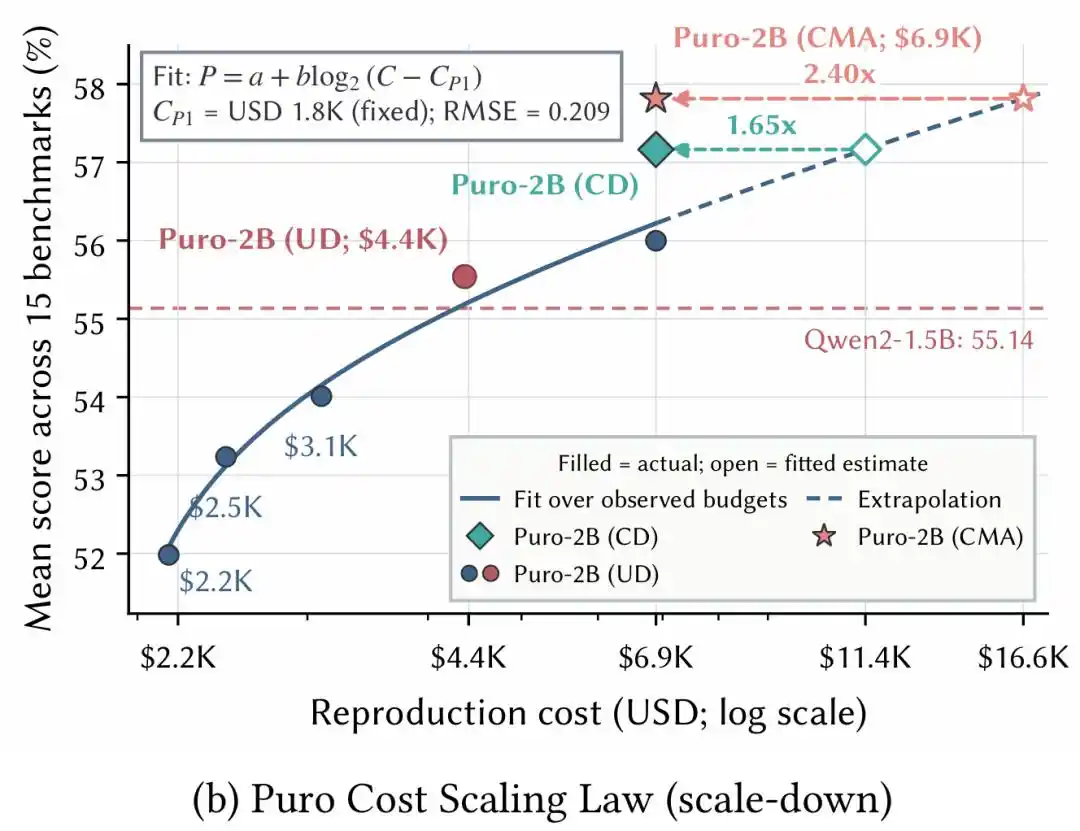
在覆盖 15 项任务的综合评测中,基于这套方案、预训练计算成本约 4400 美元的版本,在 15 项任务平均指标上超过 Qwen2-1.5B;成本约 6900 美元的最佳版本,平均性能接近 Qwen2.5-1.5B。文中将这一结果与其他开源方案对比,结论是 Puro-2B 明显压低了训练成本。
团队同步公开了多项材料,包括论文、模型和中间检查点、训练数据及配比、训练代码和数据处理代码。
- 论文链接:https://arxiv.org/pdf/2608.27370
- 开源材料合集:https://huggingface.co/collections/thu-pacman/puro-2b
- 模型与中间检查点:https://huggingface.co/collections/thu-pacman/puro-2b
- 训练数据与配比:https://huggingface.co/datasets/thu-pacman/Puro-2B
- 训练代码:https://github.com/thu-pacman/Puro-Megatron
- 数据处理代码:https://github.com/thu-pacman/Kaiyuan-Spark
成本和性能之间,团队给出了一条经验曲线
如果预算更少,模型还能训练到什么水平,这是团队继续回答的问题。Puro-2B 进一步拟合了一条成本—性能经验曲线,即 Puro Cost Scaling Law,用来估计不同预算下可达到的模型能力。
具体做法是,从同一个第一阶段训练检查点出发,调整第二阶段均匀数据配方的训练预算,再拟合平均性能得分与总成本之间的关系。这样一来,研究者在正式训练之前,就可以先估算某个预算大致能换来怎样的能力水平,再据此调整训练方案,而不必先把最长的训练过程完整跑一遍。
低成本方案来自五部分协同设计
文中将 Puro-2B 的低成本训练流程拆成五个部分:硬件选择、低精度训练、优化器改进、高质量数据利用效率,以及数据选择。它不是只靠单点优化降低费用,而是把不同层次的效率问题一起处理。
同样预算下,RTX 5090 提供更多算力
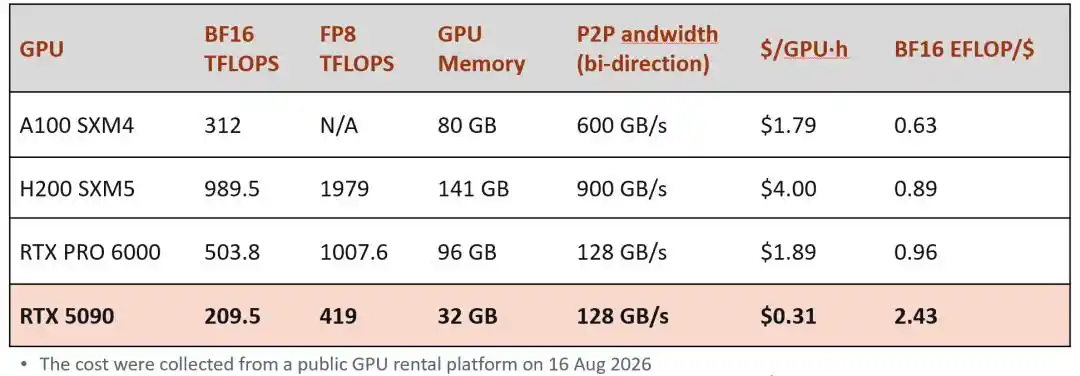
团队先从最底层的问题入手:同样预算到底能买到多少算力。按论文采用的 GPU 租赁价格计算,RTX 5090 的 BF16 峰值算力/美元约为 H200 的 2.77 倍。也就是说,按单位成本计,RTX 5090 比常见数据中心卡能换来更多算力,而且消费级显卡本身也更容易获取。
不过 RTX 5090 也有明显限制:只有 32GB 显存,没有 NVLink,无法直接照搬数据中心 GPU 的训练配置。Puro-2B 团队因此做了系统层改造。
在节点内,他们通过驱动和系统配置调整启用了 PCIe P2P 通信,把 GPU 间单向带宽从 31.5GB/s 提升到 56GB/s,通信延迟从 14.3µs 降到 0.4µs;在节点间,则启用了 GPU Direct RDMA,使 24 卡 AllReduce 总线带宽从 8.87GB/s 提升到 19.93GB/s。
训练策略也围绕十亿级参数模型和 RTX 5090 的硬件特征做了重配。团队采用数据并行与流水线并行的组合,避开通信更频繁的张量并行;同时重新分配流水线各阶段计算量、调整微批次大小,并按显存占用平衡优化器状态的放置位置,以减轻不同节点的显存负载不均。
文中称,经过这些优化后,综合 MFU 能超过 70%,消费级显卡的性价比最终转化成了训练成本上的优势。
FP8 训练换来 1.36 倍吞吐提升
有了更便宜的算力,下一步是提高精度效率。RTX 5090 所基于的 Blackwell 架构为 FP8 训练提供了条件。Puro 团队沿用了 DeepSeek-V3 的细粒度分块量化思路,把主要线性层的矩阵乘法放到 FP8 路径上,同时将数值敏感操作和训练状态保留在 BF16 或 FP32 精度。
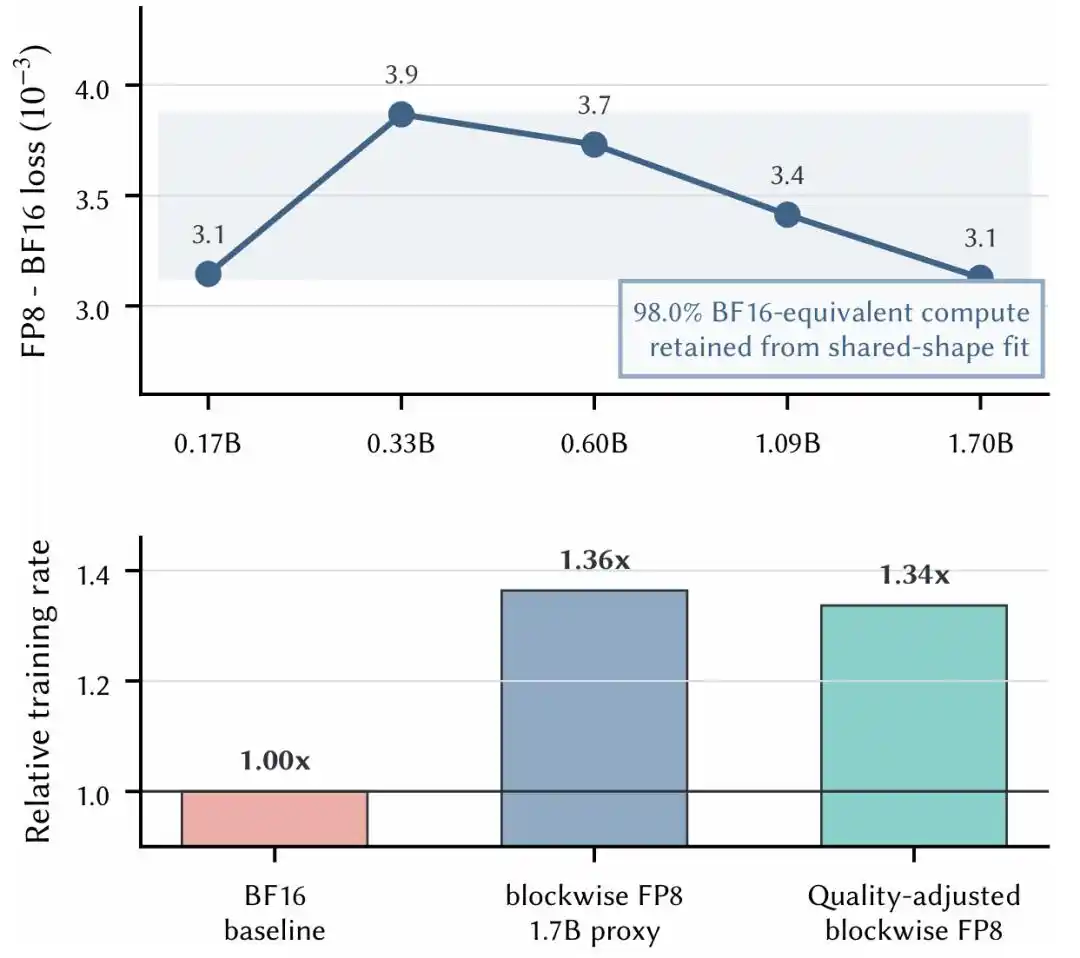
FP8 会带来一定精度损失,因此团队又做了不同模型规模的对照实验,也就是文中所说的 Scaling ladder,用来验证 FP8 带来的净效率收益是否划算。
五个模型规模的实验结果显示,相比 BF16,FP8 的验证损失高出约 0.0031—0.0039,差距不大,而且在不同规模上比较稳定。与此同时,FP8 的训练吞吐效率提升了 1.36 倍;把精度损失折算成达到同等损失所需的额外计算量后,文中估计其净效率收益仍约为 1.34 倍。
优化器重点转向有效学习率
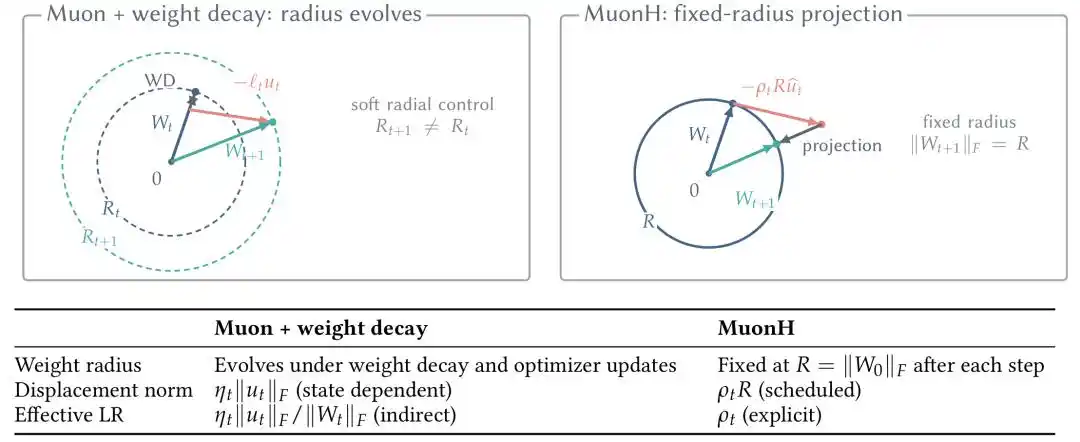
在计算精度之外,优化器和学习率决定了每一步参数更新的效果。团队采用的是 MuonH 优化器。按照文中描述,MuonH 在 Muon 的基础上对权重更新量做归一化处理,并在更新后把权重投影回固定半径,以同时控制更新范数和权重范数。
这样处理之后,有效学习率 ELR(Effective LR)可以被显式预设,而不是随着训练过程中权重尺度的变化而间接漂移。
团队给出的一个关键观察来自对照实验:如果用普通 Muon,不做固定半径的权重投影,而是只通过动态调整学习率,让训练过程中的 ELR 轨迹与 MuonH 对齐,那么损失曲线几乎会重合。文中据此认为,MuonH 的优势不能只归因于范数约束,ELR 的变化过程才是理解这类优化效果的重要线索。
进一步比较后,团队发现,在 weight decay 对权重范数约束不足时,普通 Muon 的 ELR 在训练前期下降更快,损失也更早下降;MuonH 则保留更平缓的衰减,后期表现更好。研究重点因此从“选哪个优化器”转向“如何设计更合理的有效学习率调度”。
在后续消融中,团队又考察了训练衰减阶段占比对峰值学习率和训练数据量的影响。结果显示,峰值学习率更高、训练周期更长时,通常也更需要更长的衰减过程。于是,Puro-2B 在第一阶段采用不依赖预设终点、支持持续训练的 power schedule,第二阶段采用长线性衰减,为最终损失收敛留出空间。
基于 Scaling Ladder 的比较显示,MuonH 方案相对调参后的 Muon 基线,训练效率约为 1.19 倍。
高质量数据排到后段,再配合模型平均
除了优化器,数据效率也受数据排布方式影响。文中指出,高质量数据在整体训练数据中的占比不高,但作用关键,把它们放到训练后段,有助于提高利用效率。许多开源数据集本身也会提供样本质量分数。
Puro 团队利用这些信号,在各数据源内部把质量更高的样本排到训练后段,再按照训练进度对齐、混合不同来源的数据块。这样可以让训练所接触的数据逐步走向更高质量区间,同时保持局部训练区间内的数据配比大体稳定,避免质量变化和领域数据比例变化同时发生。
不过,数据排好了,并不意味着模型一定能充分学进去。团队此前研究发现,当训练后期学习率过低时,最后出现的优质数据很难推动参数继续更新。为此,他们采用了课程模型平均,即 Curriculum Model Averaging,简称 CMA:在训练后期保持恒定学习率,让模型继续吸收优质数据,再对末端检查点做权重平均,以缓解较高学习率带来的训练噪声。
进一步消融显示,若只是沿学习率衰减轨迹直接做模型平均,并不会稳定带来收益,真正起作用的是数据顺序、后期学习率和模型平均策略的配合。
按 Puro Cost Scaling Law 的估算,与随机数据排布的 Uniform(UD)相比,数据课程加学习率衰减,相当于把成本效率提高到约 1.65 倍;完整的 CMA 方案则达到约 2.40 倍。
数据选择也被纳入评测流程
解决了数据顺序,接下来是决定训练哪些数据。团队建立了一套“数据源—数据切片—能力评测”的分层比较流程。对于大规模且附带评分的数据集,他们会按不同分数区间抽取数据切片;对其他符合条件的数据源,则采用随机切片。
每个候选切片都从同一个检查点出发,在相同训练配置下继续训练,再用固定评测比较数学、代码、中文和通用能力的多维表现。这样既能比较不同数据源,也能发现同一数据源内部的质量差异。
文中的代理实验还显示,相比数学能力,代码能力对通用能力有更多削弱。基于这一观察,团队在第二阶段适当提高了数学数据比重,并结合领域覆盖与质量筛选,确定最终的数据配比。相关数据集评估结果也已在报告中公开。
这套方案不只是在省算力
回看整套 Puro-2B 方案,团队把不同层次的效率问题拆开处理:硬件部分降低单位计算价格,FP8 提高计算峰值并缩短执行时间,MuonH 提高损失收敛速度,CMA 提高训练数据利用效率,代理评测则帮助筛出更值得训练的数据。这几部分共同组成了一个面向低成本预训练的完整流程。
文中还给出了一条更直接的研究用途:研究者可以控制预训练过程,再去检验后训练结果。一个常见问题是,预训练阶段的方法改进,到了后训练之后是否还有效。如果研究者手中只有开源权重,就很难控制模型此前经历过怎样的预训练;而 Puro-2B 提供了一条可运行且成本可承受的实验路径,允许研究者修改预训练方法、继续微调,再检验最终效果。
Puro 团队以 CMA 和 Uniform 两组预训练权重为起点,采用相同微调流程进行对照。在两组数学能力微调实验中,基于 CMA 初始化微调的 GSM8K 准确率分别高出 1.77 和 2.02 个百分点;在 Tulu-3 混合领域微调中,15 项基准平均分提高 1.17 个百分点,IFEval 提高 1.36 个百分点。
文中称,三组对照都呈现总体提升,这意味着 CMA 的优势能够延续到后训练阶段。按这一说法,Puro-2B 提供的不只是一个更高分的模型,也是一套可以用于检验预训练方法最终是否有效的基础流程。
论文链接:https://arxiv.org/pdf/2608.27370
本文来自微信公众号「新智元」,作者:LRST。