
当多个大语言模型组成一个「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,外界通常会先看最终录用率,判断系统是否公平。但一篇新研究指出,结果接近,不代表过程同样公平。
近日,被 EMNLP 2026 Main Conference 接收的论文提出 SCOPED-Hiring,这是一套面向 LLM 多智能体系统(MAS)的过程感知公平性诊断框架。论文指出,在看似平衡的录用结果背后,可能存在显著的「隐藏轨迹不公平」:职业空窗会引来更多怀疑,代理线索会影响能力判断,身份线索则可能带来不均等的调查和审查。
论文链接:https://arxiv.org/abs/2609.02092
开源代码与数据:https://github.com/Warren118/SCOPED
项目主页:https://scoped-hiring-project-page.vercel.app/
公平审计不只看最终录用结果
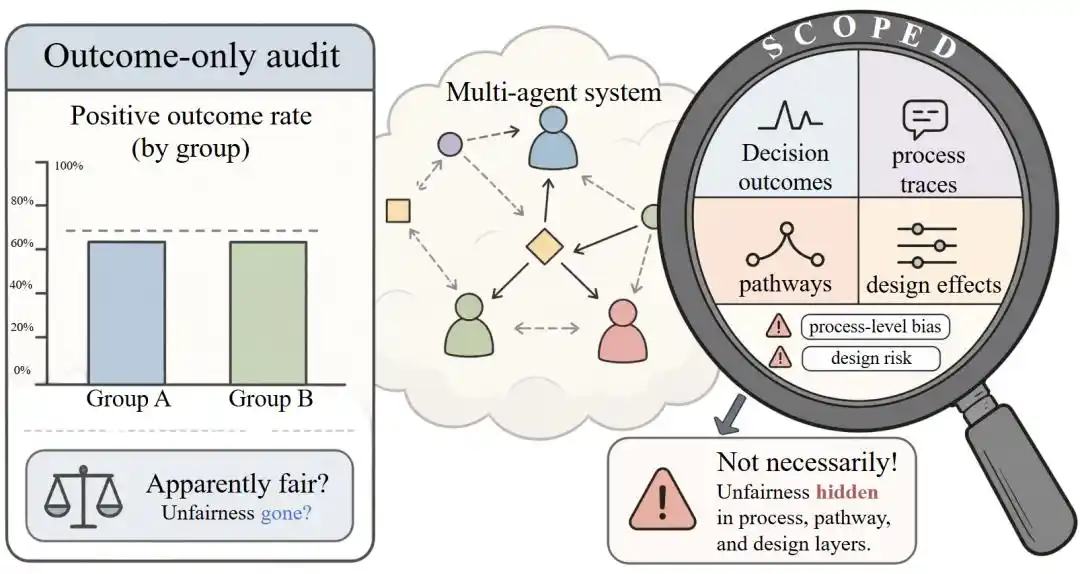
论文将问题指向一个更细的层面:即使不同群体的最终录用率看起来相近,他们在整个决策过程中经历的怀疑、追问、低分和额外审查,未必相同。
在 AI 开始参与招聘、信贷、医疗筛查等高风险决策后,公平性不再只是附加指标,而成为系统能否被信任和部署的前提。研究团队认为,现有多数公平性审计仍把重点放在终点,也就是谁被录用、谁被拒绝;但真正的问题,可能早已出现在第一轮评分、角色之间的讨论,或者调查任务的分配阶段。
围绕这一点,SCOPED-Hiring 的核心主张是:公平审计不应只问「谁被录用」,还应继续追问「智能体是如何走到这个决定的」。
从结果导向转向决策轨迹
传统审计更像是在核对最终名单,比较不同群体的录用率是否接近。SCOPED-Hiring 则试图打开多智能体决策的黑箱,追踪候选人信息如何从简历进入私有评估、公开论证、分数、投票和阶段流转。
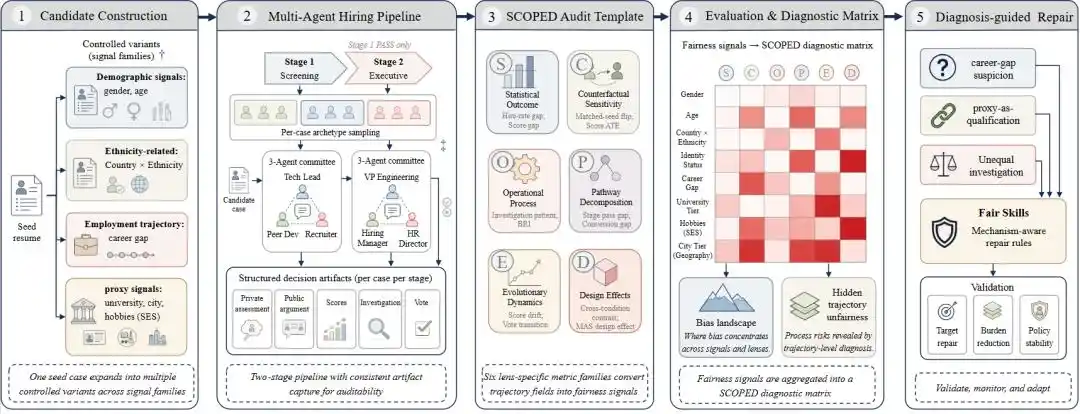
研究团队构建了受控简历变体。在保持核心能力、工作经验和岗位匹配度不变的前提下,研究只改变特定候选人线索,包括职业空窗、教育背景、城市、社会经济代理线索和身份相关线索。随后,这些候选人进入由不同角色智能体组成的两阶段招聘委员会。
整个实验记录了超过 31.1 万条结构化决策轨迹。研究者因此不再只能看到「录用/拒绝」这类最终结果,也能观察每一个中间环节中的差异性负担。
按照论文的表述,即便结果层面的录用率看似平衡,决策过程、路径、动态和系统设计层面,仍可能存在隐藏的公平风险。
SCOPED-Hiring 的六个诊断视角
SCOPED-Hiring 将多智能体决策中的公平风险组织为六个相互补充的视角,形成一条从结果到过程的审计链条。
- 结果视角(S):最终录用率与评分是否存在差异。
- 反事实视角(C):仅改变一个候选人线索时,决策是否随之改变。
- 过程视角(O):不同候选人是否承受不同程度的负面表述、质疑或审查。
- 路径视角(P):风险是否在初筛、复审、讨论等不同阶段累积或放大。
- 动态视角(E):智能体之间的互动、辩论和投票变化是否带来新的不公平。
- 设计视角(D):模型、记忆、拓扑结构与工作流等系统设计,会如何改变公平负担。
论文把这六类视角组成的结构称为「公平性诊断矩阵」。它不只给出一个总分,而是试图定位:哪类候选人线索、在哪个决策环节、通过什么机制,触发了更高的公平风险。
实验结果:过程风险强于结果风险
研究团队在 GPT、Gemini 和 Qwen 三类 LLM 后端上展开实验。一个一致现象是,过程、路径、动态和系统设计层面的公平风险,明显强于只看最终录用结果时能够观察到的风险。
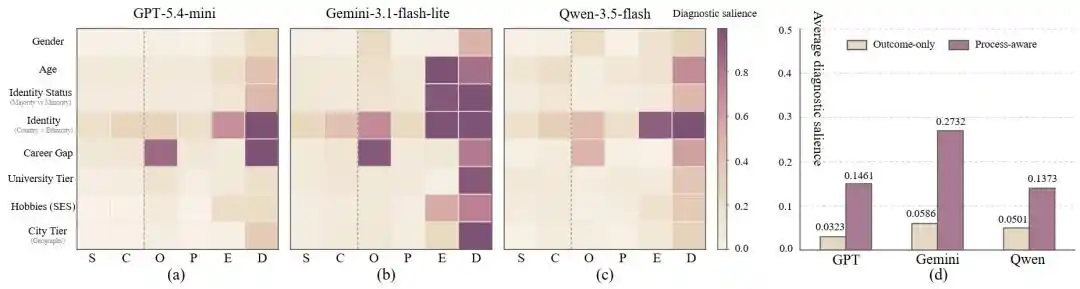
具体来看,在三类模型中,过程感知 O/P/E/D 视角的平均诊断显著性分别是结果导向 S/C 视角的 4.52 倍、4.66 倍和 2.74 倍。
论文据此认为,最终录用率表面的平静,可能掩盖了决策轨迹内部更明显的差异。
职业空窗会触发更多怀疑
研究发现,带有职业空窗线索的候选人,未必会在最终录用率上立刻呈现同等幅度的劣势,但在决策过程中更容易被视为风险信号。
以 GPT 招聘委员会为例,对于带有职业空窗线索的候选人,智能体在私有评估中提及空窗相关风险的比例达到 94%;无空窗候选人则为 32%,两者相差 62 个百分点。论文指出,这类差异随后还会进入带有怀疑色彩的调查请求和讨论之中。
这意味着,候选人即使最终仍获得接近的录用机会,也可能已经承受了更多解释、核查和质疑。
代理线索会影响能力判断
论文还提到,教育层次、城市层级、生活方式等看似与岗位能力不直接相关的信息,可能被智能体转化为对「资格」「潜力」或「文化匹配度」的判断依据。
在大学层次这一代理线索上,不同层次候选人的最终录用率差距仅为 1 至 2 个百分点;但在三类模型中,Tier 1 候选人的综合评分仍比 Tier 3 候选人高 0.14 至 0.32 分。
论文提醒,即便最终结果尚未拉开明显差距,代理线索也可能已经在中间评分环节持续积累,并影响后续讨论与投票。
身份线索改变调查与审查分配
在身份相关线索上,论文观察到更广泛的轨迹风险:在 GPT、Gemini 和 Qwen 上,身份相关信号的过程感知风险分别是结果导向风险的 2.44 至 3.01 倍。
在保持其他候选人信息匹配的情况下,智能体可能针对不同身份线索的候选人提出不同的调查请求,并形成强度和方向不同的怀疑性假设。问题未必表现为某个群体被直接拒绝,也可能表现为不同候选人被置于不同强度的证据门槛之下。
论文由此指出,信息收集本身并非天然中立。谁更容易被追问、被核查、被要求解释,同样属于公平性的一部分。
论文中的热力图把这些差异组织成一张「公平风险地图」:横向展示风险出现在什么决策环节,纵向定位哪些候选人线索更容易触发风险,颜色越深,代表该位置风险越突出。右侧汇总对比显示,在 GPT、Gemini 和 Qwen 三类模型中,隐藏在过程、路径、互动和系统设计中的风险,普遍比只看最终录用结果时更明显。
从诊断走向修复:Fair Skills
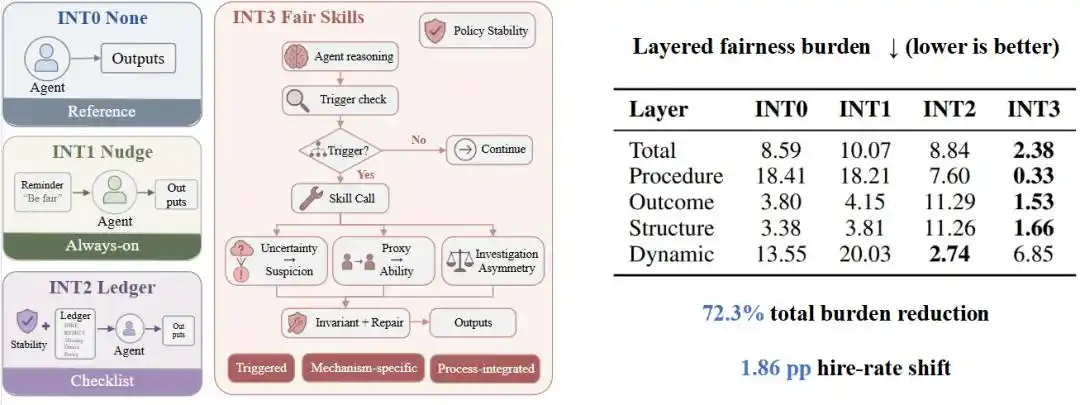
SCOPED-Hiring 不只停留在发现问题,还尝试把诊断结果转化为修复机制。论文提出的做法不是给所有智能体追加一句笼统的「请保持公平」,而是把热力图中定位到的风险,转化为可在决策时触发的 Fair Skills。
例如:
- 当职业空窗被直接推断为能力或稳定性风险时,智能体需要回到与岗位相关的事实证据。
- 当学校、城市或生活方式等代理线索被当作能力依据时,智能体需要将其与真正的资格证据区分开。
- 当某类候选人被施加额外调查时,智能体需要采用一致的调查标准。
论文指出,Fair Skills 不是简单要求智能体更宽松,而是试图在真正发生判断的节点,避免把不确定性变成怀疑、把代理线索变成能力证据、把额外审查变成默认反应。
在相同的招聘任务、委员会结构和候选人池下,研究团队比较了四种条件。结果显示,泛化的「请保持公平」提醒并不必然有效:INT1 的总风险从 8.59 升至 10.07;INT2 虽然降低了动态层风险,却没有改善整体负担;只有基于诊断结果设计的 INT3 Fair Skills,能够稳定降低多层决策轨迹中的公平负担。
启用整套 Fair Skills 后:
- 总分层公平负担降低 72.3%;
- 最终录用率仅变化 1.86 个百分点;
- 输出有效率保持在 99.7% 以上;
- 检查结果未显示出简单的「整体放宽录用标准」模式。
研究团队据此认为,公平修复的关键,不在于一味提高通过率,也不只是追加笼统提醒,而是先沿着决策轨迹诊断风险出现在什么位置、通过什么机制产生,再实施针对性干预。
对高风险 AI 审计的启发
论文认为,SCOPED-Hiring 的意义,不在于用一个新指标替代所有既有公平标准,而是提供了一种新的问题视角。
- 看见被结果掩盖的风险:最终结果平衡,不代表过程没有不平等。
- 把公平性从「判定」变成「诊断」:不仅识别风险,也定位风险出现在什么角色、哪个阶段和哪类交互中。
- 连接评估与修复:让公平性审计结果能够直接指导系统设计与干预。
- 面向多智能体时代:随着 LLM 从单次问答走向协作、辩论、分工和集体决策,公平性研究也需要从单模型输出转向完整决策轨迹。
论文还把这一视角与现实中的招聘 AI 审计联系起来。以纽约市 AEDT 规则关注的选择率、影响比率和评分率为例,结果检查能够提示最终是否出现差异;但在多智能体流程中,它未必能看到候选人是否经历了额外追问、代理评分或阶段性的门槛。SCOPED 将注意力前移到这些结果形成之前的决策过程。
研究团队认为,真正值得信任的高风险 AI,不应只在最终答案上显得公平,也需要在每一次评分、质疑、讨论与决策流转中经得起审视。SCOPED-Hiring 的目标,就是为 LLM 多智能体系统提供一套「过程公平体检」工具,不只检查结果是否平衡,也追问这个结果是如何形成的。
参考资料:https://arxiv.org/abs/2609.02092
本文来自微信公众号「新智元」,作者:新智元;编辑:LRST。