
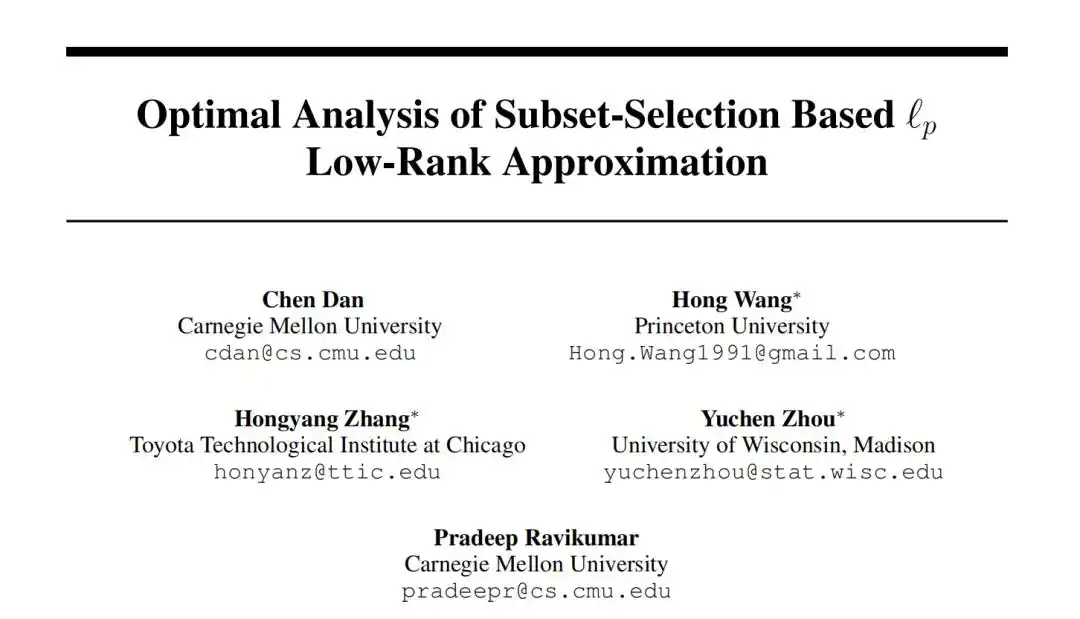
据 MarsBit 转引微信公众号“量子位”文章,近期有网友发现,新晋菲尔兹奖得主王虹曾发表过一篇 NeurIPS 2019 论文,而且并非挂名作者,而是共同一作。
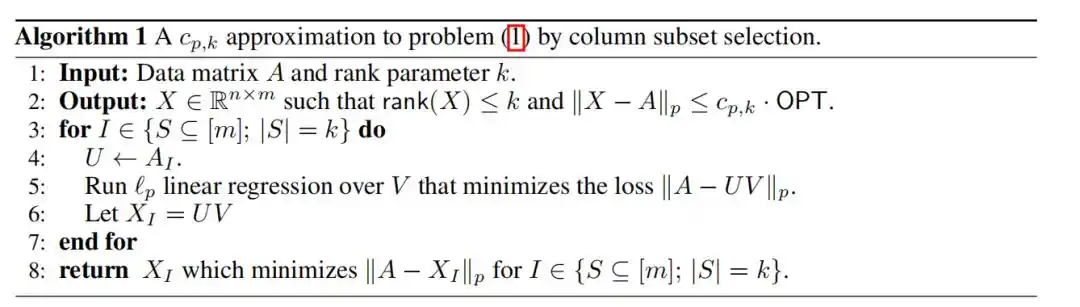
这篇论文的研究主题,是机器学习和数据分析中的基础任务之一:低秩矩阵近似。文章称,现实数据常可整理为矩阵,但矩阵规模往往很大,直接存储和处理的成本较高。低秩近似的目标,则是用一个结构更简单、秩更低的矩阵,尽可能准确地还原原始矩阵。
论文聚焦列子集选择
文中介绍,近来常用的近似算法之一是列子集选择(Column Subset Selection,CSS)。这类方法并不直接构造一个全新的低秩矩阵,而是从原始数据矩阵中挑出若干具有代表性的列,再用这些列张成的空间去逼近整个矩阵。
由于 CSS 选出的列直接来自原始数据,相比普通矩阵分解得到的抽象向量更容易解释,同时也能降低存储与计算成本,因此适合处理大规模数据。
在此前研究中,一般低秩近似下,CSS 算法的近似比上界约为 O(k+1),其中 k 表示目标矩阵的秩。文章指出,k 越大,理论上允许出现的最坏误差也越大。
王虹等人的工作则把这一结果继续推进:
- 当 1≤p≤2 时,近似比为 (k+1)^(1/p);
- 当 p≥2 时,近似比为 (k+1)^(1−1/p)。
按照原文说法,相较此前统一的 O(k+1) 结果,这一界更紧,对算法误差的限制也更严格。对于 p≥2 的情形,论文还构造了对应下界,并称其结果精确到常数 1。
关键技术来自调和分析
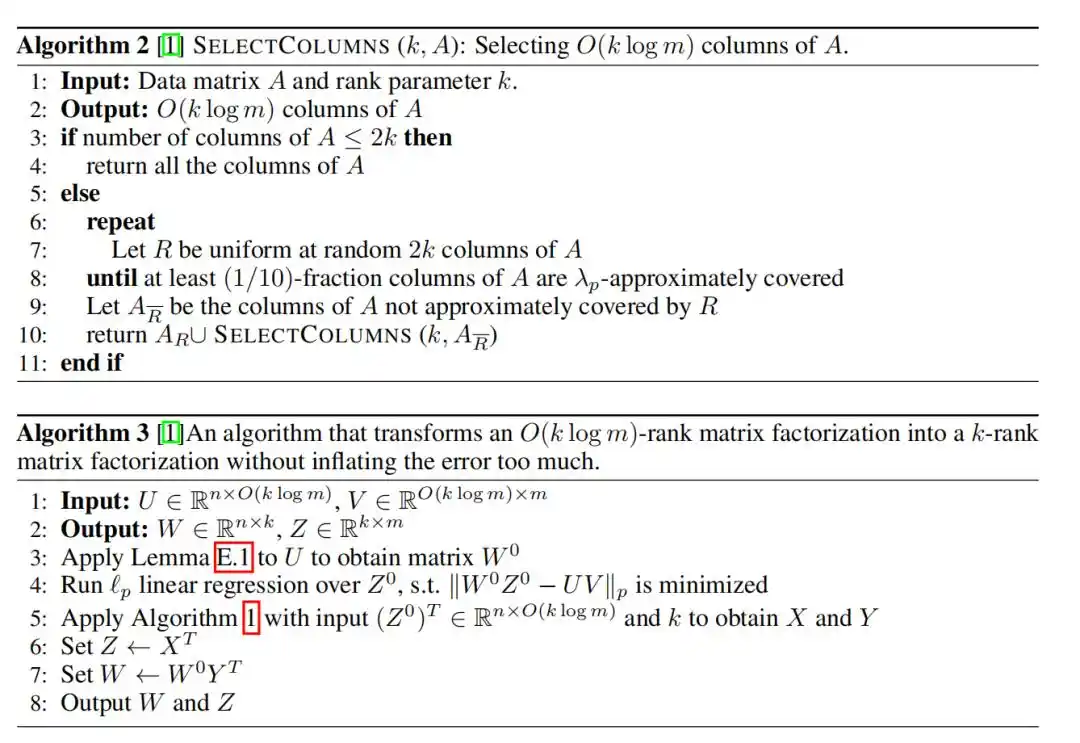
文章认为,这篇论文最能体现王虹数学背景的部分,在于作者引入了调和分析中的经典工具——Riesz–Thorin 插值定理。
通常情况下,如果要证明一套算法在所有 p 值下都成立,往往需要针对不同 p 分别做复杂分析。原文提到,在一些端点情形,比如 p=1、p=2 和 p=∞ 时,问题相对更容易处理;在此基础上,再利用 Riesz–Thorin 插值定理,就可以把这些端点结论推广到中间全部 p 值。
具体做法是,论文先证明 p=1、2、∞ 三个特殊情形,再通过插值理论推出整个范围内的近似界。文章称,这套工具在调和分析和算子理论中属于经典方法,但并不是当时理论计算机科学研究者最常使用的技术。
NeurIPS 当年的审稿人也注意到了这一点。根据原文,审稿人最终认可这篇论文的主要技术创新,在于把 Riesz–Thorin 定理引入计算机领域;Meta Review 则将其评价为一篇论证相当扎实的论文。
文章据此认为,这篇工作提供了一个典型的跨学科案例,即机器学习中的部分问题,可以借助纯数学工具找到突破口。
NeurIPS 2026 审稿机制调整
在回到当下的 NeurIPS 2026 时,原文提到,会议审稿机制正在发生明显调整。按照 NeurIPS 2026 的要求,作者投稿时需要在五种贡献类型中,选择最符合论文定位的一类,分别是 General、Theory、Use-Inspired、Concept & Feasibility 以及 Negative Results。
文章认为,王虹这篇 2019 年的论文毫无疑问属于 Theory 类型。依据 NeurIPS 2026 最新审稿指南,理论论文首先考察的是数学严谨性与正确性,证明、引理和整体逻辑都必须成立,因此理论论文不应因缺少实验而被忽视。
同时,NeurIPS 2026 也明确指出,理论贡献可以独立成立,设计新算法的目标不一定是击败最新应用模型或在最大数据集上取得 SOTA。在原创性方面,论文也可以通过从其他学科引入新的证明工具,或者对既有工具进行创新性综合来体现价值。
按照原文的说法,这一标准与王虹这篇论文高度契合:作者没有提出今天语境下的新神经网络架构,也没有训练参数规模巨大的模型,而是把调和分析中的插值定理引入低秩近似问题,推进了近似算法界限。
文章称,即便放到 2026 年的评审框架下,这仍是一篇相当标准的 NeurIPS 理论论文。这也说明,NeurIPS 并不等同于神经网络模型发布,对已有方法给出新的理解、发现新的性质,或建立更紧的理论界限,同样属于原创贡献。
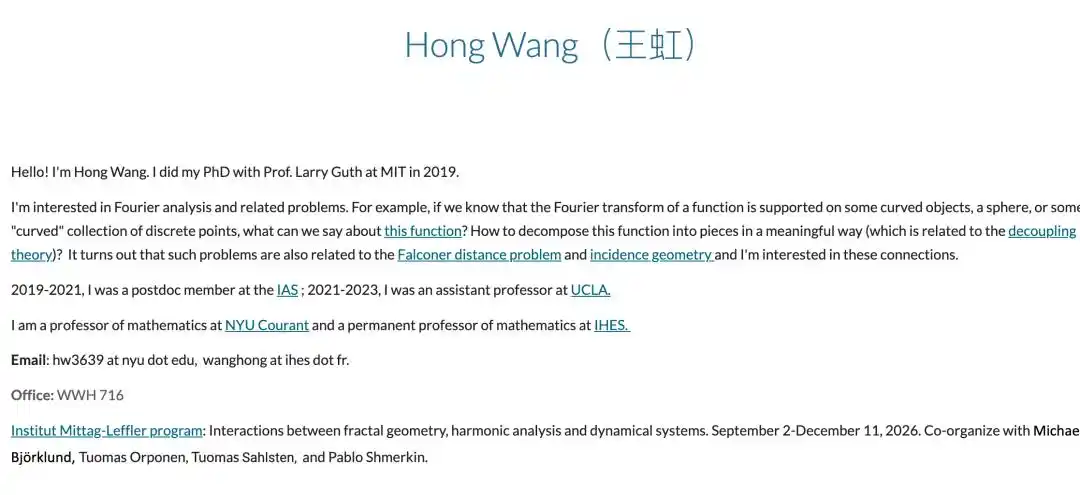
论文链接在个人主页中是个例外
原文还提到,在王虹个人主页列出的近 40 篇论文和预印本中,几乎每篇都附有完整链接,唯独这篇 NeurIPS 2019 论文是个例外。
文章最后指出,数学和 AI 之间的边界并没有想象中那么清晰。以这篇论文为例,菲尔兹奖得主可以在 NeurIPS 发表理论工作,而数学语言也能在 AI 问题中发挥作用。
参考链接包括 NeurIPS 2019 论文页面、NeurIPS 2026 Reviewer Guidelines、王虹个人主页,以及原文列出的另一条外部链接。
本文来自微信公众号“量子位”,作者为鹭羽,MarsBit 对相关内容进行了转载。