
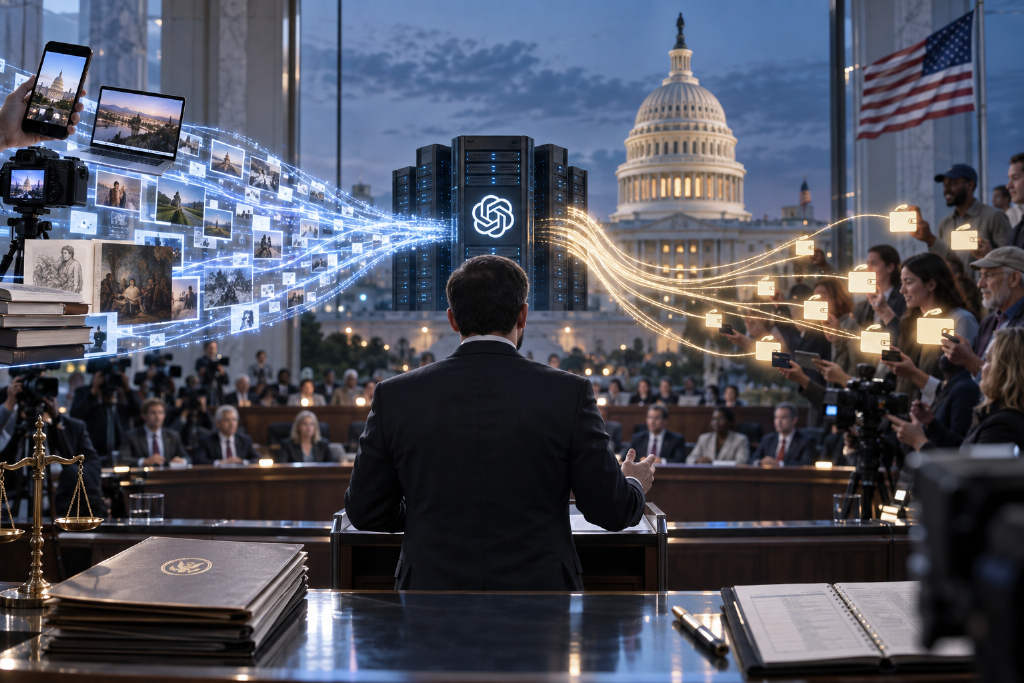
杨安泽近日在 Surrounded 节目中与 AI 乐观主义者展开辩论时表示,人工智能正在加快自动化,也让科技行业出现更强的「赢者通吃」格局。他认为,大型科技公司利用公众长期未获补偿的数据训练模型并获取收益,政策讨论不能只停留在技术进步本身,还要处理失业、不平等和利润分配问题。
杨安泽提出数据分红与税制改革
杨安泽在节目中指出,企业使用民众未获补偿的数据,每年价值超过 3,000 亿美元,但普通人并没有从中分到利润。他提出 Data Dividend,也就是数据分红,主张内容提供者在其数据或创作内容被企业用于训练 AI 模型时,应获得相应分润。
除数据分红外,他也提出税制改革思路,认为可以通过增值税来抓取科技巨头的高额利润,并借此建立更稳固的经济安全网。在他的表述中,这类税制工具也有助于应对大型科技企业通过跨国转移或会计操作规避传统企业所得税的问题。
AI 发展被指加剧赢者通吃和就业极化
杨安泽认为,AI 的发展正在推动资本、数据和算力向少数科技巨头集中,市场结构更偏向赢者通吃。虽然 AI 降低了一部分技术门槛,但中间层白领岗位正面临更快的挤压,他在节目中点名律师、会计师和数据分析师等职业,称这类职位正在减少。
他还表示,企业一边使用公众提供的免费数据训练模型,一边获取巨额利润,普通人却难以分享成果。与此同时,资本配置也在发生变化,资金从其他方向转向 AI 服务器和数据中心,一些企业甚至通过停止招聘应届毕业生来压缩人力,这在他看来会推高隐性失业。
全民基本收入被视为经济安全底盘
围绕劳动力市场的转型压力,杨安泽再次强调全民基本收入和数据分红两项主张。他认为,个人数据在商业体系中具有很高价值,科技公司若使用个人数据和内容创作来训练 AI 模型,就应支付授权费用和分润。
在政策设计上,他提到可参照主权财富基金或科技企业加权指数,从相关收益中提拨一部分,向全民发放基本红利。他认为,民众获得分红后再用于本地消费,有机会带动区域经济循环。
以个人经历说明「使用者付费」逻辑
杨安泽还举了自己的例子。他说,曾有一家 AI 公司为了让模型学习他撰写书籍中的内容,通过出版商向他支付了 2,500 美元授权费。在他看来,如果内容创作者在作品被 AI 模型用于训练时都能获得类似授权收入,这才是更公平、也更合理的经济模式。
增值税被视为对抗避税的工具
对于税收工具的选择,杨安泽认为,传统企业所得税容易被科技巨头借助跨国利润转移或会计安排规避,导致税基流失。相比之下,增值税可以在数字服务、广告点击和数据交易等商业增值环节直接征税,减少企业节税空间。
按照他的说法,这部分税收若持续流入全民基本收入机制,就能把 AI 带来的高额利润部分转化为公共资源,让技术进步的经济收益不只停留在少数公司手中。
文章列出的几个核心观点
- AI 发展正在加快资本与数据集中,形成赢者通吃局面,并冲击中产白领岗位。
- 企业投资方向转向数据中心等基础设施,并通过冻结招聘来缩减人力,失业压力随之上升。
- 个人数据是 AI 训练的重要资源,应建立数据授权和分红机制,让内容提供者获得回报。
- 全民基本收入可作为基础经济保障,资金来源可连接数据分红与增值税安排。
- 传统企业所得税难以有效覆盖跨国避税行为,增值税被视为更直接的征税工具。