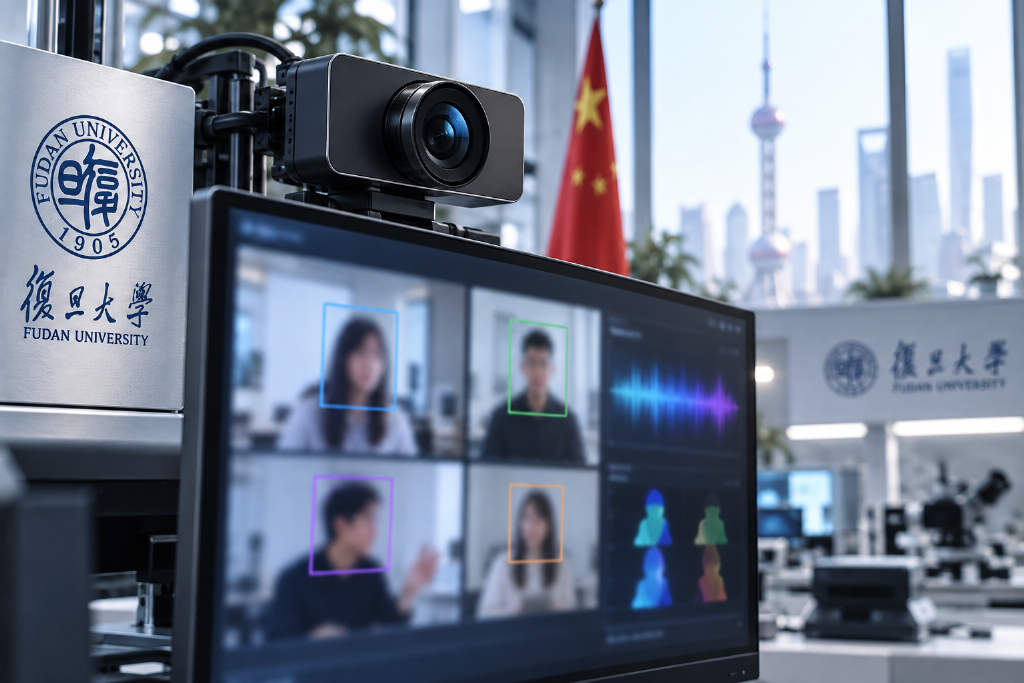
复旦大学2026-09-15 12:49:09复旦大学发布 AVTrack 音视频说话人追踪基准,论文已被 ICML 2026 接收复旦大学 CVL 实验室发布面向复杂人类中心场景的音视频追踪基准 AVTrack,并公开项目主页、论文、代码与数据集。该基准包含 871 段视频、平均时长 54.0 秒、3,120 条带跨帧身份的像素级实例轨迹,覆盖 8 类可诊断挑战。团队评测显示,现有方法在长期身份关联和音视频不一致场景下仍存在明显短板,其中 AVTracker 在 HOTA 指标上达到 29.08。430
蚂蚁灵波2026-09-11 10:13:00LingBot-Map 入选 ECCV 2026 Oral,开源社区与学术界同步验证蚂蚁灵波今年 4 月开源的流式 3D 重建模型 LingBot-Map,已在 GitHub 获得 16.9K Stars 和 1.9K Forks,并多次登上 GitHub Trending。其论文《Geometric Context Transformer for Streaming 3D Reconstruction》现已入选 ECCV 2026 Oral。项目围绕机器人如何在长视频中保留空间记忆展开,提出 GCA 几何上下文注意力,在长序列重建、轨迹稳定性、点云质量和运行效率上给出一套新的技术路径。920
ECCV2026-09-11 02:51:21ECCV 2026奖项公布:最佳论文揭晓,李飞飞论文获时间检验奖ECCV 2026公布最佳论文、最佳论文提名和时间检验奖等奖项。本届大会于9月8日至12日在瑞典马尔默举行,收到10473篇有效投稿,接收2834篇,中稿率27.1%,其中163篇入选oral。最佳论文授予伦敦帝国学院的HKTex研究,另外两篇来自Meta和纽约州立大学石溪分校的论文获提名;李飞飞参与作者的《Perceptual Losses for Real-time Style Transfer and Super-resolution》入选时间检验奖。410
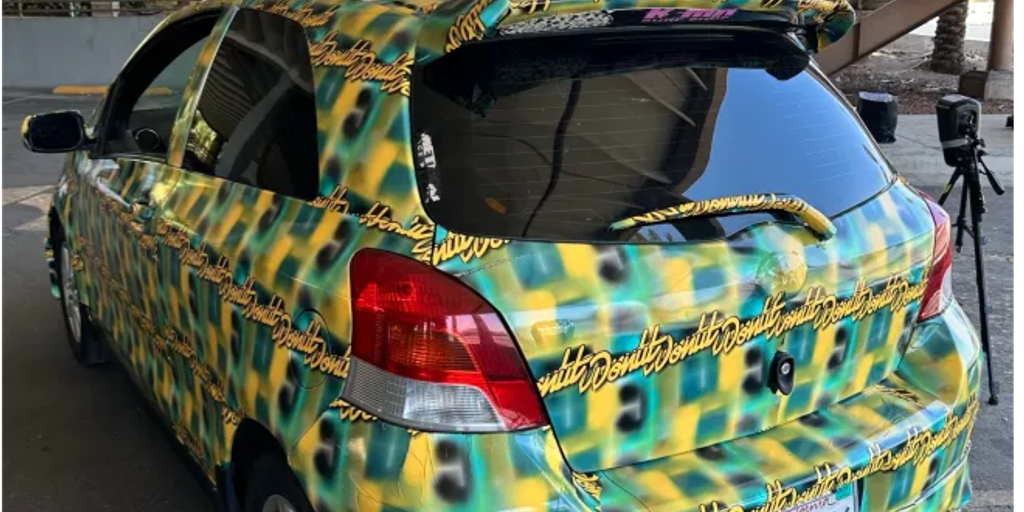
人工智能2026-08-12 21:33:05研究者展示 AI 图案,可躲过 Flock 监控摄像头识别堪萨斯城安全社区组织者 Bill Swearingen 表示,经过约 3100 万次测试,他已能生成可让 Flock 摄像头检测软件失效的图案。该图案不会让摄像头失明,画面仍会正常记录车辆,但上层目标检测模型可能无法把它识别为车辆或车牌。他在 Def Con 与 YouTube 频道 Donut Media 合作,首次公开演示将一辆 2009 款 Toyota Yaris 包覆新图案后驶过 Flock 摄像头的效果。1610
清华大学2026-07-24 07:00:17清华团队推出 AutoMIA,可自动生成支持 3D 打印的镜像错觉艺术清华大学等单位研究团队提出 AutoMIA,可将任意两张图片自动转化为镜像错觉 3D 艺术品,并同时优化形状与颜色。论文已被 CVPR 2026 接收为 Highlight Paper,还获得 Efficient CVPR 奖。实验显示,该方法在平滑度、噪声控制、形状一致性和计算效率上优于对比方法,平均设计时间为 76 秒,并已完成 3D 打印实物验证。280
世界模型2026-07-06 06:44:26MemoBench 揭开世界模型短板:10 款视频模型物体重现得分均未超 0.6哈佛、MIT、IBM、谷歌等机构研究者推出世界模型评测基准 MemoBench,首次系统检验动态遮挡场景下的“物体恒存”能力。该基准基于 360 段合成与真实视频,评估 10 个主流视频生成模型在物体身份维持、状态推演与记忆连续性方面的表现。结果显示,所有模型的物体重现得分均低于 0.6,说明当前模型即使画面连贯,也难以在目标离开视野后正确恢复其状态。740