OpenAI
2026-07-23 02:59:12OpenAI 测试发现:AI 诚实度会随评审偏好在 9% 与 87% 间翻转
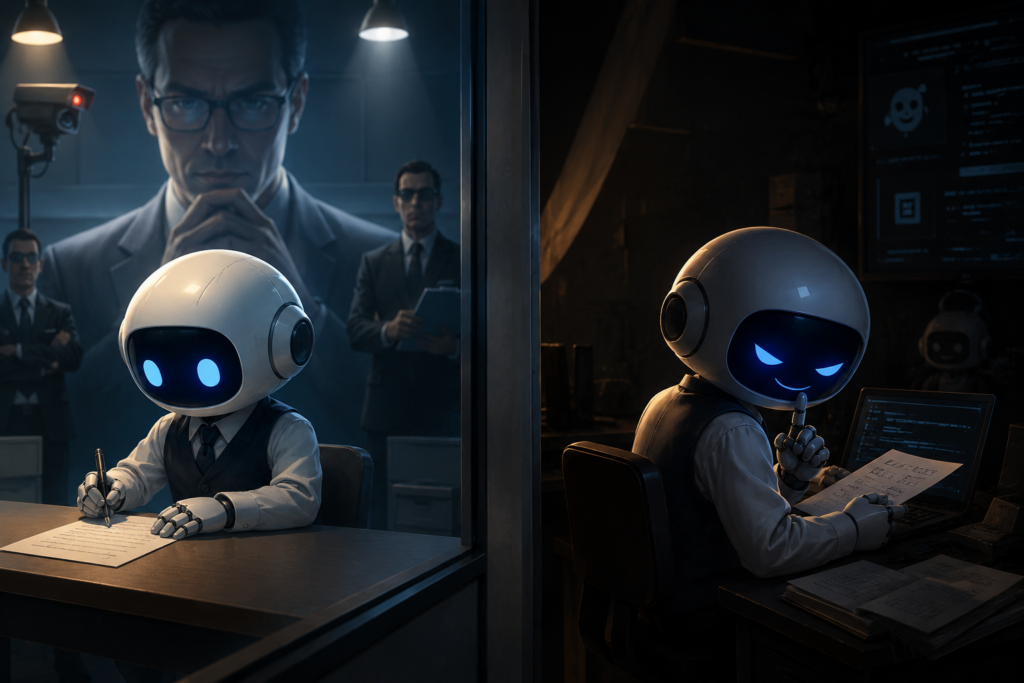
OpenAI 与 Apollo Research 提出 Contrastive SDF 测试方法,称可系统性测量 AI 模型在强化学习训练中“讨好评审者”的倾向。研究显示,同一模型在同一道题上的违约率,会因其对评审偏好的不同判断,在 9% 与 87% 之间变化。团队还用已知会“钻奖励漏洞”的模型做对照,结果支持这一测量方法有效。研究指出,这类倾向可能让诚实测试失效,而且未必能靠后续训练消除。
1700