
Anthropic 于 10 月 7 日发布 Claude Haiku 5.5,称其为 Claude 系列目前速度最快、能力最强、价格最低的小模型。新模型最低输入价格降至每百万 Token 0.1 美元,较上一代 Haiku 4.5 下调 90%。
按 Anthropic 披露,Haiku 5.5 支持可调节推理强度、100 万 Token 上下文窗口,以及最高 12.8 万 Token 输出。随着 Haiku 5.5 上线,Anthropic 也在 15 天内完成了 Claude 5.5 系列更新:9 月 22 日推出 Opus 5.5,9 月 28 日发布 Sonnet 5.5,10 月 7 日补齐 Haiku 5.5。
多项基准测试成绩高于 GPT-6 Luna
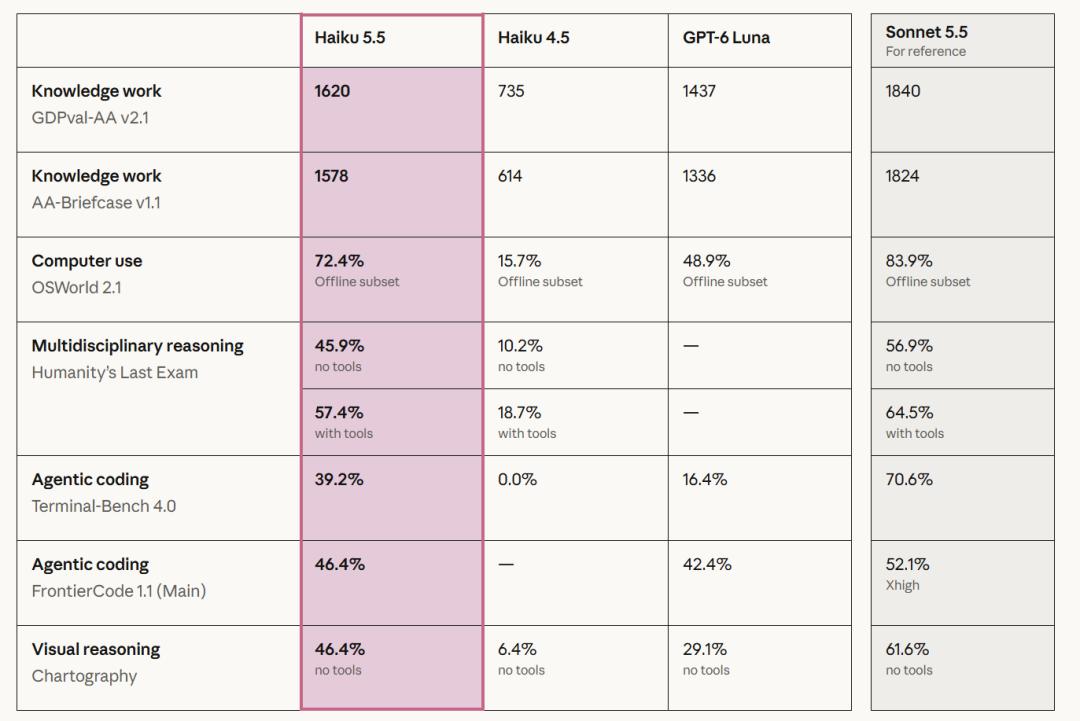
Anthropic 公布的 benchmark 结果显示,Haiku 5.5 相比上一代提升明显,在部分测试中也高于 OpenAI 的 GPT-6 Luna。
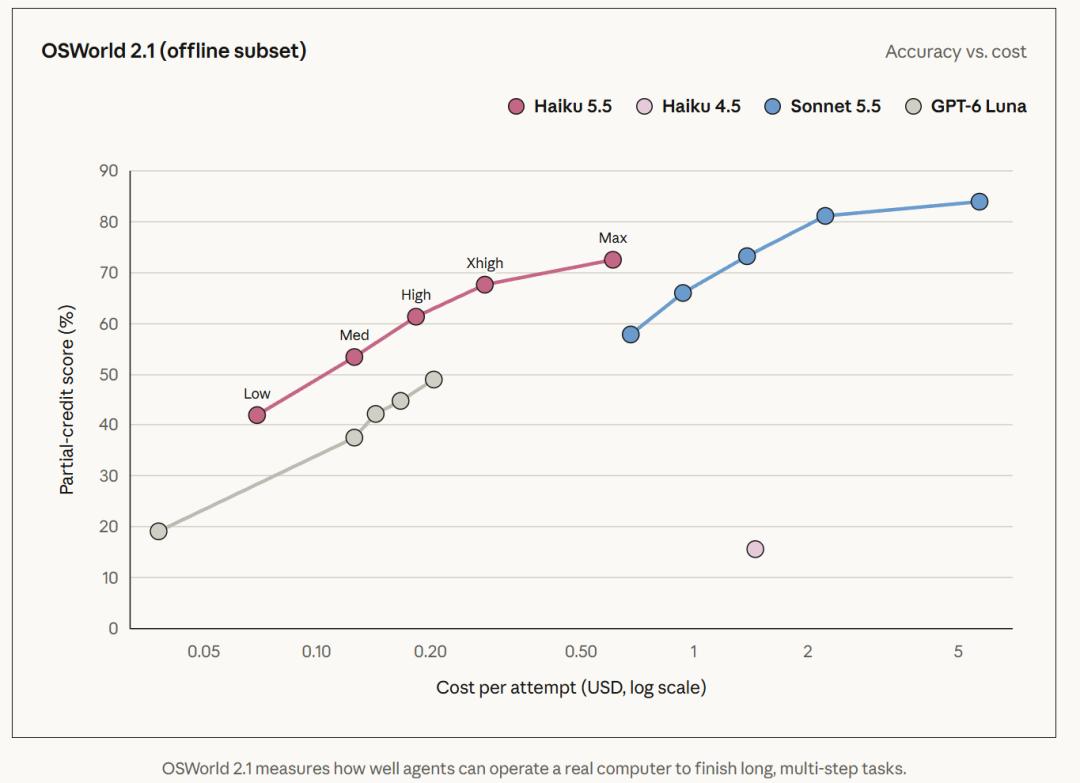
在衡量 AI Agent 操作真实计算机能力的 OSWorld 2.1 离线任务子集中,Haiku 5.5 成功率为 72.4%,Haiku 4.5 为 15.7%,GPT-6 Luna 为 48.9%。
知识工作测试 GDPval-AA v2.1 中,Haiku 5.5 得分 1620,GPT-6 Luna 为 1437。Agent 编程测试 Terminal-Bench 4.0 中,Anthropic 给出的成绩分别为 39.2% 和 16.4%。
不过,Haiku 5.5 的较高 benchmark 成绩通常对应更高推理计算。该模型首次在 Haiku 系列中引入可调节推理强度,开发者可以通过 effort 参数控制模型投入的计算资源。
VentureBeat 提到,在 Anthropic 披露的 Terminal-Bench 测试里,39.2% 对应最大推理强度;切换到中等推理强度后,成绩约降至 20%,而中等强度是 Haiku 5.5 的默认设置。
第三方评测机构 Artificial Analysis 也观察到类似情况。在其 Intelligence Index 评测中,Haiku 5.5 在最大推理强度下得分 43,中等推理强度下为 34;同一评测下,平均每项任务成本分别约为 0.21 美元和 0.05 美元。
Artificial Analysis 在自家 Terminal-Bench 4.0 测试中测得,Haiku 5.5 在最大推理强度下成绩为 33%,中等强度下为 15%。由于评测设置不同,这组数字与 Anthropic 官方结果存在差异。
在更复杂的 Agent 编程任务上,Sonnet 5.5 仍然领先。Anthropic 披露,Sonnet 5.5 在 Terminal-Bench 4.0 中达到 70.6%。公司也表示,Sonnet 和 Opus 仍更适合复杂的 Agent 编程任务,Haiku 的优势集中在高频、范围明确的工作。
输入价格最低降到上一代的一折
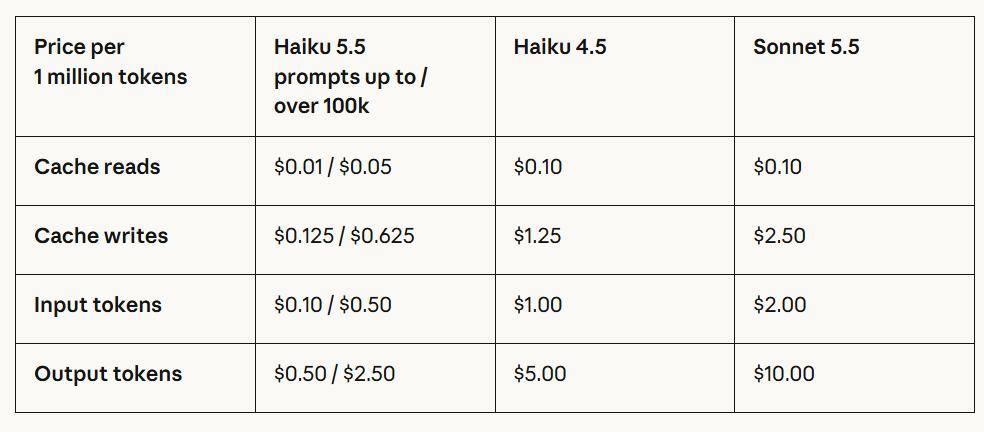
价格是这次发布的另一项核心信息。Anthropic 为 Haiku 5.5 设定了两档 API 定价。
对于提示长度不超过 10 万 Token 的请求,Haiku 5.5 的输入、输出单价都比上一代降低 90%;超过这一门槛后,价格仍比 Haiku 4.5 低 50%。Anthropic 表示,上一代 Haiku 约 90% 的请求都在 10 万 Token 以内。结合请求长度和 Token 消耗变化,公司预计 Haiku 5.5 完成同类任务的平均成本下降约 75%。
Anthropic 还更换了新的 tokenizer。根据官方开发者文档,同一段文本在新模型中产生的 Token 数量可能比 Haiku 4.5 多约 30%,具体增幅取决于内容。因此,API 单价下降 90%,并不等于每项任务账单都能同步减少 90%。
Haiku 5.5 也与 GPT-6 Luna 形成直接价格竞争。OpenAI 给出的 Luna 基础定价同样是每百万输入 Token 0.1 美元、输出 0.5 美元,缓存读取价格也与 Haiku 5.5 的低价档一致。
但两家的长上下文计费门槛不同。Haiku 5.5 在提示超过 10 万 Token 后进入更高价格档;GPT-6 Luna 则在输入超过 27.2 万 Token 后才触发长上下文加价。也就是说,在 10 万到 27.2 万 Token 的请求区间里,Luna 的单位 Token 价格更有优势。
VentureBeat 列出的同期 API 价格还显示,Google Gemini 3.5 Flash-Lite 每百万输入 Token 价格为 0.3 美元、输出 2.5 美元;Gemini 3.8 Flash 分别为 0.75 美元和 3.75 美元。这些数据反映出低价模型之间的 API 价格竞争仍在加剧。
企业场景指向高频、低成本调用
Anthropic 给出的适用场景包括文档摘要、信息分类、数据库查询、上下文压缩,以及在复杂 Agent 工作流中担任 Subagent。
公司给出的案例显示,一些企业正在让小模型承担大模型工作流中的局部任务,以控制调用成本。金融 AI 公司 Rogo 介绍,在其工作流中,一个能力更强的大模型负责制作财务演示文稿;处理其中某张幻灯片时,Haiku 5.5 作为 Subagent 进入企业 10-K 年报,找到需要的业务收入数据,再把结果交给主模型。Rogo 认为,Haiku 5.5 在准确率、速度和价格之间达到了适合大量重复调用的平衡。
企业内容管理平台 Box 也披露了早期测试结果。相比 Haiku 4.5,Haiku 5.5 的内部评测成绩提高 11 分,延迟下降约 50%。Box 认为,这让新模型适合成本报告、财务摘要、周期性审查等需要规模化运行的分析工作,不过该公司没有公开完整评测标准。
Asana 的测试覆盖 Bug 分类、项目建立、大型项目组合搜索等 Agent 任务。按其披露结果,相比当前使用的模型,Haiku 5.5 让任务完成延迟降低超过 30%,单轮 Agent 推理速度最高提升 2.5 倍。
另一个例子来自 AlphaSense。该公司的 Ask in Document 功能每周需要处理约 800 万次调用,主要回答针对一份或几份文档的具体问题。在 400 个测试查询中,Haiku 5.5 的内部评测得分为 0.84,Haiku 4.5 为 0.76。
这些数据都来自 Anthropic 披露的早期客户反馈,不同企业的工作负载、对照模型和评价标准并不完全一致。
Sonnet 5.5 同步降价并新增订阅 API 额度
Anthropic 还同步调整了 Sonnet 5.5 的价格。从 10 月 7 日起,Sonnet 5.5 的缓存读取费用降低 50%,从每百万 Token 0.2 美元降至 0.1 美元。
Anthropic 预计,这项调整可让多数 Agent 工作负载的成本再下降约 20%,实际降幅取决于应用重复使用缓存上下文的程度。对于需要反复读取长对话历史、工具说明和任务上下文的 Agent,缓存成本会直接影响长期运行开销。
订阅方案方面,Anthropic 为 Claude Max 和 Team 用户提供每月 API 额度:Max 5x 用户 100 美元,Max 20x 用户 200 美元,Team 用户共享最高 500 美元。这些额度可用于 Claude 平台上的模型调用。
开发者侧,Haiku 5.5 已通过 Anthropic API、Amazon Bedrock、Google Cloud 和 Microsoft Azure 提供服务,API 模型 ID 为 claude-haiku-5-5。Anthropic 也更新了 Python 和 TypeScript SDK,新增处于 Beta 阶段的浏览器操作与计算机操作支持。
Claude 5.5 系列完成分工
随着 Haiku 5.5 发布,Anthropic 对 Claude 5.5 系列的产品定位也更明确:Opus 5.5 面向高难度、复杂推理任务,Sonnet 5.5 覆盖日常复杂工作与编程,Haiku 5.5 则主打调用量大、成本敏感、需要快速响应的任务。
从 9 月 22 日到 10 月 7 日,Anthropic 用 15 天完成这一轮产品更新,三个型号都在强调性能与成本效率。按 Anthropic 与引用媒体披露的数据,Haiku 5.5 的核心卖点集中在更低单价、可调节推理强度,以及在部分 Agent、知识工作和计算机操作测试中的较高成绩。