
北京邮电大学团队提出的 Mixture-of-Top-k Attention(MiTA)试图从更底层的视角重看高效注意力:在 Transformer 架构里,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)通常被视为功能不同的两个模块,前者负责词元之间的交互,后者对每个词元做非线性变换。但论文指出,若把标准注意力公式展开,它也可以写成一个 FFN,只是这个网络的权重不是训练后固定下来的慢权重,而是由当前输入生成的快权重;与此同时,它的隐藏层宽度会随着序列长度增长。
这一定义带来一个直接结论:长上下文的计算开销,不只是因为词元变多,也因为对应的快权重网络在不断变宽。围绕这个问题,团队将已有的快权重(Fast Weights)视角进一步系统化,提出一套五维分类框架,并基于这一框架设计出 MiTA。该工作已被 NeurIPS 2026 接收,论文和代码均已公开。
把注意力写成 FFN,差别在权重来源与网络宽度
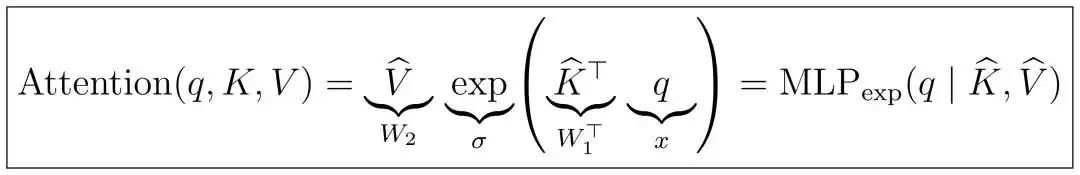
文章将常见 FFN 中使用的两层多层感知机(Multi-Layer Perceptron,MLP)与标准注意力并列比较。将 Softmax 展开后,再把缩放和依赖查询的归一化吸收到权重中,可以得到一组直接的对应关系:查询对应输入,变换后的键和值对应两层权重,指数函数对应激活函数,偏置为零,而隐藏层宽度则从传统 FFN 的 D 变成序列长度 N。
在这个表述下,普通 FFN 使用的是训练得到的慢权重(Slow Weights);注意力机制则把当前输入生成的 K、V 作为随上下文变化的快权重。更关键的一点在于宽度。每一个键值对都可以视作一个隐藏单元,上下文越长,这个快权重 MLP 就越宽。每个查询需要访问 N 个隐藏单元,而处理 N 个查询时,总体开销也随之增长。
由此,论文把高效注意力方法统一成一个问题:如何让一个持续扩大的快权重网络仍然具备可扩展性。
高效注意力的两条主线:压缩与路由
围绕这个越来越宽的网络,文中把现有高效注意力方法归纳成两条主要路线。
第一条是压缩,也就是把宽网络变成更紧凑的模块。线性注意力(Linear Attention)会把键值信息压缩到共享线性层,Linformer 将其映射为更窄的 MLP,测试时训练(Test-Time Training,TTT)则学习紧凑的快权重模块。这一路线的特点是能够提供全局概括,但很难直接读取原始键值对中的细节。
第二条是路由,也就是保留原始内容,只访问需要的部分。做法是把键值子集组织成快权重专家(Fast-Weight Experts),再让查询按需选择。这些专家由当前上下文中的键值对构成,优点是能保留被选内容的原始细节,代价则是对完整上下文的概括能力较弱。
论文给出的图 1 将这两个方向放到了同一张图里:随着上下文增长,快权重 MLP 会越来越宽;路由是从中选择一部分,压缩则是构造更紧凑的表示。
在此基础上,团队进一步提出五维分类框架,维度包括扩展策略(Scaling Strategy)、专家数量(Expert Count)、专家类型(Expert Type)、专家构造方式(Expert Construction)与路由拓扑(Routing Topology)。论文认为,这套框架既能梳理已有方法,也能把问题落到更具体的设计层面,例如专家由什么信息构造、需要多少个、哪些查询可以复用同一位专家。
MiTA 的问题意识:Top-k 集合是否必须一问一选
在分块混合专家注意力方法里,论文以 MoBA 等分块 Mixture-of-Experts Attention 为例说明,常见流程是先把序列切成连续且不重叠的块,再为每个块生成路由向量,让查询按需选择。这样做的局限在于,路由可以随查询变化,但专家边界通常是预先固定的。在图像任务中,同一目标相关的信息未必会落在同一个矩形块内,为了读取少量有用内容,查询可能仍然要访问整个块。
另一类方法是 Top-k 注意力。它让每个查询独立选择最相关的 k 个键值对,摆脱了固定块形状的约束,但代价是 N 个查询对应 N 套私有集合。即便不同查询关注的是相近内容,也要分别完成选择和组织。
MiTA 的切入点就在这里:是否可以保留 Top-k 选择的灵活性,同时让这部分选择结果被多个查询复用。
论文的答案是先不固定专家内容,而是先从输入中提取少量代表性查询,再由这些查询从完整上下文里挑选内容,构成数量可调的专家。这样,原始查询只需要选择访问哪个专家,而不必各自生成一套全局 Top-k 集合。
MiTA 如何构造专家:少量地标查询,同时负责概括与检索
MiTA 通过局部平均池化(Average Pooling)先提取 m 个地标查询(Landmark Queries)。这些地标会探查完整序列,并同时承担两个任务:一是对全局信息做汇总,二是从原始上下文中检索细节。
在路由专家部分,第 i 个地标查询会与所有键进行匹配,选取相关性最高的 k 个位置,这些键值对共同组成第 i 个路由专家(Routed Expert)。论文强调,这种专家可以跨越不同空间位置,形状会随着输入内容变化,不同专家之间也允许重叠。
随后,原始查询会选择与自己最匹配的地标所对应的专家。这样一来,不同查询共享同一组候选键值集合,但各自的注意力权重仍然独立计算。
在共享专家部分,MiTA 使用同一组地标查询通过交叉注意力(Cross-Attention)读取完整上下文,得到对应的地标值。再把地标查询作为键、地标值作为值,就形成全局共享的键值对。最终,MiTA 包含 m 个路由专家和 1 个共享专家:前者保留原始细节,后者提供全局概括。
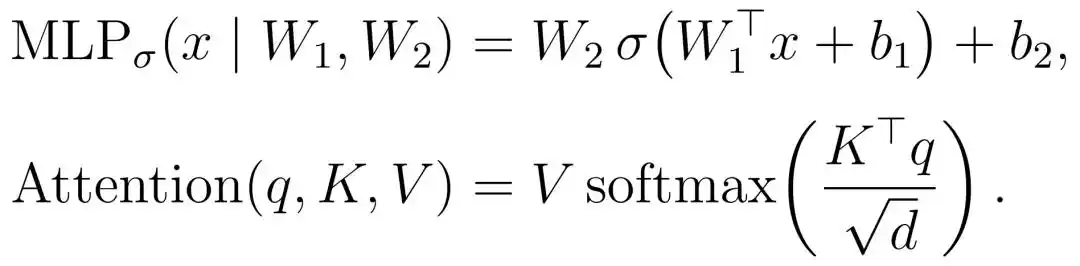
论文在 s=1 的配置下,让每个查询选择一个路由专家,再把该专家对应的键值对与共享专家的键值对拼接,在同一次注意力中使用统一的 Softmax 归一化。这样,Top-k 选择和全局汇总可以共享地标打分,查询到地标的打分也能够复用于路由过程,压缩与路由不仅功能互补,也共享部分计算。
以 ImageNet-1K 中 m=k=25 为例,每个查询最终访问 25 个压缩键值对与 25 个原始键值对,总计 50 个;而扫描完整序列与构造 Top-k 集合的工作则集中由少量地标完成。
论文给出的算法 1 先构造专家,再按路由结果将查询分组计算,并通过在线 Softmax(Online Softmax)合并结果。其结果是,查询—专家注意力开销从原始形式下降,并可通过 FlashAttention 与按专家分组计算继续加速。
ImageNet-1K:基础版 MiTA 接近完整注意力
在 ImageNet-1K 图像分类实验中,团队首先沿用相同的 DeiT 训练配置,对不附加额外组件的注意力机制做比较。
结果显示,在 DeiT-S 上,基础版 MiTA 的 Top-1 准确率为 79.8%,完整注意力为 79.9%,两者相差 0.1 个百分点;参数量保持不变,浮点运算量(FLOPs)则从 4.6G 降到 4.4G。在同一设置下,Agent Attention 为 78.5%。
若加入视觉高效注意力中常见的额外组件,MiTA 的数值继续提升。加入逐通道卷积(Depth-Wise Convolution,DWC)后,MiTA 达到 80.6%;在此基础上再加入门控(Gating)后达到 81.2%。论文特别说明,这些属于常见的额外增益手段,也在结果中如实展示。
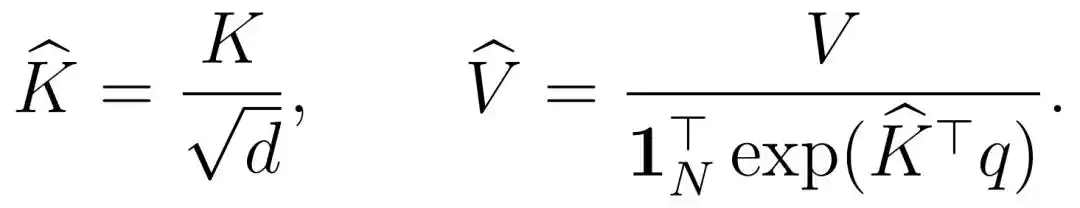
进一步结合 ViT-5 架构设计并加入 DWC 后,MiTA-ViT-5-S 达到 81.7%,而 ViT-5-S 为 82.2%,相差 0.5 个百分点,FLOPs 从 4.7G 降到 4.5G。
ADE20K:长视觉序列下减少计算
在 ADE20K 语义分割任务中,团队将预训练 ViT 的注意力模块替换为 MiTA,再训练分割模型。设置 m=k=49 时,每个查询仅访问 98 个键值对,而完整注意力在两种输入分辨率下分别需要访问 1,024 或 1,600 个键值对。
以 ViT-S+CBT 为例,FLOPs 从 33G 降至 25G,降幅约 24%,平均交并比(Mean Intersection over Union,mIoU)从 45.8% 变为 44.5%。在 ViT-T 配置中,FLOPs 降幅约为 42%,mIoU 下降 2.6 个百分点。
LRA:平均准确率略高,训练时间降至 2.4 小时
在长序列基准 Long Range Arena(LRA)的五项任务上,MiTA 的平均准确率为 58.91%,完整注意力为 58.19%;总训练时间则从 10.6 小时缩短至 2.4 小时,减少约 77%。
这组测试在单张 24GB RTX 4090 上完成,完整注意力基线采用 FlashAttention。
论文还提到,压缩分支会减少原始键值对的收集(Gather)开销。在每个查询访问条目数相同的消融实验中,相比仅使用路由版本,加入压缩分支后,训练时间从 5.5 小时缩短到 2.4 小时,平均准确率从 58.81% 提升到 58.91%。
在推理吞吐量测试中,论文使用三层、嵌入维度 128 的 Transformer,在 RTX 4090 上比较不同序列长度下的速度,MiTA 设置为 m*k≈N/4,并在各配置下调整批大小以最大化吞吐量。随着序列长度增长,MiTA 的优势进一步扩大:在 64K、256K 和 1024K 长度下,相比完整注意力的加速比分别约为 19 倍、56 倍和 159 倍。
长文档分类:16K、32K、64K 均领先表中其他方法
在 arXiv 长文档分类任务中,模型需要识别长篇论文的类别,既要理解全文,也要捕捉分散在文中的细粒度线索。论文认为,这类任务正好能够检验全局概括与细节检索是否可以同时成立。
结果显示,在 16K、32K 和 64K 长度下,MiTA 的准确率分别为 88.0%、92.9% 和 98.7%,均高于表中其他方法。与标准注意力相比,分别提高 18.2、3.2 和 1.7 个百分点。
两个额外观察:涌现剪枝效应与推理预算可调
除主实验外,论文还提到两个值得关注的现象。
第一,在没有额外剪枝模块的前提下,MiTA 会随着网络加深逐渐聚焦目标。被选入路由专家的键值位置会越来越集中在与类别相关的区域,背景位置被选中的比例逐层下降,形成论文所称的涌现词元剪枝效应(Emergent Token-Pruning Effect)。图 5 中,最左列为输入图像,其余列展示各层被选入专家的键值位置,并在注意力头之间做了聚合;后层会逐渐聚焦到类别相关区域。未被选中的背景词元仍可通过压缩分支参与全局汇总。
第二,MiTA 的权重可以复用,推理预算也可以调整。论文在冻结模型参数后,仅在推理阶段替换注意力机制,结果显示 MiTA 与完整注意力之间存在较好的相互兼容性。
进一步地,将完整注意力预训练的 ViT 替换为 MiTA,并在 ImageNet-1K 上微调后,ViT-S 与 ViT-L 分别达到 80.9% 和 85.5%,与完整注意力仅相差 0.3 和 0.4 个百分点。论文还指出,在保持模型参数不变的前提下,只调整推理时的专家数量 m 与专家宽度 k,合适的配置甚至可以进一步提高准确率。文中将这一现象概括为算法泛化(Algorithmic Generalization),并认为这为训练阶段控制成本、推理阶段按需调整预算提供了空间。
从重新定义 Attention,到扩展高效注意力的设计边界
文章最后回到最初的问题:把 Attention 写成 FFN 的价值,不只是两个公式之间存在对应关系,更在于它为注意力效率问题提供了一组新的设计维度。按照论文的表述,压缩决定如何保留全局信息,专家构造决定哪些原始内容应当被组织到一起,路由则决定哪些查询可以复用这些内容。过去在 FFN 中研究过的问题、积累过的设计经验,也因此有机会反过来影响注意力机制的后续发展。
这项工作给出的不只是一个新的高效注意力变体,也是一种面向底层架构设计的视角重组。
参考资料:
- 论文地址:https://arxiv.org/pdf/2602.01219
- 代码仓库:https://github.com/QishuaiWen/MiTA
本文来自微信公众号「新智元」,作者:新智元。