开放权重 AI 模型与最强闭源模型之间的差距,平均已经缩小到约 4 个月。与此同时,能在普通消费级硬件上运行的模型也在增加。Decrypt 在一篇指南中介绍了如何直接在个人电脑上下载并运行 AI 模型,以及这样做在隐私、成本和可定制性上的意义。
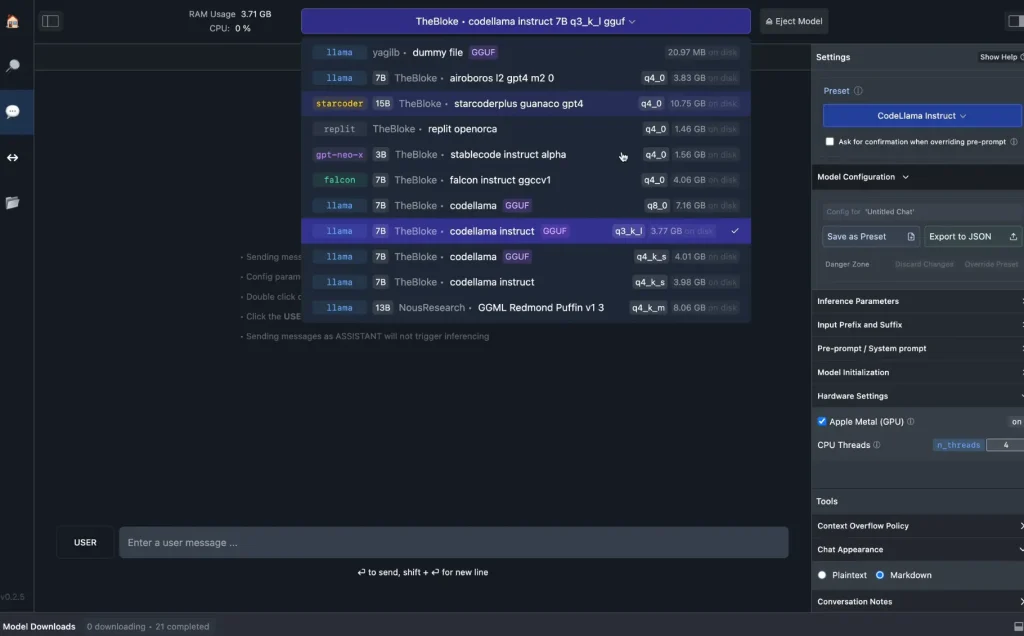
文中解释,「开放权重」指模型开发方公开模型权重,也就是保存模型训练结果的文件,任何人都可以下载并在本地运行。对于普通用户,Ollama 和 LM Studio 这两款免费工具可以处理大部分部署流程。以 Gemma 4 为例,Ollama 库中的下载体积大约在 4.6GB 到 20GB 之间。
这类本地部署方式不需要每月支付约 20 美元的 AI 订阅费用,也不必把对话内容发送到第三方服务器。Decrypt 这篇文章的重点,是说明如何在电脑上直接运行 AI 模型、需要什么硬件,以及如何用 Ollama 和 LM Studio 这样的免费工具开始使用。
报道提到,用户选择本地 AI 助手,常见原因包括节省成本、保护对话隐私,以及尝试可自行定制的模型。
为什么有人想把 AI 模型放在本地运行
云端聊天机器人会把每一次提示词发送到公司的服务器。Decrypt 在此前一篇聚焦隐私型 AI 工具的评测中提到,法院曾要求 OpenAI 保留 ChatGPT 日志,包括已删除的记录。相较之下,本地模型把对话保留在用户自己的电脑上,未经许可,其他人无法使用这些内容。
LM Studio 的文档写道,这款应用「可以完全离线运行,只要先获取一些模型文件」,附加到聊天中的文档也可以在完全离线状态下使用。
在成本方面,付费聊天机器人订阅通常约为每月 20 美元,而文中提到的软件本身免费。成本更多转移到硬件上,而这部分设备用户可能已经拥有。
不过,下载模型权重后能做什么,取决于具体授权协议。文章列举称,DeepSeek 的 R1 系列采用 MIT License,其模型卡写明这些模型「支持商业使用,并允许任何修改和衍生作品」;Google 的 Gemma 4 和 OpenAI 的 gpt-oss 则采用 Apache 2.0。
如果模型采用 Apache 或 MIT 这类开放源码许可,用户可以使用、修改并按自身需求调整模型。Decrypt 认为,这意味着用户可以接触到经过改进或定制的版本,以适配更具体的用途。文中举例称,如果用户更看重医学能力,而不在意代码表现,那么定制模型会更合适;这种个性化能力,只有在可定制模型中才具备。
本地硬件到底能跑什么模型
模型规模通常以参数量衡量,也就是训练过程中不断调整的内部数值。参数越多,下载体积通常越大。模型需要装进显卡显存,也就是 VRAM;如果是 Mac,则需要装进统一内存,也就是处理器和图形芯片共享的内存。
文章给出的经验规则是,至少需要 8GB VRAM,经过压缩的小模型可以装进去。若是更重度的用户,则应考虑配备 24GB 或以上 VRAM 的游戏显卡,方式可以是堆叠多张 GPU,或者直接购买专门的 AI 机架设备,或采用统一内存架构的机器,例如 Mac Mini 或 Nvidia DGX Spark。
量化是缩小模型体积的一种方式,做法是用更少的比特存储每个权重。Hugging Face 文档将其描述为,用 8 位整数(int8)这类低精度数据类型来表示权重和激活值,而不是常见的 32 位浮点数(float32)。这样可以降低内存占用,但会牺牲一部分精度。
LM Studio 的系统要求显示,在搭载 Apple Silicon、运行 macOS 14 或更新版本的 Mac 上,建议至少配备 16GB 内存,不过 8GB 的 Mac 也能运行更小的模型。在 Windows 平台上,LM Studio 建议至少 16GB 内存、4GB 独立显存,并要求处理器支持 AVX2;基于 Intel 的 Mac 不受支持。
具体到模型体积,Ollama 库列出的 Gemma 4 26B 版本约为 16GB 到 19GB,31B 版本约为 19GB 到 20GB。OpenAI 则称,gpt-oss-20b 只需要 16GB 内存,gpt-oss-120b 可在 80GB 内存范围内运行。
如何安装和使用 Ollama 与 LM Studio
Decrypt 认为,LM Studio 更适合作为多数用户的首选,因为它提供了较完整的图形界面。相比之下,Ollama 更偏向开发者和更熟悉终端命令行的用户。
使用 LM Studio 时,用户可以先从 lmstudio.ai 下载对应操作系统的安装程序,然后在应用内搜索模型、下载权重并直接打开聊天界面。文章指出,这款应用会搜索 Hugging Face,也就是开放模型发布的公共平台。
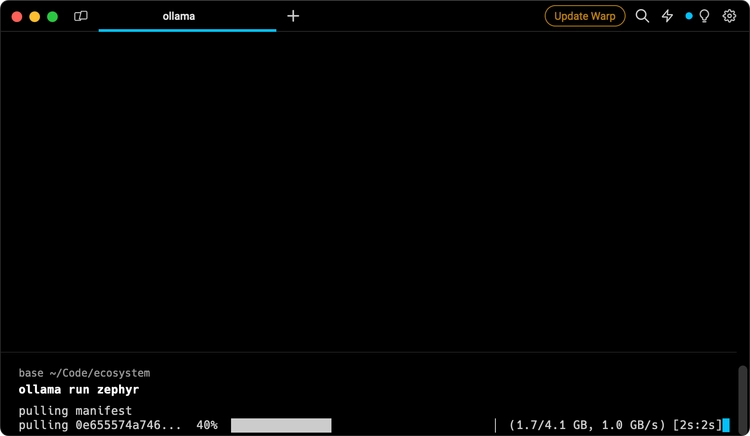
使用 Ollama 时,macOS 和 Linux 用户可通过命令 curl -fsSL https://ollama.com/install.sh | sh 安装;Windows 用户则在 PowerShell 中运行 irm https://ollama.com/install.ps1 | iex。这些命令都列在 Ollama 的下载页面中。
安装完成后,输入 ollama pull gemma4:e2b 可以下载模型,输入 ollama run gemma4:e2b 可以打开聊天,输入 /bye 退出。根据 Ollama 的快速入门文档,程序还会在本地打开一个 API,地址为 http://localhost:11434,这样电脑上的其他应用也可以调用该模型。
文章提醒,模型名称如果以「:cloud」结尾,例如 gemma4:cloud,代表它们是运行在 Ollama 云端的云模型,不需要下载。如果用户的核心诉求是隐私,就应跳过这类模型。不过文中也提到,这可以作为需要更强模型时的第二选择:通过 API 处理的调用和提示词不会存储在服务提供商服务器上,也不会被用于训练模型。
Google 为 Gemma 4 提供的 Multi-Token Prediction 草拟器也已在 Ollama 上提供,采用 Apache 2.0 许可。文章称,这项功能通过 speculative decoding 最多可将生成速度提升 3 倍,其原理是先由一个较小模型提前提出多个 token,再由大模型统一检查。
Google 表示,「如果目标模型同意草稿内容,它会在一次前向传播中接受整个序列」,并且目标模型会在同一次前向传播中额外生成一个自己的 token。
本地模型还可以通过 MCP 服务器获得网页搜索和文件访问能力。MCP 是 Model Context Protocol 的缩写。根据 Decrypt 的指南,LM Studio 已在 0.3.17 版本中加入对 MCP 的支持。
本地模型仍落后于云端的地方
文中所说平均 4 个月的差距,针对的是能力最强的一批开放模型。但最大的模型规模,仍远超普通消费级硬件可承受范围。以阿里巴巴的 Qwen3.8-Max 为例,该模型总参数量为 2.4 万亿,其中任一时刻激活参数为 950 亿;作为对比,OpenAI 所说可在 80GB 内存内运行的 gpt-oss-120b,硬件需求已经不低。
如果模型无法完全装入显存而溢出到系统内存,响应速度可能明显下降。更大的上下文窗口也会占用更多内存。Gemma 4 的小型模型提供 128K token 上下文窗口,也就是模型一次可处理的文本量;更大的版本则提供 256K。
云端服务不需要用户自己规划这些硬件和内存问题,而且其背后的前沿模型,在最困难的测试中仍然领先。
对于希望以更私密方式使用 AI 的用户,Decrypt 在自家评测中建议,日常那些绝不能离开本机的写作任务,可使用「xPrivo 搭配自托管本地模型」;如果需要网页检索,并接受 API 调用带来的取舍,则可选择 Kagi。