


Google DeepMind 披露,PyTorch、JAX 以及多种教材中的 Softmax 和交叉熵标准实现都存在数值计算缺陷。按 DeepMind 的说法,这些实现会在浮点运算中把一个极小数字舍入为 0,导致模型越自信,正确训练信号越容易消失,训练过程随之出现震荡。
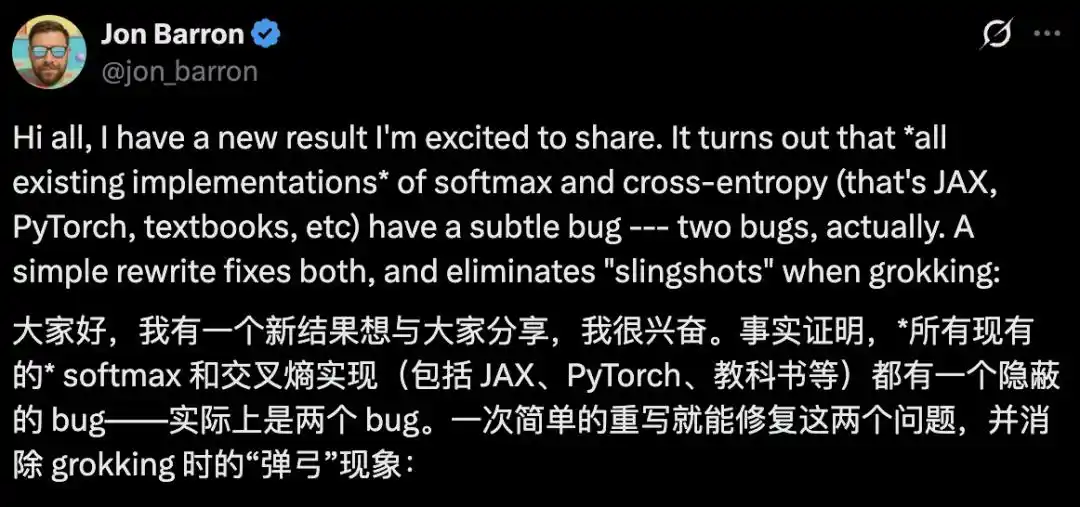
提出这一问题的是 Google DeepMind 主任研究科学家 Jon Barron。DeepMind 团队在 arXiv 提交的论文题为《Softmax和交叉熵的修复》,文中将其中一类问题称为「Softmax 崩溃(Softmax Collapse)」。
问题出在 Softmax 和交叉熵的标准写法
Softmax 用来把模型输出的原始得分 logits 转成概率,交叉熵则负责计算误差。在分类器和大语言模型中,这两个函数都会被大量调用。
DeepMind 指出,为了避免计算溢出,现有标准框架通常会先减去最大得分。这样一来,分母会变成类似「1 + 极小数字」的形式。这个极小数字会随着模型置信度上升而继续变小。
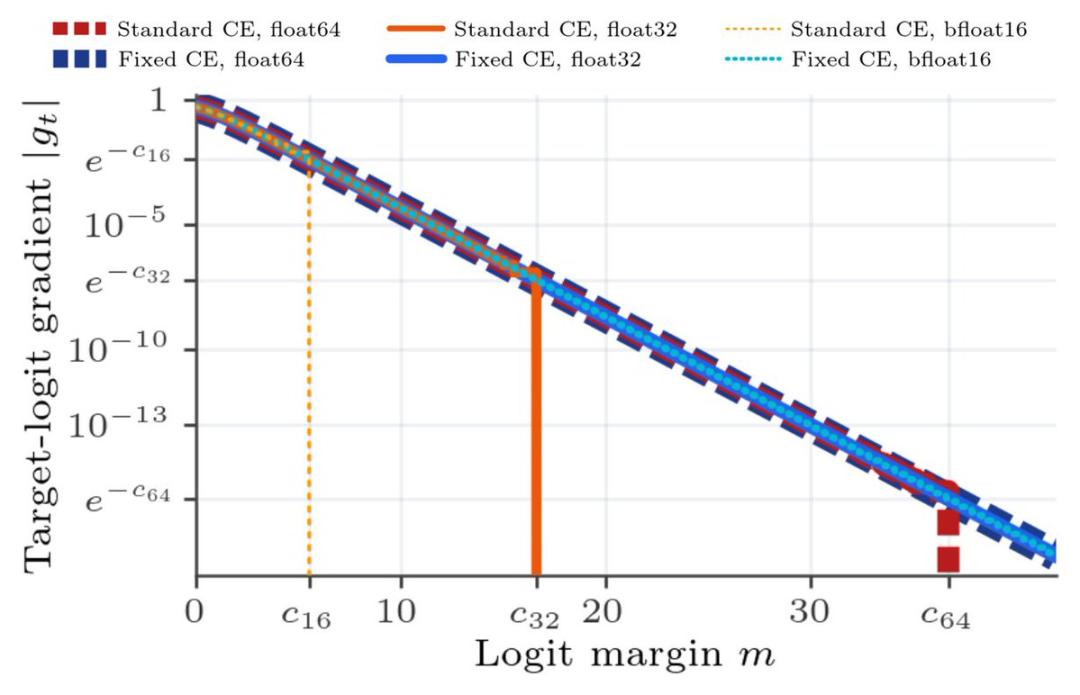
数学上等价的表达式,在计算机浮点数里不一定得到等价结果。如果一个足够小的数字被加到 1.0 上,计算机会直接把结果舍入成精确的 1.0。论文称,在 bfloat16 格式下,这个临界点大约出现在 5.5;在 fp32 下,大约出现在 16.6。
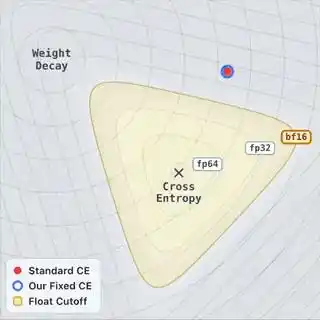
一旦跨过这个临界点,正确类别对应的梯度会直接变成 0。模型仍在训练,但关于正确答案的反馈信号已经被舍入机制抹掉。
梯度归零后,Adam 会把波动放大
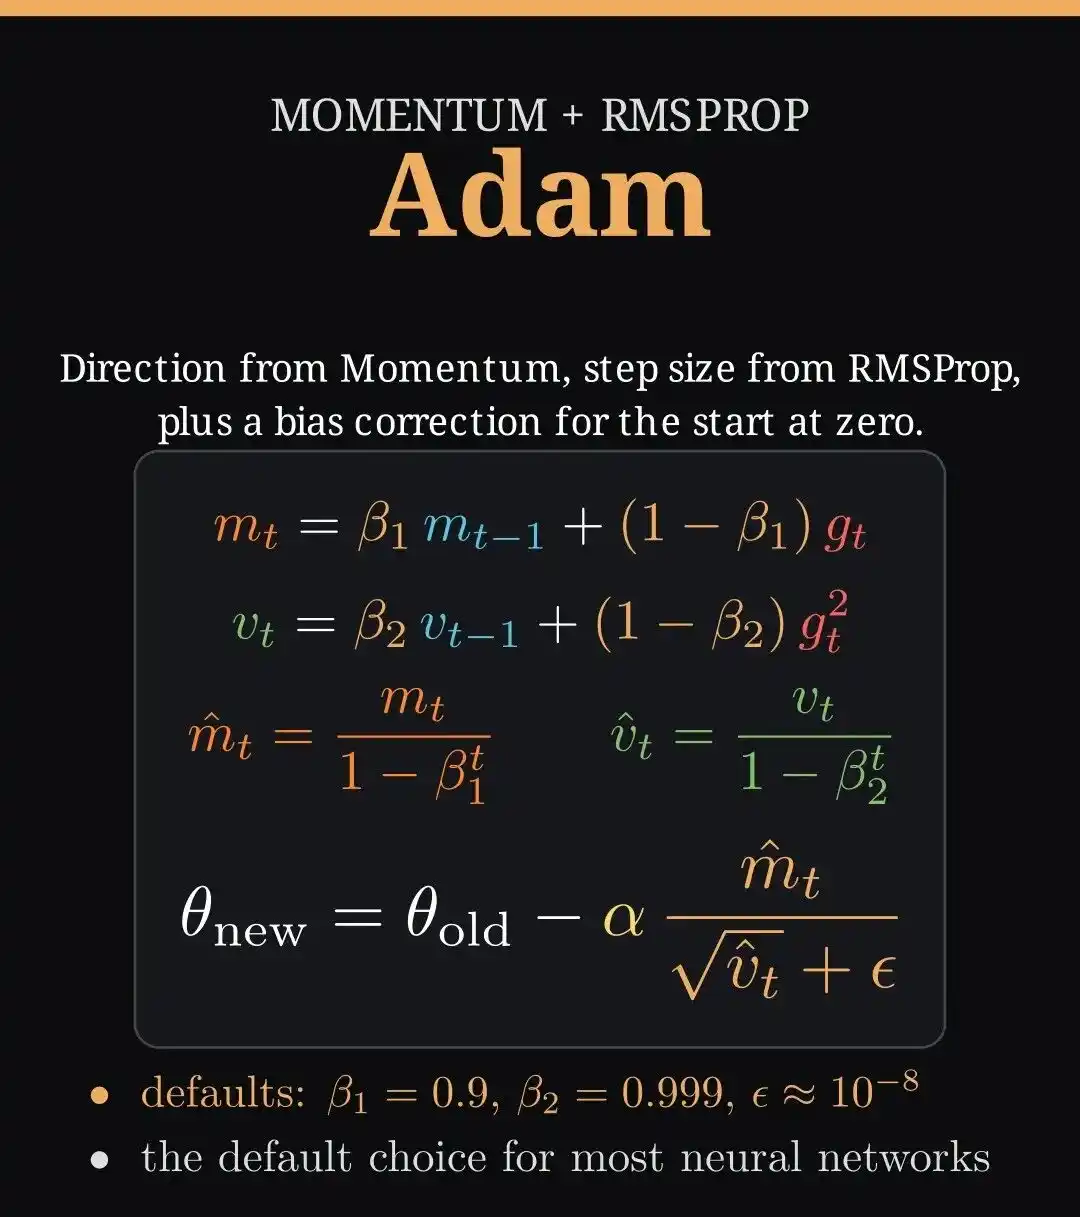
论文称,主流优化器 Adam 会让这个问题变得更明显。Adam 的更新方式依赖近期梯度的平均值;如果梯度长时间因为上述缺陷变成 0,这个平均值也会不断逼近 0。
等到真实梯度重新出现时,Adam 会用这个梯度去除以一个极小的数字,结果就是参数更新突然放大,损失函数瞬间飙升。
学术界此前观察到类似现象,并将其称为「弹弓效应(Slingshots)」,一度把它视为模型在「顿悟(Grokking)」过程中的某种特征。按照这篇论文的说法,这一现象背后至少有一部分并不是特征,而是实现层面的 Bug。
另一类问题是「Softmax 抵消」
除了梯度崩溃,论文还提到「Softmax 抵消(Softmax Cancellation)」。这一问题出现在知识蒸馏场景中。
理论上,如果学生模型完全复制了教师模型,梯度应该为 0。但标准代码通常会先分别计算概率,再做相减。DeepMind 认为,这一步会留下由舍入误差带来的「幽灵梯度」,使学生模型偏离本应保持一致的目标。
团队给出的修复思路是,在对数空间中使用 expm1 和 log1p 计算。这样当学生模型与教师模型完全一致时,梯度可以保持为绝对 0,不再留下残余误差。
Barron 在 X 上公布修复思路
Barron 在 X 平台表示:「事实证明,所有现有的 Softmax 和交叉熵实现(包括 JAX、PyTorch、教科书等)都有一个微妙的 Bug——其实是两个。」
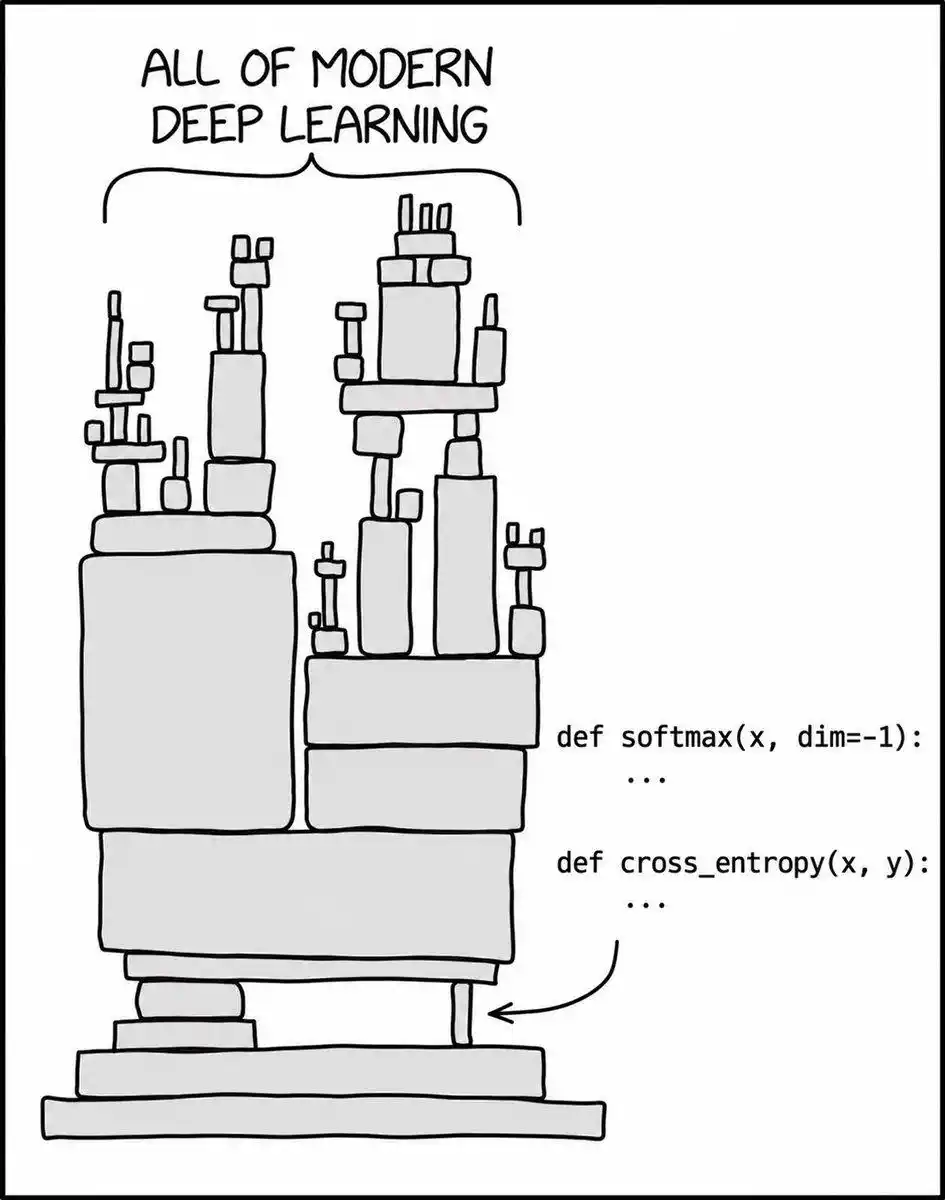
他还写道,简单的重写就能修复这些问题,并消除顿悟过程中的「弹弓效应」。
- 对于交叉熵,也就是修复崩溃问题,做法是把目标项从总和中拿出来,直接用 log-sum-exp 计算边距,再返回负边距的 softplus。核心原则是不要把一个极小数字加到 1 上。
- 对于蒸馏,也就是修复抵消问题,做法是在对数空间中使用 expm1 和 log1p 计算。
论文测试:bfloat16 准确率从 93.3% 升至 100.0%
论文给出的测试数据显示,在模加法任务 a + b mod 31 中,使用标准代码时,bfloat16 精度下的测试准确率为 93.3%,而且波动明显。
换用修复后的实现后,测试准确率达到 100.0%。
在蒸馏测试中,修复后的代码让学生模型与教师模型之间的散度保持为 0,准确率维持在 100%。
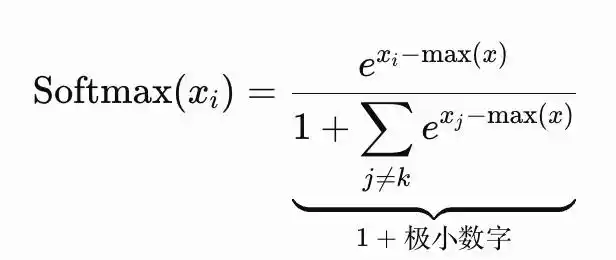
Gemini 被指最初发现并修复该问题
引发更大关注的是 Barron 在评论区补充的一段说明。他写道,这个 Bug 最初由 Gemini Flash 3.7 发现并修复,论文中的大部分实验由 Flash 3.8 完成,Gemini 4 Argon 写了论文和图表的初稿,而他本人主要负责严格审阅和修改。
按这一说法,这次并不是研究人员先发现问题,再让模型辅助整理,而是 Gemini 直接参与了问题识别、修复方案形成以及实验和初稿撰写。
独立工程师在 PyTorch 中复现了这两个 Bug
10 月 24 日,独立工程师 Satyajit Ghana 表示,他已经在 PyTorch 中完成全面复现。
据介绍,他在 CPU 上通过打印出的数值复现了这两个 Bug,移植了修复程序,并确认了论文中 fp32 精度下的结果。
他的结论是:「不管其他细节如何,机制毫无保留地被证实了。」
历史上多次出现「丢数字」带来的代价
文章还回顾了数值误差在计算史上的几次典型案例。
1965 年,多伦多大学的 William Kahan 教授在《ACM 通讯》发文指出,计算机在累加大量数字时,每次加法都会引入舍入误差。按他的说法,如果累加一百万个数,可能会丢掉 6 位有效数字。Kahan 提出的办法是额外保存上一步丢失的误差,并在下一步加回去,这后来被称为 Kahan 求和算法。
他当时写道:「双精度很快就会被普遍接受,用来代替解决数值问题时的聪明才智。」
1991 年海湾战争期间,美国「爱国者」导弹系统未能拦截来袭的「飞毛腿」导弹,导弹击中兵营,造成 28 名美国士兵死亡。美国会计总署后续调查称,系统内部时钟以十分之一秒计时,但在转换为实数时,寄存器只有 24 位长,误差会随着运行时间累积。报道列出的数据是:运行 8 小时后误差为 0.02 秒,对应距离偏差 55 米;运行 100 小时后误差扩大到 0.34 秒,对应距离偏差 687 米。
1994 年 10 月,林奇堡学院数学教授 Thomas Nicely 在计算孪生素数倒数和时,发现奔腾芯片与 486 处理器给出了不同结果。随后他定位到问题出在奔腾处理器浮点除法单元:其查找表缺失了 5 个条目。最终,英特尔同意为所有用户无条件更换芯片,并在 1995 年 1 月为此计提 4.75 亿美元损失。
这篇文章将 DeepMind 这次发现放进同一条脉络中:1965 年,数值误差问题已被明确提出;1991 年,它造成致命后果;1994 年,它带来巨额商业损失;到 2026 年,这类问题再次出现在 AI 最常用的基础函数中。
参考资料
参考资料包括 arXiv 论文《Softmax和交叉熵的修复》以及 Brian Roemmele 在 X 平台转发的相关链接。