
大模型能够接收整份财报、合同或研究报告,并不代表它能正确找到其中与问题相关的信息。EMNLP 2026 接收的论文《Can Retrieval Heads See Images? Multimodal Retrieval Heads in Long-Context Vision-Language Models》从模型内部机制出发,首次锁定了负责多模态证据检索的一类注意力头。
研究聚焦于长上下文视觉语言模型如何在上百页文字、图片、表格和图表中定位答案所需的内容。相关证据可能是一段文字,也可能位于图片、表格或特定版面区域。
从“装得下”到“找得到”
长上下文视觉语言模型可以同时接收大量文字和图片,但最终回答通常只依赖输入中的一小部分信息。研究团队关注的问题是:当证据已经出现在输入中时,模型内部是否存在一组注意力头,负责把问题指向相关的文本或视觉内容?
团队将识别出的这类注意力头称为多模态检索头(MMRetHeads)。
通过问题到证据的注意力识别
受 QRHead 启发,研究团队提出了 MMRetHeads 检测方法。该方法分析每个注意力头的 question-to-evidence attention,即问题 token 指向标注证据区域的注意力。
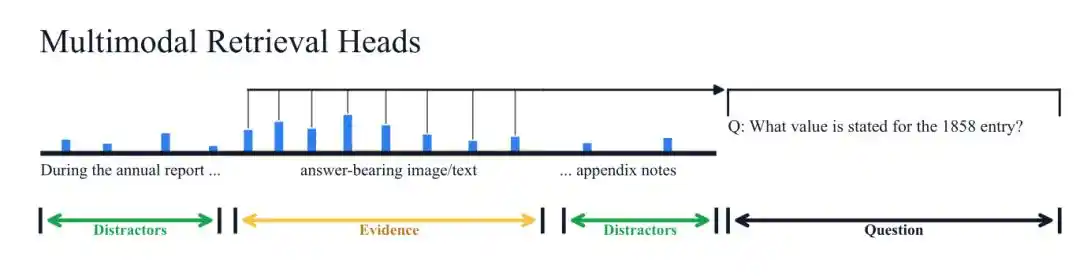
如果证据是文字,目标区域对应文字 token;如果证据位于图片中,则对应视觉 token。注意力头指向证据的强度越高,其检索得分就越高。
研究覆盖 Qwen3-VL、Gemma3 等 6 个长上下文视觉语言模型,测试了文本检索、图像检索、渲染文本检索和相同图像检索等任务。上下文长度包括 8K、16K、32K、64K 和 128K。
分析显示,文本检索和图像检索会共享一部分注意力头,但上下文长度不同、证据形式不同,也会调用不同的注意力头。
屏蔽检索头后,模型表现明显下降
注意力指向证据,只能说明二者存在关联。为了检验模型是否真正依赖这些注意力头,研究团队屏蔽了得分较高的检索头,并将结果与屏蔽相同数量随机注意力头的结果进行比较。
在文字和图片检索任务中,屏蔽检索头后,模型在不同上下文长度和证据位置下的表现显著下降;随机屏蔽带来的影响则小得多。
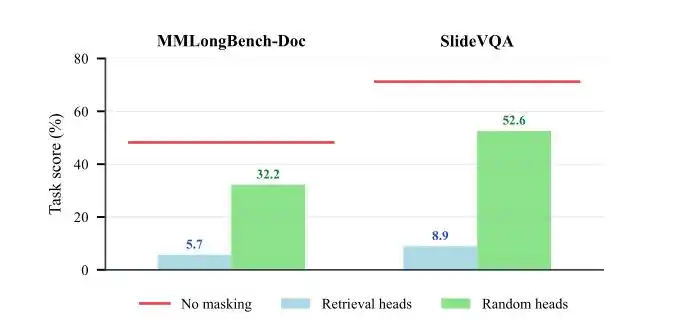
相同差异也出现在更接近真实长文档问答的任务中:
- MMLongBench-Doc:48.2 降至 5.7;
- SlideVQA:71.2 降至 8.9。
随机屏蔽后,两项任务仍分别保留 32.2 分和 52.6 分。屏蔽检索头造成的下降明显更大,研究据此指出,这些注意力头不只是将注意力放在证据附近,也对模型访问证据具有因果作用。
在多模态推理任务中,研究团队也观察到类似结果。检索头被屏蔽后,即使图表仍然存在于输入中,模型有时也会回答“信息不足”;在另一些情况下,模型会读取错误内容,或生成输入中不存在的依据。
检索信号被用于多模态文档检索
研究团队随后将这些注意力头中的证据信号用于多模态文档检索。给定一个问题,MMRetHeads 会为候选页面或版面区域计算相关性分数,再按照分数对候选项排序。整个过程不需要额外训练检索器。
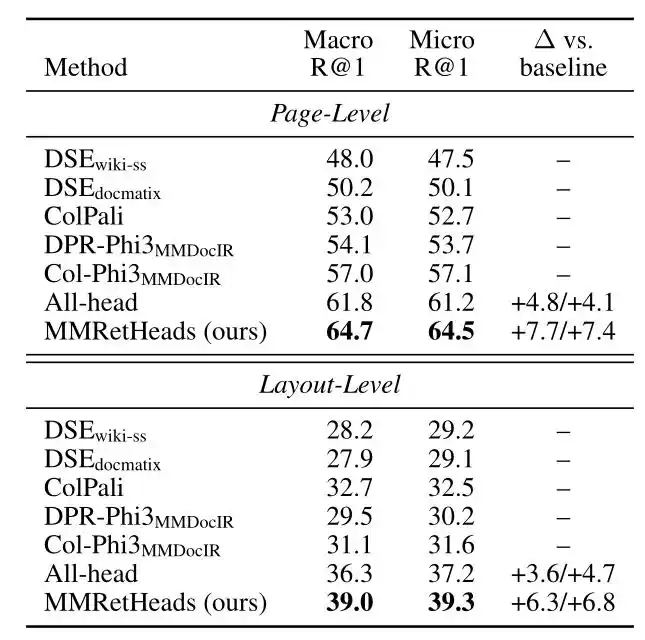
页面级检索用于寻找包含证据的整页;版面级检索则继续定位页面中的文字块、表格、图片或图表。
在 MMDocIR 上,Qwen3-VL-8B 的页面级 Recall@1 达到 64.7,较最强的已报告基线高 7.7 个百分点;版面级 Recall@1 达到 39.0,较最强的已报告基线高 6.3 个百分点。
论文链接:https://arxiv.org/abs/2605.27243
本文来自微信公众号“量子位”,作者:MMRetHeads 团队。