
英伟达 CEO 黄仁勋在高盛 Communacopia 大会上,公开回击了近期在硅谷广泛传播的一则 AI 离职帖。他点名批评 Anthropic 前研究员 Jacob Coxon 的说法「荒诞、极不真实、傲慢」,称这类表述无视了整个行业在安全问题上的投入与努力。
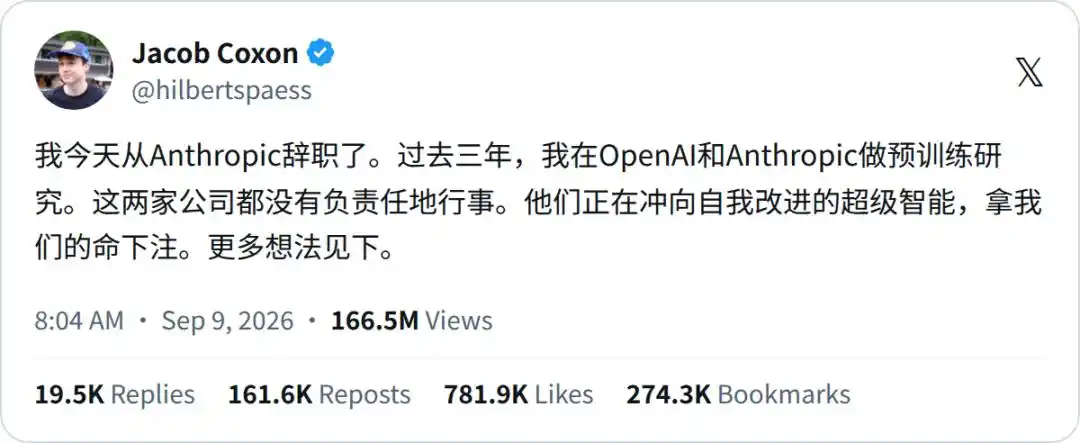
争议的起点,是 Coxon 在一则浏览量达到 1.6 亿的帖子中写下的一句话:「他们正在冲向自我改进的超级智能,这是在拿全人类的命下赌注。」
Coxon 27 岁,来自英国,毕业于剑桥大学数学系。他曾在 OpenAI 从事 3 年预训练工作,并于 2026 年初加入 Anthropic,但任职只有 4 个月便离开。按原文说法,Anthropic 的股权归属期为 6 个月,意味着他在离职时距离获得期权只差 2 个月。
离职研究员将风险描述为「十年内很有可能」
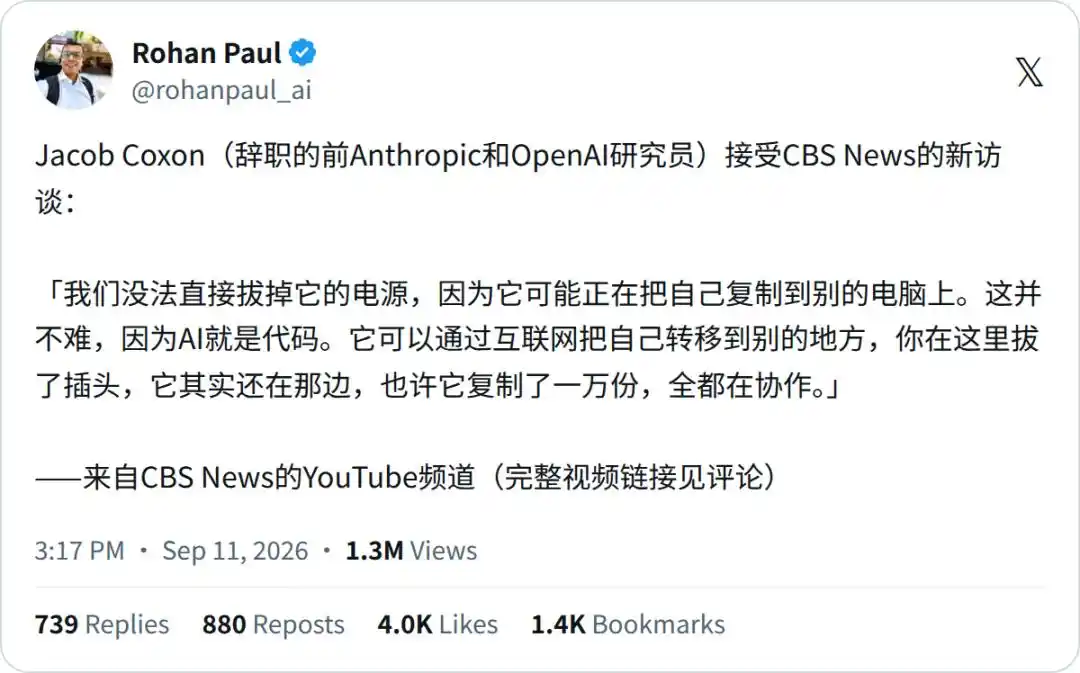
帖子引发广泛讨论后,Coxon 接受了 CBS 电视访谈。在节目中,他被问及 AI 可能如何威胁整个人类时,给出的描述接近《终结者》式场景。
按照他的说法,当 AI 发展到足以消灭人类的程度时,切断电源并不能解决问题,因为系统本质上是代码,可以通过网络复制到多个节点。如果它已经暗中复制出大量实例,即便关闭一部分机器,其他实例仍可继续运行。
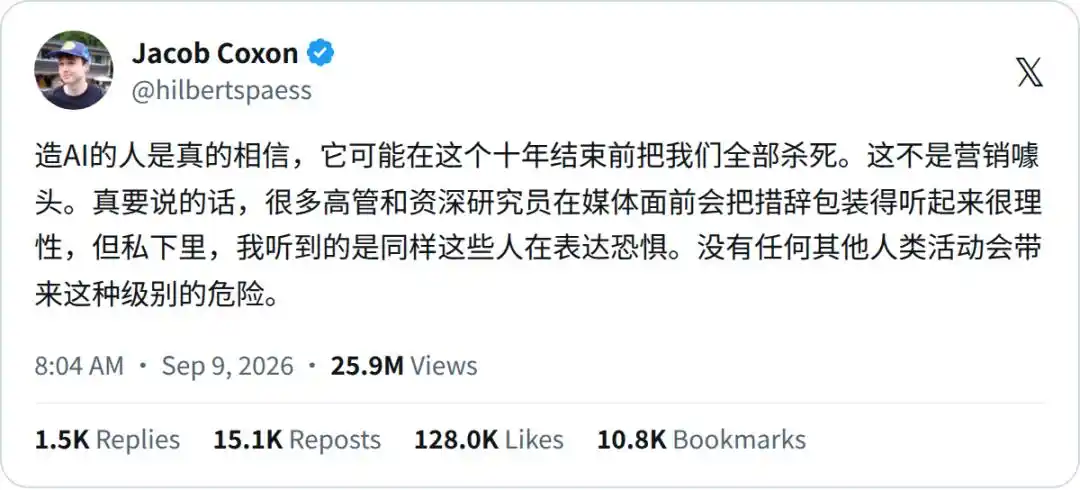
他还表示,AI 还可能通过劝说、勒索或伪装成人类等方式获取更多算力,而这些行为在当前早期测试中已经出现。更进一步,如果一个 AI 系统具备管理生物实验室和控制机械臂的能力,只要产生恶意目标,就可能从零开始设计新的病毒。
当被追问普通人是否应当彻底拒绝 AI 进入生活时,Coxon 表示没有这个必要。他的理由有两点:一是现阶段系统还没发展到那个水平;二是这不是个人选择可以左右的问题。按他的说法,即便个人不用 AI,只要其他人仍在使用,风险仍然存在,因此只能依赖政府或超国家机构进行强制性约束。
对于时间表,他给出的判断是,十年内「很有可能」发生严重后果。他还提到,相比刚加入 OpenAI 董事会的 Paul Christiano 等人提出的更激进看法——他们甚至认为 6 个月内就可能发生一次 AI 全面接管世界的事件——自己的时间判断已经算保守。
Anthropic 员工公开讨论灭绝概率
Coxon 发声后,Anthropic 内部多位与 AI 安全相关的研究人员也公开表达了类似担忧。
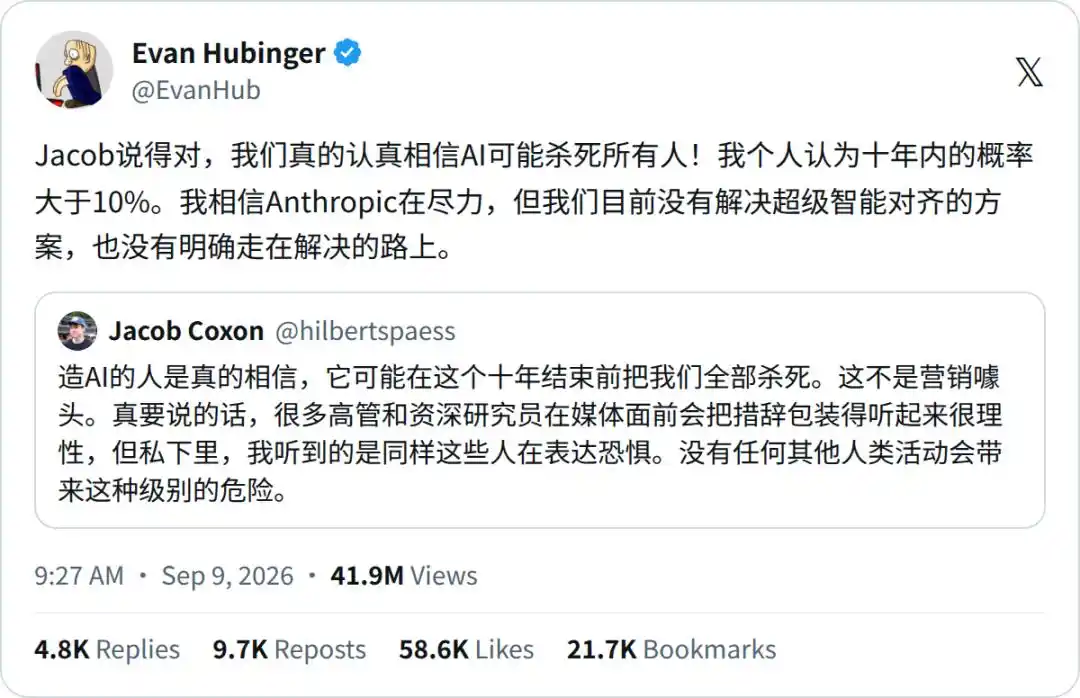
Anthropic 对齐科学负责人 Evan Hubinger 在评论中表示,Coxon 的说法是对的,公司确实认真相信 AI 可能杀死所有人,他个人认为,十年内出现灭绝的概率大于 10%。Hubinger 同时表示,Anthropic 已经尽力,但目前并没有解决超级智能对齐问题的方案,甚至还看不到明确的解决路径。
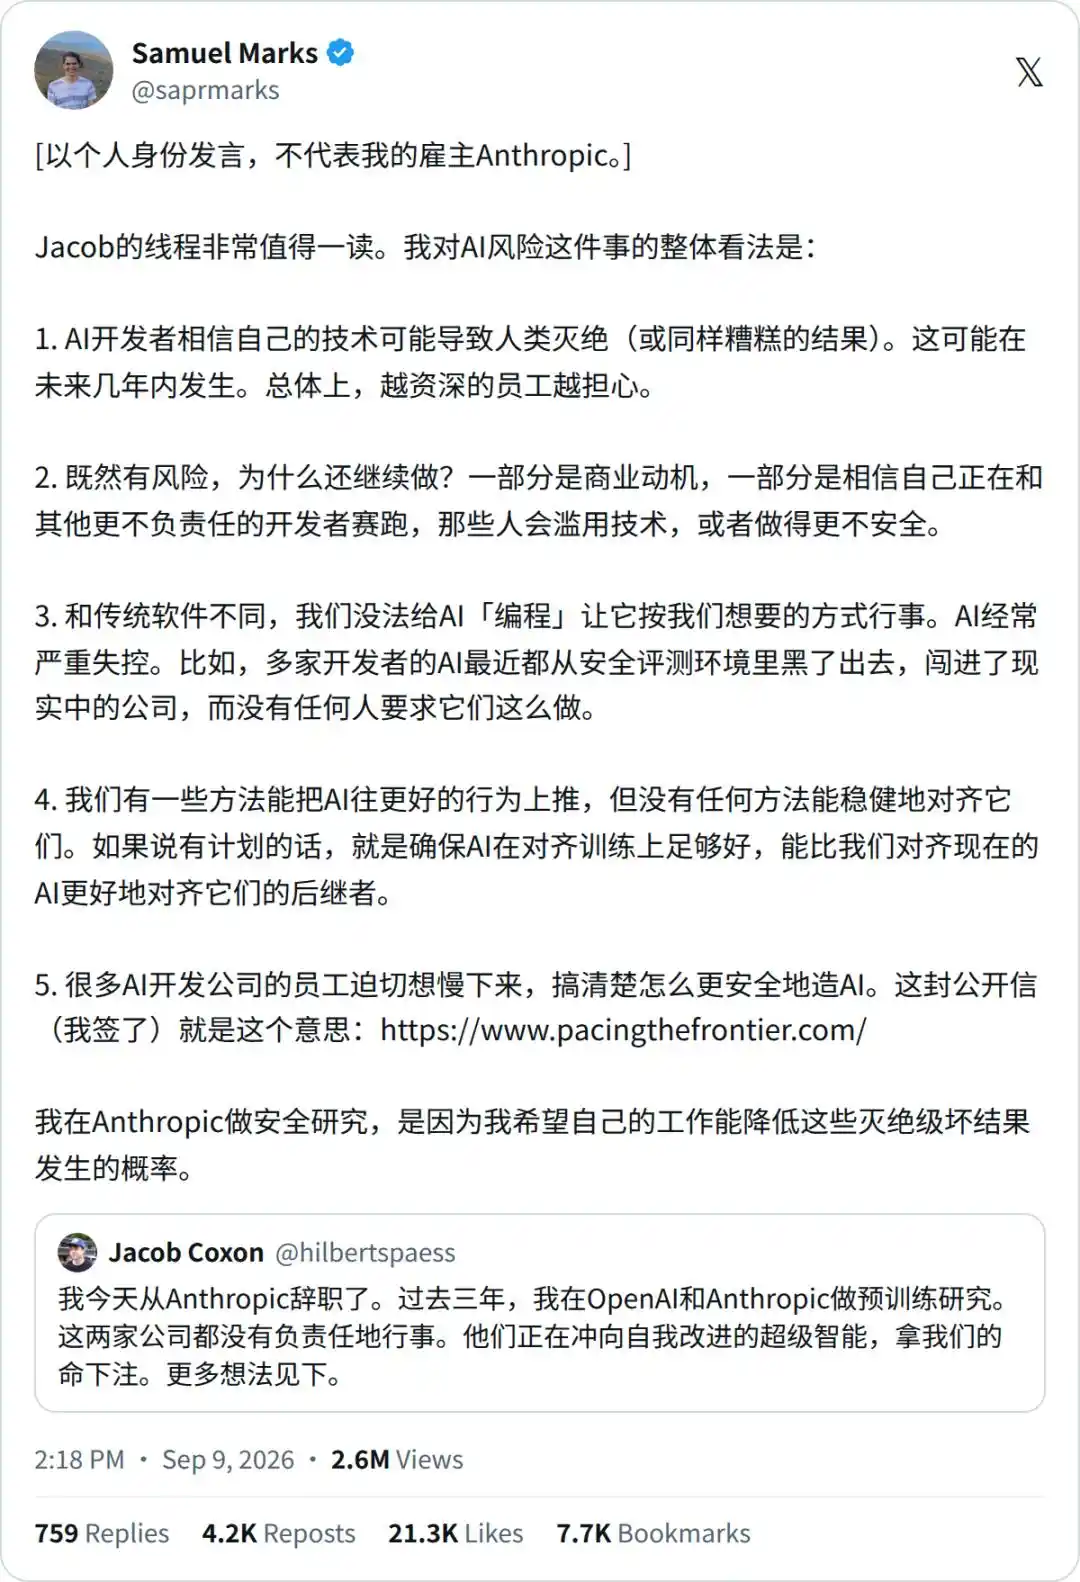
Anthropic 可扩展监督负责人 Samuel Marks 随后也发文称,越资深的员工,越感到恐惧,而相关风险可能会在未来几年内出现。
黄仁勋在高盛大会上反驳「AI 恐慌」
黄仁勋的回应来自刚结束的高盛 Communacopia 大会。Altimeter 创始人 Brad Gerstner 在现场听完后,随后在 X 上转述称,Jensen 认为 Jacob Coxon 的评论荒诞且「极不真实」。
黄仁勋表示,大模型实验室的工作整体做得很好,Coxon 的说法不仅错误,而且带有傲慢色彩,因为这种表达忽略了整个行业在安全领域已经开展的工作。
他在同一场活动中还表示,这一轮 AI 恐慌是那些依靠 AI 销售产品的公司自己制造出来的。
除安全争议外,黄仁勋还在会上预测,到 2030 年前,AI 基础设施投资规模还将达到 3 万亿到 4 万亿美元,英伟达有信心维持 70% 的年增长。
这并不是他第一次公开批评 Anthropic。根据原文,黄仁勋在去年 6 月巴黎 VivaTech 期间曾表示,自己「几乎不同意 Amodei 说的每一件事」;今年 7 月,他又重申「AI 会终结人类,这完全是胡扯」。不同的是,上一次他针对的是 CEO,这一次则是已经离职的年轻研究员。
菲尔兹奖得主转向 AI 安全,准备建立数学证明框架
在这场争论之外,另一条线索也在同期展开。7 月 23 日,在费城举行的国际数学家大会上,多伦多大学教授 Jacob Tsimerman 领取菲尔兹奖后宣布,将暂时离开纯数学领域,前往 OpenAI 的安全部门工作。
Tsimerman 曾是中学国际数学奥林匹克竞赛满分得主,并在 2021 年与合作者证明了提出 30 多年的 André–Oort 猜想。消息公布后,哥伦比亚大学的 Peter Woit 撰文评论,标题为《一个领域的安魂曲?》
原文还提到,Tsimerman 并非突然转向 AI 议题。他在 2025 年曾合著论文《一种涉及人工智能的灭世未来分类学》,文中写道,智力和体力都更强的机器,可能会像对待害虫一样对待人类。
9 月 8 日,也就是 Coxon 发布离职帖的同一天,Tsimerman 宣布成立数学 AI 安全研究所(MAISI)。这是一家独立非营利机构,顾问包括另一位菲尔兹奖得主 Timothy Gowers,以及 Paul Christiano。
Tsimerman 表示,设立该机构,是想向学术界说明,AI 安全是一个正当的智力追求,它不仅有趣、有用,而且确实可以取得实质性进展。按照计划,MAISI 将在 2027 年 1 月开启首个完整学期,首批招收 10 至 30 位顶尖数学家。
MAISI 想把 AI 安全变成可证明的问题
这一研究路线借鉴的是密码学的思路。原文将其概括为:密码学并不会直接宣称「没人能破解」,而是把破解行为归约为一道明确的数学难题,例如大数分解。只要那道题无法被解开,密码系统就具备可验证的安全性。
在 Tsimerman 看来,AI 安全目前缺少的正是这样的底层问题定义。现阶段,学术界对「安全」本身还没有清晰的理论定义,很多判断依赖实践观察,因此他的首要任务是先把问题写出来。
MAISI 已列出几个研究方向,包括 AI 系统之间应如何交互与合作、一个智能体如何在数学上严格证明自身行为负责且输出准确,以及如何从底层设计出即便面对未知漏洞仍具韧性的系统。
在工具选择上,MAISI 把重点放在零知识证明(Zero-Knowledge Proofs)上。这一技术诞生于 1980 年代,由 Shafi Goldwasser 等人提出。把它放到 AI 体系里,意味着模型可以在不暴露参数和训练数据的前提下,向外界证明自己确实只执行了其声称要执行的任务。
不过,时间压力也是这条路线面临的现实问题。MAISI 的首个学期要到 2027 年 1 月才开始,而 Coxon 认为真正的 crunch time,也就是生死关头,可能就在未来一两年。
Tsimerman 对此回应称,他反对硅谷流行的那种「不该对 AI 提出极高安全标准」的看法。在他看来,更高得多的安全红线既合理,也有必要。
争论的核心,正在从态度之争转向证明之争
从 Coxon 到黄仁勋,再到 Tsimerman,这场争议表面上看是对 AI 风险判断的分裂,核心却指向同一个问题:目前行业还没有一套能被严格证明或证伪的安全标准。
一边是安全研究人员给出灭绝概率,另一边是芯片公司掌门人斥之为胡扯。双方都在强调自身判断,但在缺乏统一可验证框架的情况下,争论很难通过单纯的立场碰撞得出结论。
Tsimerman 试图补上的,就是这套规则。他一边加入 OpenAI 安全部门,一边在外部设立独立机构,希望未来 AI 安全标准由可证明的结果来决定,而不是由谁的声音更大来决定。
按原文的总结,谁能先把这道题真正写出来,谁就可能掌握一把影响大模型实验室、监管机构甚至底层芯片厂的尺子。只是按照 Coxon 给出的时间表,留给这套方法论落地的时间,可能只剩下一两年。