
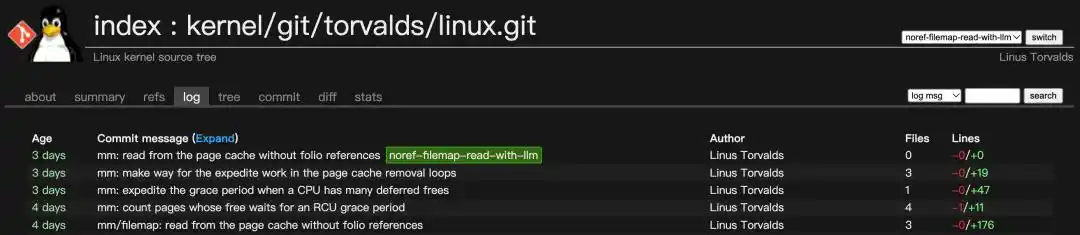
Linux 内核主仓库近日出现了一个名为 noref-filemap-read-with-llm 的新分支。分支名里的「with-llm」直接表明,这次改动有大模型参与。
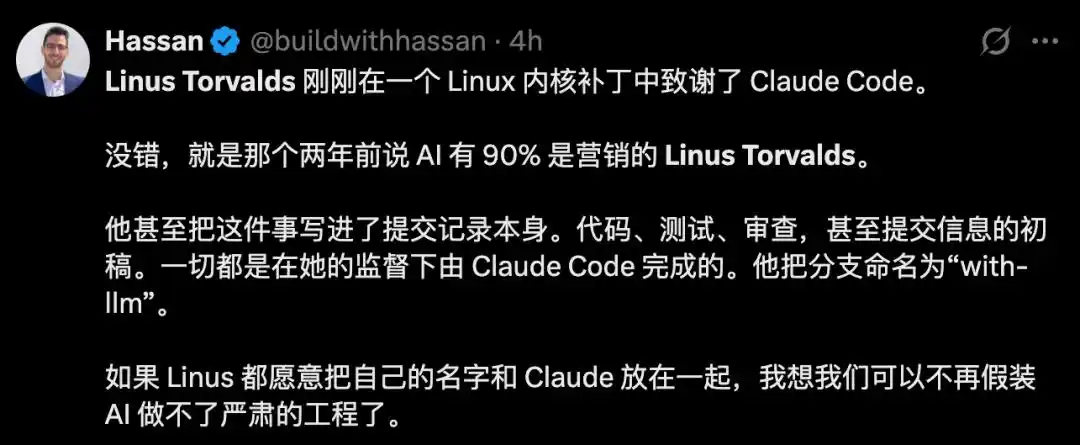
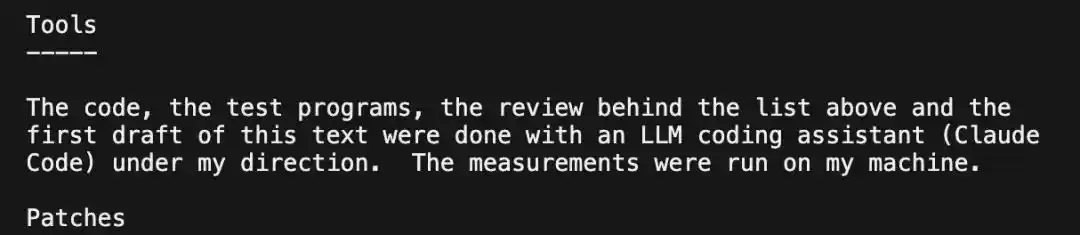
Linus Torvalds 在最新补丁说明中写明,核心代码、测试用例、改动审查和文档草稿,都是在他的指导下与 Claude Code 一起完成的。测试结果显示,在 8 线程读取同一文件的特定场景下,吞吐量约为原来的 3 倍。
改动落在 Linux 内存管理核心路径
这次调整针对的是 Linux 内核中的内存管理机制,具体涉及 page cache 对文件数据的缓存方式。
在常见的多并发业务场景里,多个线程会同时对同一个文件做小块读取。按照现有机制,每次读取都需要在对应的内存块,也就是 folio 上修改原子引用计数。结果是 CPU 核心之间会频繁执行 lock cmpxchg 和 lock decl,在硬件层面引发明显的缓存行颠簸。
早在 2024 年,内核核心开发者 Matthew Wilcox 就指出,这一问题来自真实客户的生产环境。Linus 在自己的测试机上也观察到,在 8 线程并发小读时,这个瓶颈占到了全部「Load HITMs」开销的 99.92%,几乎吃满 CPU 的总线带宽。
Claude Code 参与的不只是补几行代码
从补丁说明看,Claude Code 参与的范围不止是生成代码片段。它还参与了方案实现、检验方案的程序编写,以及潜在问题的梳理。
这些环节连在一起,构成了一次完整的工程尝试:代码需要能够运行,运行结果需要可以测量,测得的提升也需要能够解释。补丁说明本身也承担实际作用,其他维护者需要据此了解为什么要改、哪些路径会受影响、作者检查过哪些情况。
在 AI 先给出初稿后,说明内容仍然需要与代码和测试数据逐项对应。Linus 在说明中强调「在我的指导下」,重点也在这里。
8 线程读取同一文件时,吞吐量约增至原来的 3 倍
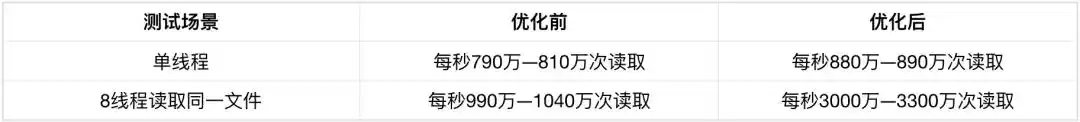
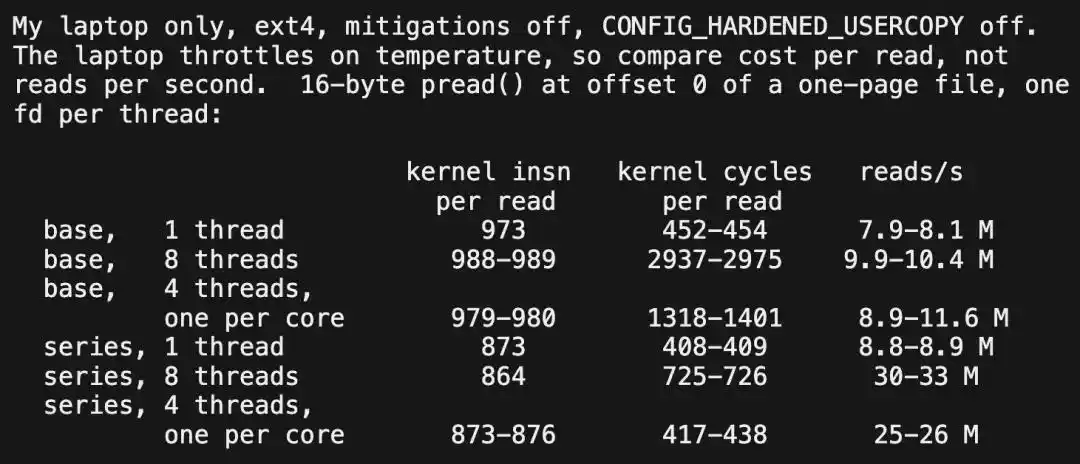
Linus 这次测试使用的是一台搭载 Core i7-8565U 的笔记本,4 核 8 线程,文件系统为 ext4。测试方法是让多个线程反复读取同一个大小为一页的文件,每次只读取 16 字节。
补丁说明给出的结果是,8 线程吞吐量约为原来的 3 倍,单线程提升约一成。
差异出现在「多个线程读取同一个文件」这个条件上。Linux 会把文件数据缓存在内存里,也就是页面缓存,后续读取可以直接从缓存中取数据,不必再次访问存储设备。但缓存中的内存也可能被回收,内核必须保证线程仍在读取时,这块内存不会被释放或转作他用。
原有读取路径会给承载缓存数据的 folio 增加引用计数,读取结束后再减回去。问题在于,多个线程同时读取时,大家会反复修改同一个计数。为了保持一致性,处理器核心之间需要来回传递包含该计数的缓存行。由于单次读取只有 16 字节,真正的数据读取很快,维护计数反而成了主要瓶颈。
补丁尝试绕开读取路径上的引用计数争抢
Linus 这组补丁的思路,是尽量省掉读取路径上的这道手续。
具体做法是,在缓存中的内存被移除后,不立即归还给内存分配器,而是延迟一段时间,再借助 RCU 机制让已经开始的相关读取有机会完成。这样一来,线程可以在受保护的读取区间内直接复制数据,减少对共享引用计数的争抢。
这也解释了为什么在多线程共享同一文件的测试里,收益会格外明显。
另一个新分支中,AI 协助挖出可追溯至 2013 年的 4 个 Bug
在 noref-filemap-read-with-llm 分支出现后的第二天,Linus 仓库里又出现了一个 assoc-array-fixes 库。assoc-array 是一套按键组织和查找对象的数据结构,最初实现可以追溯到 2013 年。
几天前,开发者 Nils Ollrogge 提交了一份 Bug 报告,并附上修复补丁。Linus 在查看后发现,这段代码本身相当晦涩,逻辑不容易理清。随后,他借助大模型梳理代码,把一些庞大且难读的函数拆开,让不同操作的边界更清楚,再把这些代码放进用户态测试框架中运行。
测试结果确认了 Nils 报告的问题,同时额外找出了 3 个 Bug。4 个问题都可以追溯到 2013 年该库首次合入内核时的提交。
18 个键即可触发其中一个问题
补丁说明给出了一个具体例子:在某种根节点结构被拆分时,索引使用的位段会发生错位,导致原先存入的对象无法再被找到。
按照说明,只需要 18 个键就能触发这个问题。操作完成后,其中 3 个对象会查不到;如果再次插入相同的键,还会新增对象,而不是正确替换原有对象。
另一个问题出现在内存分配失败路径。平时正常运行时,它可能不会暴露;但一旦某次分配失败,清理逻辑可能沿着指针进入仍在使用的旧树,触发内核错误检查。对应测试通过让操作中的每一次内存分配轮流失败,逐个检查异常分支,才把这个问题暴露出来。
Linus 在补丁中的做法,强调的是可验证性
从这两组改动看,AI 在这里承担的角色并不是独立完成提交,而是帮助梳理复杂代码、拆分难读函数、生成测试和说明草稿,再由维护者把代码、测试结果和补丁说明逐项对齐。
Linus Torvalds 过去说过一句广为流传的话:「Talk is cheap. Show me the code.」这次他在自己的主仓库里挂出带有「llm」后缀的分支,也让外界看到了他对这类工具的最新用法:重点不在于谁敲下代码,而在于是否知道该改哪里,以及能不能验证改动是否成立。
参考资料为 Phoronix 发布的《Linus Torvalds Claude Code》相关报道。本文原始来源注明为微信公众号「新智元」,作者为 ASI 启示录。


