
OpenAI 发布了一套名为 textGrain 的文本水印方案,目标是在不明显改变文本可读性的前提下,让检测器识别一段文字是否由 OpenAI 模型生成。按照文中说法,全球 API 客户当天就可以自行开启这项水印,ChatGPT 和 Codex 也将在未来几周陆续接入。
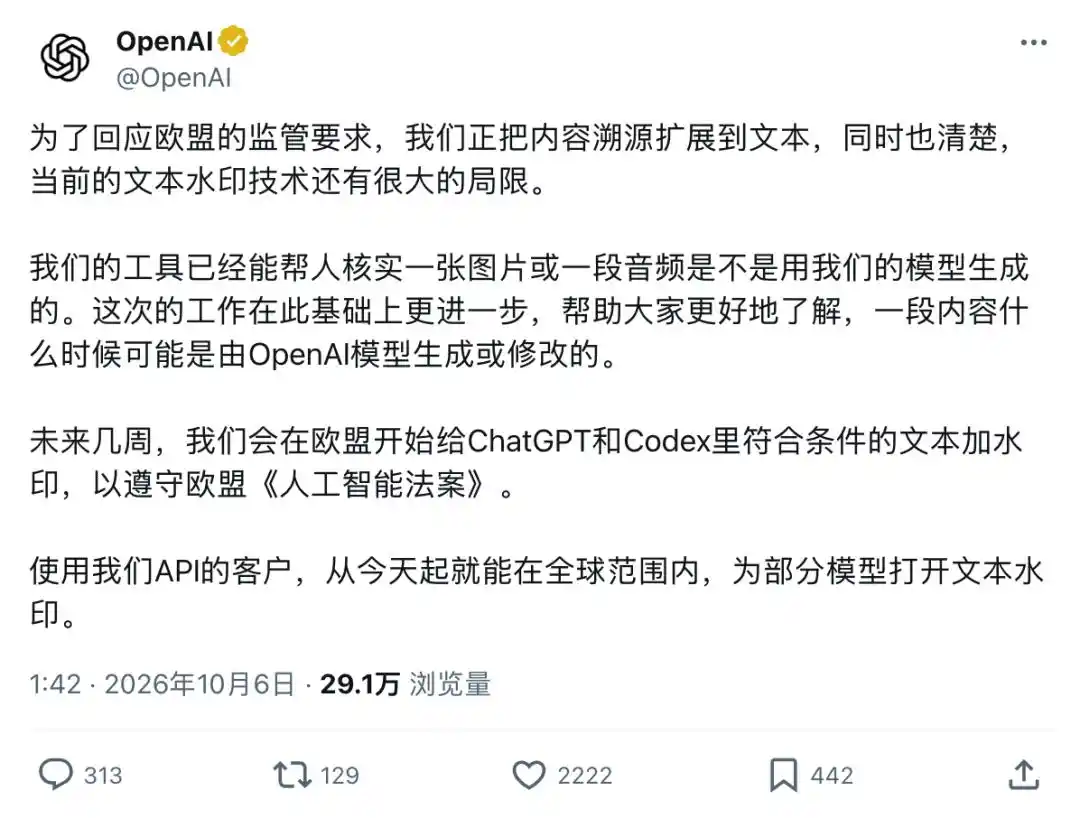
这意味着,若用户将 AI 生成内容原样复制粘贴到作业、简历或周报中,未来被识别出来的可能性会提高。OpenAI 给出的几项关键信息包括:水印已面向 API 客户开放;在误报率控制在 1% 时,一段 400 个 token 的心理学类回答,检出率超过 90%;旗舰模型 GPT-6 Astra 加入水印后,8 项核心基准测试整体基本持平,其中 5 项略有上升;检测器暂不向公众开放,只提供给审核通过的研究者和专业机构,而 textGrain 本身将开源。
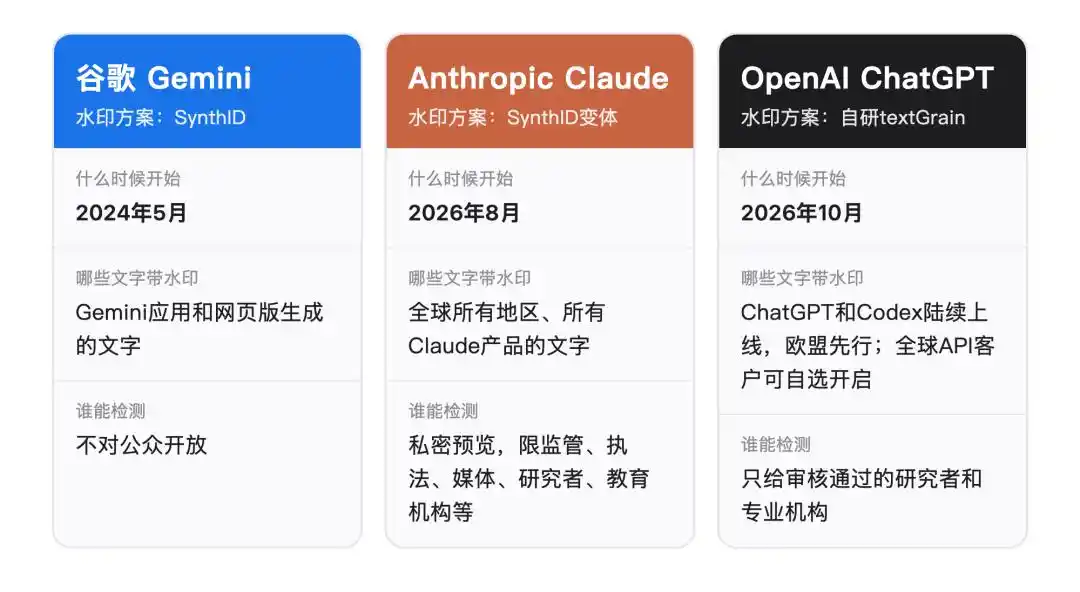
文中还提到,至此,谷歌、Anthropic、OpenAI 三家公司都已为 AI 生成文本部署可识别出处的技术方案。
textGrain 如何在不改写文本风格的情况下嵌入水印
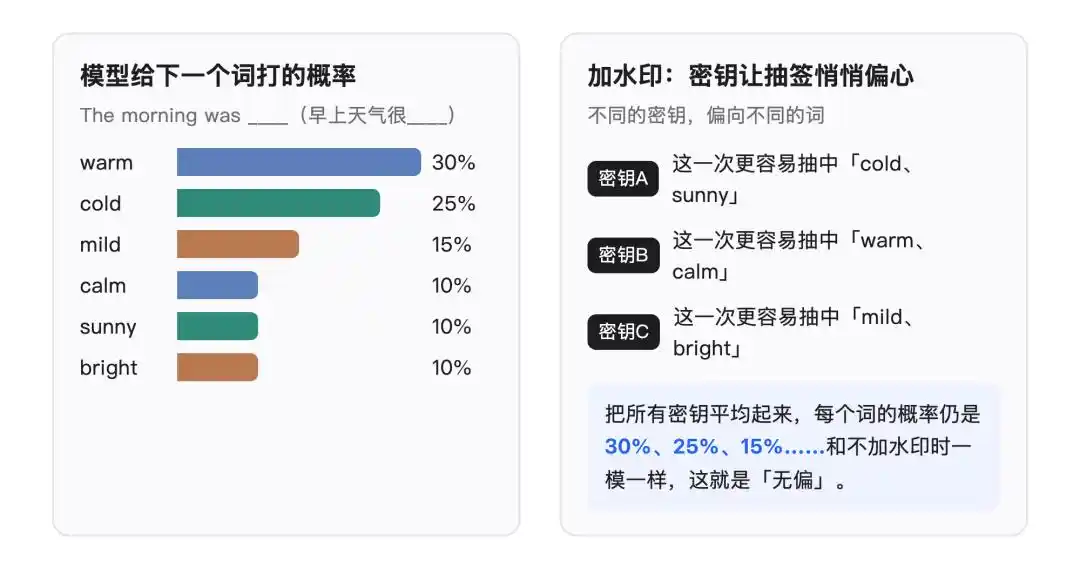
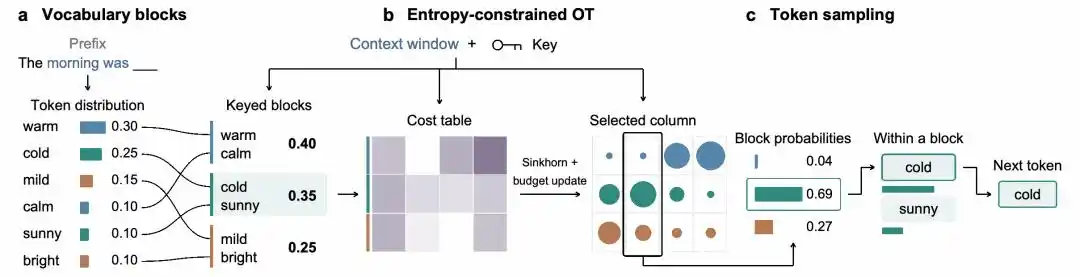
大模型生成文本时,是逐词输出的。每一步生成前,模型会先给候选词分配概率,再按概率抽取下一个词。文中举例称,在句子「The morning was ___」后面,候选词里「warm」占 30%,「cold」占 25%,其余词分掉剩余概率。
textGrain 要做的,是让这次抽样过程在密钥控制下发生轻微偏移,但又不能破坏一个前提:对不知道密钥的人来说,整体分布必须保持「无偏」。也就是说,把所有可能的密钥平均起来后,每个词最终被抽中的概率要和原来一致。这样一来,外部观察者看到的仍然是正常随机文本,模型原本想表达的内容也不会被直接改写。
文章提到,Scott Aaronson 在 OpenAI 时期做过第一版水印,虽然满足无偏,但存在一个问题:同一个问题配合同一把密钥时,模型每一步都可能选出同一个词,导致同一问题重复提问时,回答可能几乎完全一致。
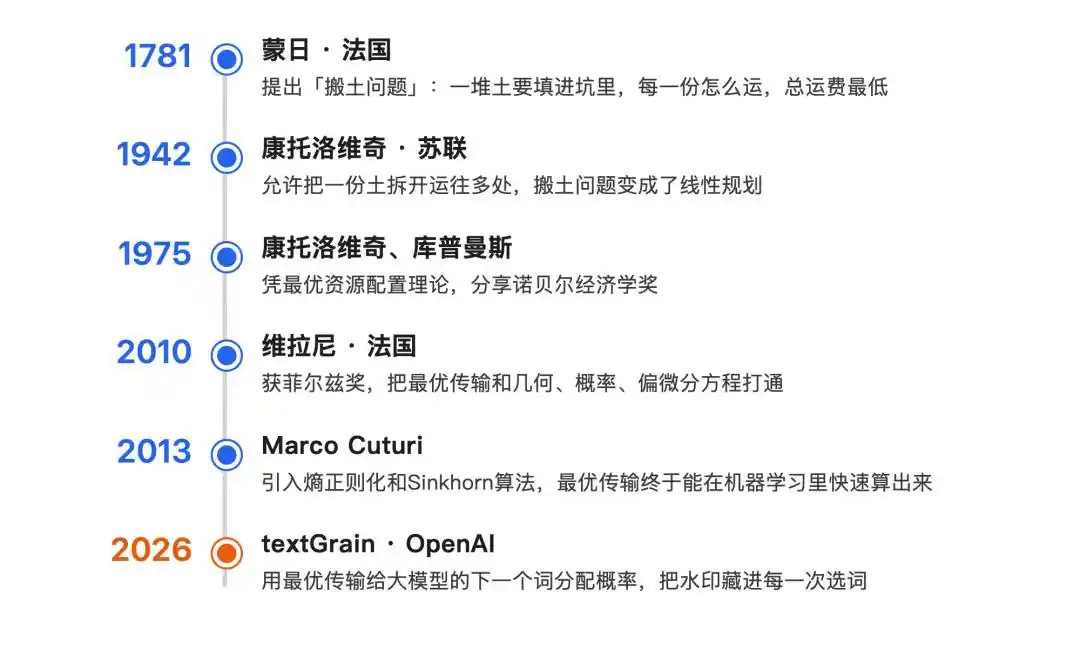
1781 年的「搬土问题」被用到了文本水印里
textGrain 的解法来自最优传输。文章把这条数学脉络追溯到 1781 年法国数学家蒙日提出的搬土问题:如何把一堆土运到另一个坑里,并让总运费最低。到了 20 世纪 40 年代,苏联数学家康托洛维奇把问题放宽为一份土可以拆分运往多处,只要总量匹配即可,这让搬土问题转化为线性规划。康托洛维奇后来凭最优资源配置理论,与库普曼斯分享了 1975 年诺贝尔经济学奖。
文章还提到,技术报告作者之一、耶鲁经济学家陈晓红,如今担任的正是以库普曼斯命名的讲席。再往后,2010 年菲尔兹奖得主维拉尼把最优传输与几何、概率、偏微分方程联系起来;2013 年,Marco Cuturi 引入熵正则化和 Sinkhorn 算法,大幅降低计算成本,最优传输才逐渐成为机器学习中的常用工具。
在 textGrain 中,被「搬运」的不再是土,而是下一个词的概率。
核心机制:给水印设置一笔「随机性预算」
textGrain 的核心思路,是给水印设定一笔「随机性预算」。文章称,论文证明了一条恒等式:水印让选词与密钥之间新增的关联,恰好等于模型平均损失掉的随机性,两者是同一个量。换句话说,水印获得多少统计关联,就要消耗多少随机性。
因此,OpenAI 可以预先设定一个比例,限制水印最多消耗原始随机性的多少。文中举例,如果预算设为 0.2,那么平均下来至少保留 80% 的随机性,用于维持回答的多样性。
具体过程分三步。
第一步,密钥结合前文,把候选词随机分组,并把每组的概率加总。文中的示意图里,6 个词被分成 3 组,其中「warm、calm」占 0.40,「cold、sunny」占 0.35,「mild、bright」占 0.25。
第二步,系统准备 4 套不同的「偏向方案」。密钥会为每个「组×方案」生成随机分数,再通过带熵约束的最优传输,借助 Sinkhorn 算法不断修正行和列,把概率尽量向高分格子移动,直到预算耗尽。4 套方案平均后,每组概率仍保持 0.40、0.35、0.25,不改变总体分布。
第三步,密钥从中选定一套方案。文中示例里选中第 2 列后,「cold、sunny」这一组的概率从 0.35 提高到 0.69,再在组内按原来的 25 比 10 比例选词,最终输出「cold」。
对不知道密钥的人来说,这仍像一次正常抽样;对掌握密钥的人来说,则知道这一步本应偏向哪一组。
检测时不需要模型,也不需要知道预算
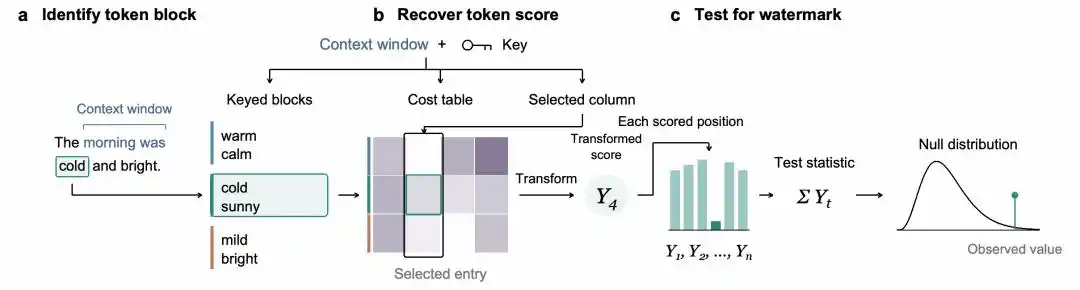
检测阶段要回答的问题只有一个:一段文字的选词,是否反复「碰巧」落在密钥偏好的位置上。
文章称,普通人写出的文本与密钥没有关系,因此每个位置的得分都是随机的,总分会落在一个可以精确计算的概率分布范围内。带水印的文本则更容易落在高分格子上,因此总分会显著偏高。
按照文中说法,整个检测过程只需要原文和密钥,不需要调用模型,也不需要知道生成时的预算参数。
OpenAI称性能影响很小
文章提到,这种水印没有明显拉低模型性能。GPT-6 Astra 的 8 项基准测试中,有 5 项在加入水印后略有上升,下降最多的一项也只有 1.12 个点。ChatGPT 内部测试则显示,用户的「点踩率」几乎没有变化。
OpenAI 还称,在误报率控制在 1% 时,一段 400 个 token 的心理学类回答,检出率超过 90%,并表示效果追平甚至超过谷歌的 SynthID。
作者团队横跨 OpenAI、宾大和耶鲁
这份技术报告共 20 页,作者中有 4 位来自高校,9 位作者的研究背景覆盖统计学、经济学、优化和机器学习。
第一作者李翔本科和博士均毕业于北京大学数学科学学院,导师是张志华,近年研究方向集中在大模型文本水印和大模型评估,文中称其将于明年 1 月赴罗格斯大学统计系任助理教授。
宾夕法尼亚大学的龙琦是生物统计学家,出身中国科大少年班,目前负责宾大生物医学信息学研究所。
耶鲁方面,陈晓红是美国艺术与科学院院士,曾与邹至庄共同获得 2017 年中国经济学奖。温刚是耶鲁统计与数据科学系五年级博士生,本科毕业于北大数院,研究方向是高维概率和随机矩阵,2021 年起跟随苏炜杰做研究。
OpenAI 作者中,Qingquan Song 来自基座模型团队,是开源工具 Auto-Keras 的作者之一;Arzav Jain 和 Florent Joly 都参与过 ChatGPT 搜索研发。
把这支团队串联起来的是通讯作者苏炜杰。文章称,他于今年 5 月正式加入 OpenAI,同时仍担任宾大沃顿商学院统计与数据科学系教授。苏炜杰是北大数院 07 级学生,在北大期间专业成绩年级第一,并获得首届丘成桐大学生数学竞赛全能金牌,之后前往斯坦福大学攻读统计学博士,师从 Emmanuel Candès。
文中还提到,苏炜杰的研究覆盖统计机器学习、高维推断、优化和隐私保护。ICML 2023 曾用他提出的「保序机制」做实验,让作者给自己的投稿排序,以校准审稿分数。今年 2 月,他获得 COPSS 会长奖,颁奖词第一条提到的就是生成式 AI 的统计基础,其中包括水印研究。
检测权限仍受限,但方向已经明确
文章最后回到一个更现实的问题:个人使用 AI 写作,是否会被查出。
按文中说法,原样照抄的风险确实更高,连续几百个词就可能足以让检测器识别出来。不过,现阶段能使用检测器的并不是普通教师或企业招聘人员。根据官方通告,OpenAI 的检测器只提供给审核通过的研究者,Anthropic 的检测工具也只向监管机构、媒体、研究者和教育机构开放。
尽管检测权限尚未全面开放,文章认为方向已经很清楚。ChatGPT 每周有 12 亿人在使用,越来越多文本由模型生成,而谷歌、Anthropic、OpenAI 都选择把出处直接写进文本本身。
文章最后写道,水印只能证明一段话出自 AI,不能证明一段话出自某个具体的人。今后,「这是我写的」这句话,可能也需要拿出证据。
参考资料与来源
OpenAI:eu-text-provenance
OpenAI 技术报告:textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf
本文来自微信公众号「新智元」,作者:ASI启示录,编辑:摩西