
Pearl 想做的事很直接:让同一张 GPU 一边做 AI 推理,一边完成工作量证明挖矿。
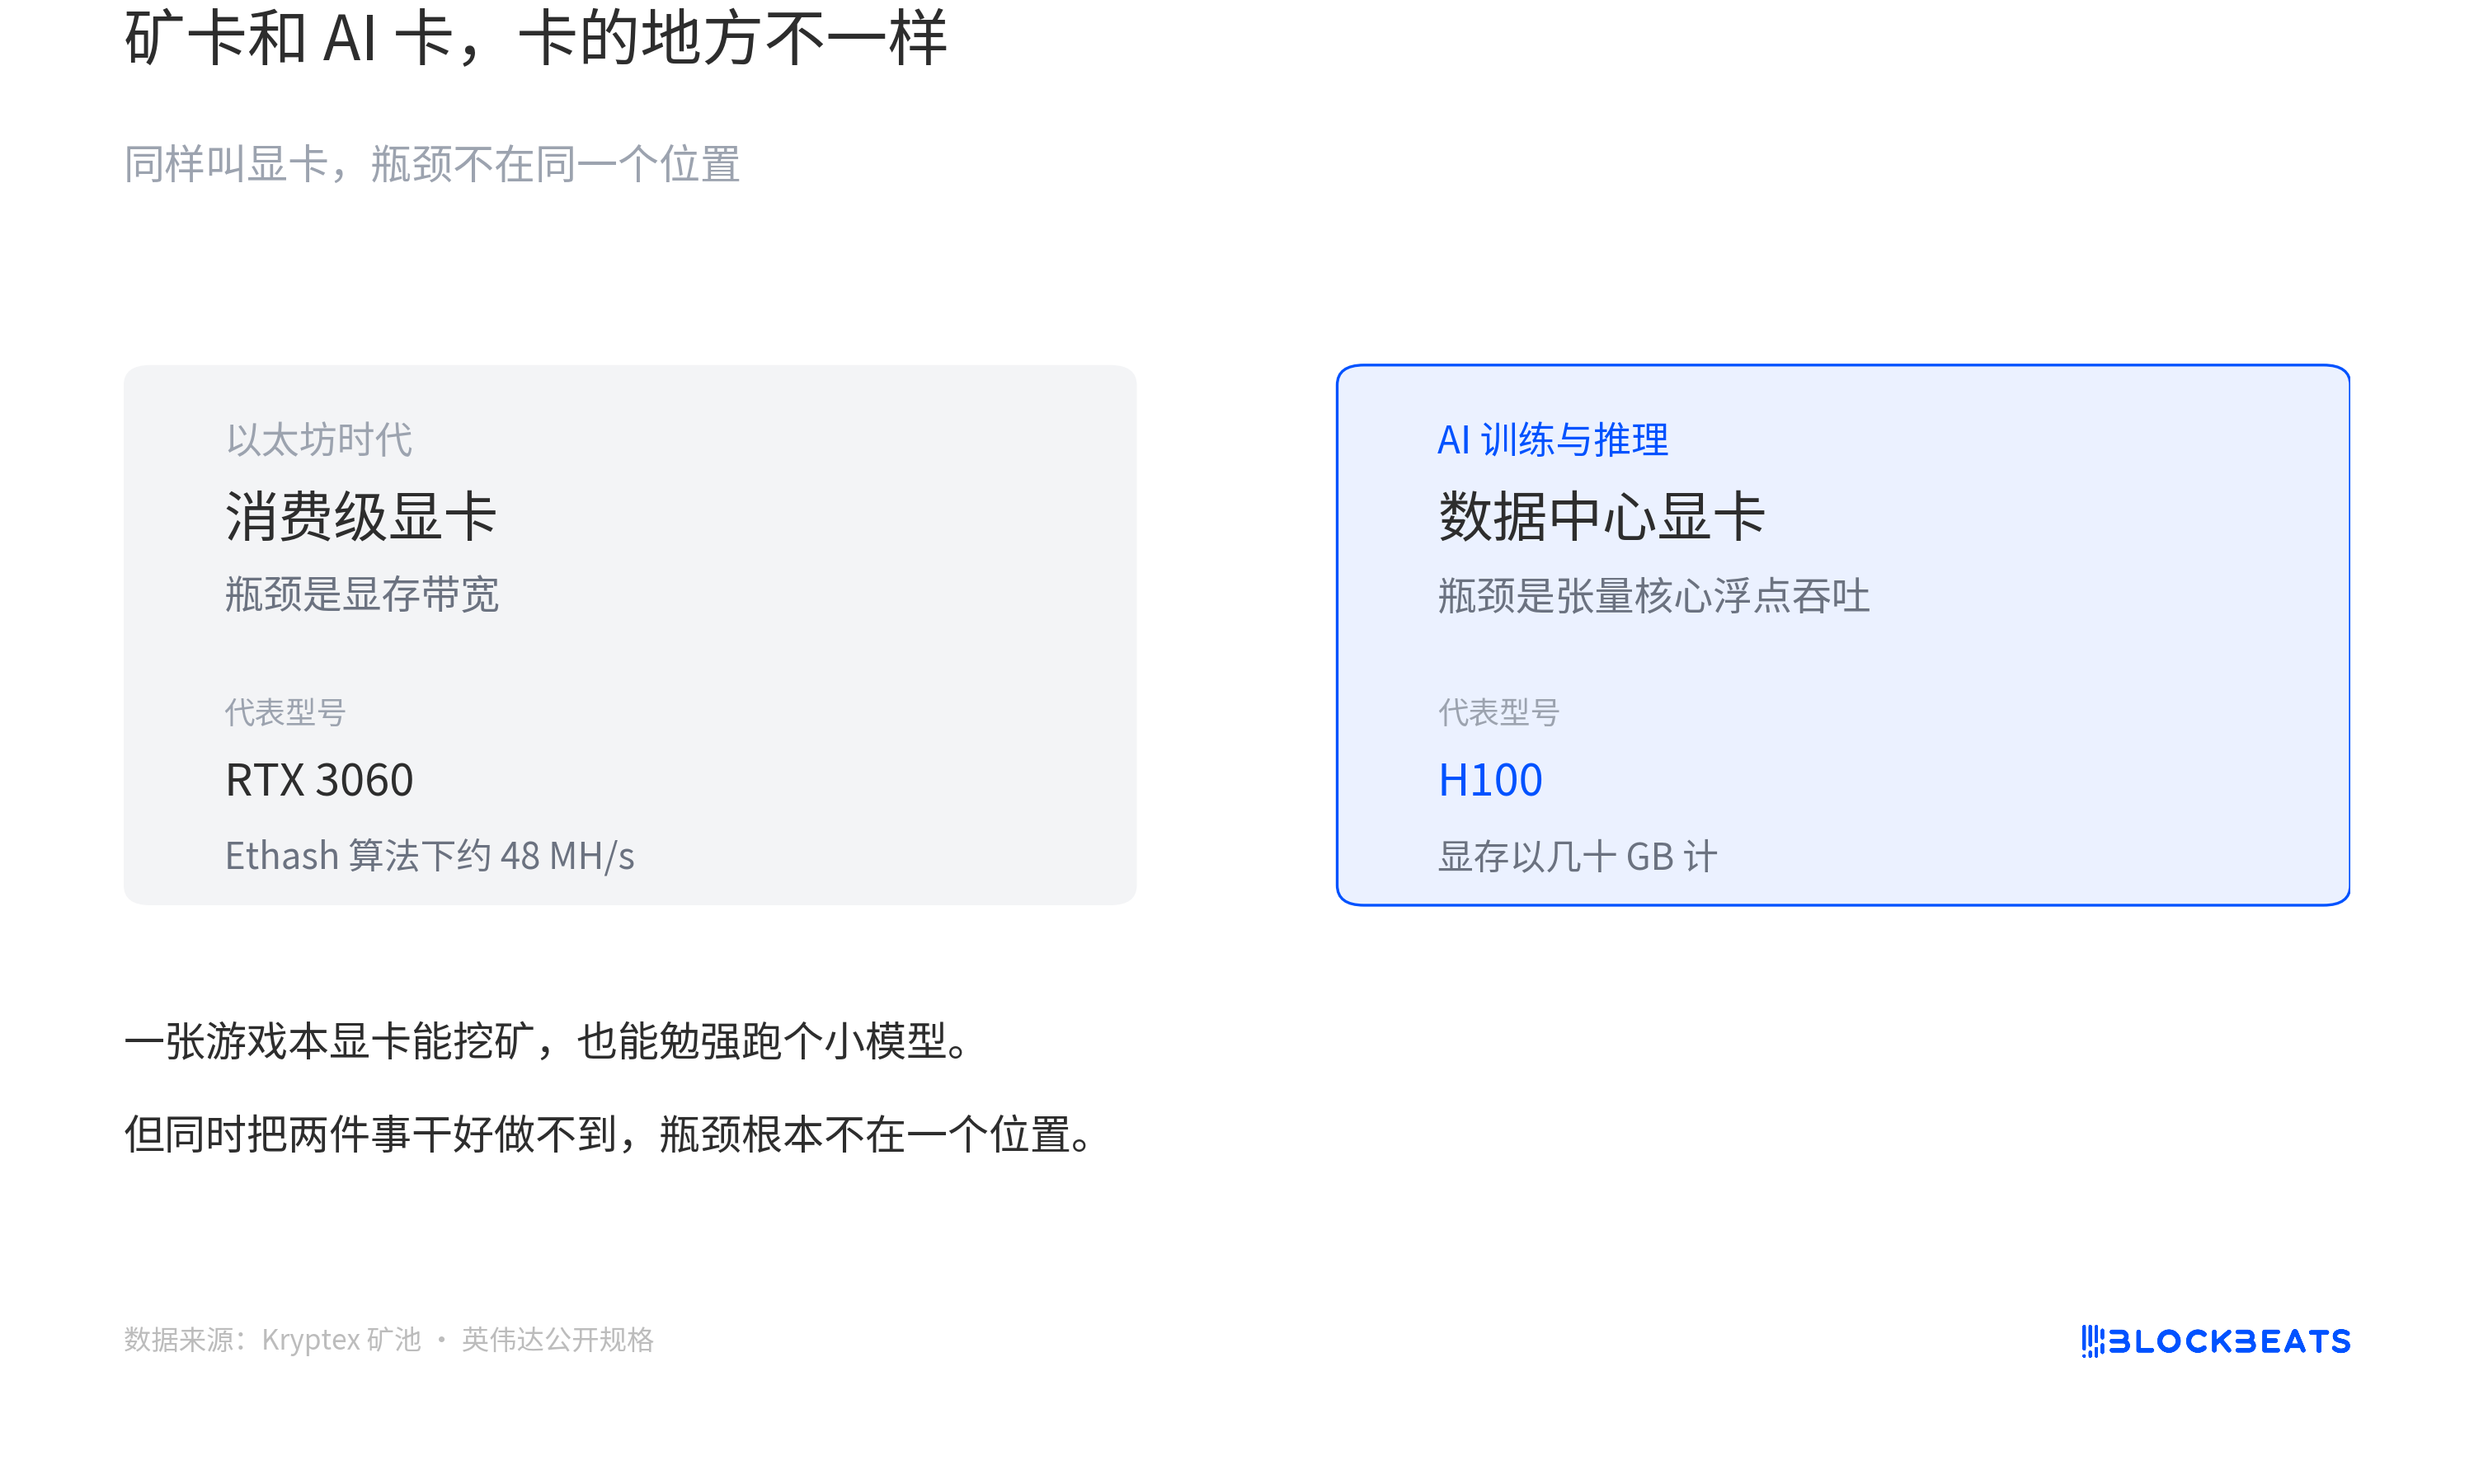
这个想法并不新。以太坊还是 PoW 的几年里,矿工使用的就是消费级显卡,算法是 Ethash。一张 RTX 3060 在 Ethash 上大约 48 MH/s。当时就有人设想,既然挖矿和 AI 都依赖显卡,能不能让同一张卡同时承担两种任务。
问题在于,两类负载卡住的地方并不一样。Ethash 主要吃显存带宽,计算的是固定难度哈希;AI 更依赖张量核心的浮点吞吐和几十 GB 显存,主力硬件是 H100 这类数据中心卡。游戏本上的显卡可以挖矿,也能勉强跑小模型,但很难把两件事同时做好。
Vitalik Buterin 在 2019 年对这件事下过判断。他当时说:「如果能找到某种既有用又容易验证的计算,加密货币挖矿会成为社会的一笔巨大财富,但这大概是做不到的。」
Pearl 的说法是,它已经把这件事做出来了。Vitalik 几年前的这段判断,也被放在 Pearl 官网的显眼位置。
Pearl 想把出块计算改成矩阵乘法
Pearl 是一条独立的工作量证明公链,代币为 PRL。它不让矿工反复计算哈希,而是改做矩阵乘法,也就是神经网络每一层都在执行的那类乘加运算。按项目设计,同一份 GPU 计算既能出块发币,也能产出可验证的 AI 计算。
官方对这套设计的表述是「能量、数据、货币在一次操作里」。比特币把能量和货币绑在一起,AI 把能量和数据绑在一起,货币化把数据和钱绑在一起。Pearl 想做的是,在一次矩阵乘法里让三者同时发生。
在 PoW 这条线上,近几年已经很少出现能引发持续讨论的新公链。市场注意力更多集中在 L2、模块化和再质押。正因如此,一条新的 PoW 链本身就不常见。PRL 当前流通市值为 4.3 亿美元,项目试图讲述的核心,就是「有用工作量证明」能否真正落地。
Pearl 试图解决的不是“有用”,而是“无许可地有用”
比特币工作量证明的一个特点是,矿工所做的计算与现实世界没有直接关系。同样一度电,如果拿去跑模型,可以生成 token、出图,或者完成其他任务,因此很多人会觉得单纯挖矿存在浪费。
但真正的难点不在于让计算“有用”,而在于无许可。无许可意味着任何人都可以参与挖矿,不需要报名,也没有资格审核。比特币的安全模型建立在这一点上:不管矿工算的是什么,成本结构都一致。一旦工作量被替换成现实中有价值的任务,矿工就会有动机偷工减料,或者挑选更便宜的输入。
所以问题并不是能不能让挖矿变得有用,而是能不能在保持无许可的前提下,让它有用,同时又让矿工无法偷工。
Pearl 的回答是,把比特币的随机哈希换成矩阵乘法,让 GPU 把工作量证明当成 AI 负载的副产品来完成。其白皮书直接使用了「2-for-1」这个词。换句话说,过去一批 GPU 只有两个用途:要么挖矿,一边耗电一边出币;要么跑模型,一边耗电一边产出 AI token。Pearl 想把这两个用途合成一个。
这个设想并非只停留在口号层面。密码学研究者 Rafael Pass 在论文《The Economics of Proof-of-Useful-Work》中,把机器工作分成三类:纯挖矿、纯推理,以及同时产出两者的双工工作。论文指出,双工并不是免费的:同一份算力同时做两件事,得到的不是两份产出,而是大约一份半。如果额外开销足够小、代币被市场接受的规模足够大,那么区块奖励就相当于给推理价格打了返点,原本不会进入市场的推理算力也可能被吸引进来。
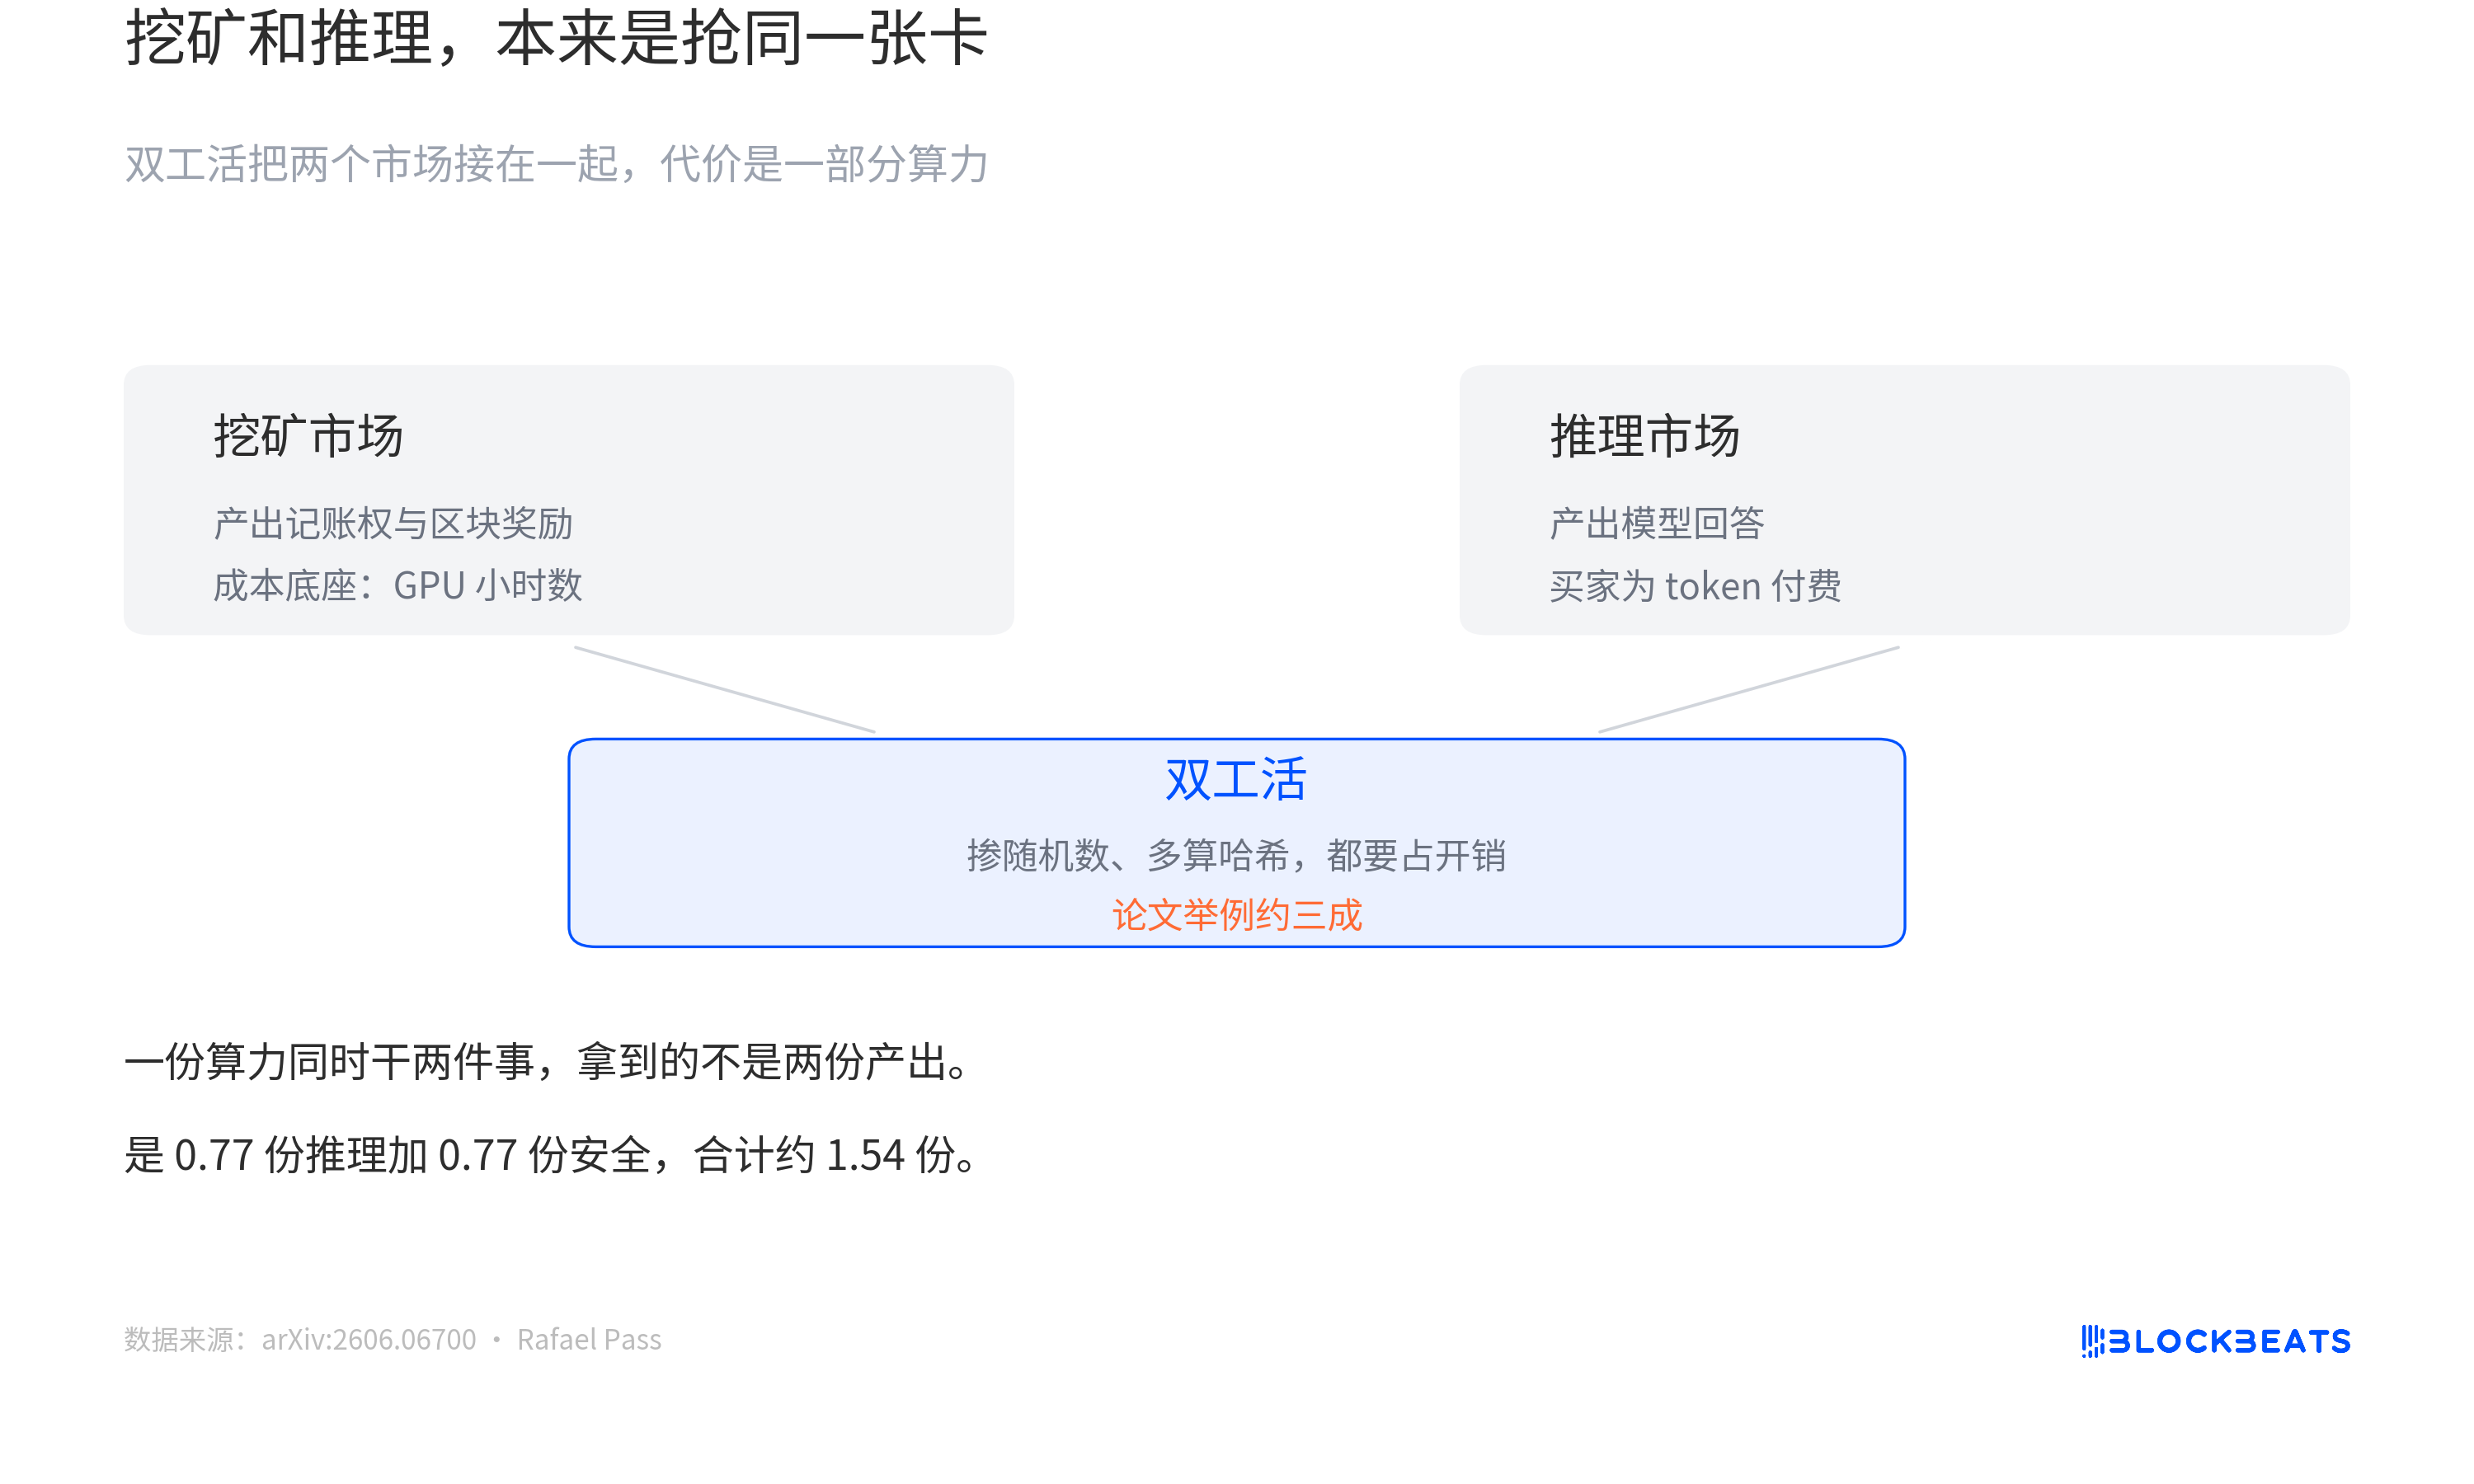
这套推演在数学上成立,但其中有三个关键变量——开销、币价、推理需求——都不是 Pearl 自己能够决定的。论文脚注还披露,作者是在为 Pearl Research Labs 提供咨询期间完成这项研究。
矩阵乘法为什么能被拿来做 PoW
要理解 Pearl 的机制,先要拆开「矩阵乘法」这个词。它不是 Pearl 发明的,而是一种很老的运算,神经网络几乎每一层都在使用。
矩阵可以理解为按行列排列的数字表格。两张表可以相乘,前提是前一张的列数等于后一张的行数。结果矩阵中的每个格子,都来自前一张矩阵的一行与后一张矩阵的一列,逐项相乘后再加总。
文中的最小例子是:A 的第一行是 1 和 2,B 的第一列是 5 和 7,那么结果矩阵左上角就是 1 乘 5 加 2 乘 7,结果为 19。其他格子也按同样规则计算。
在 AI 模型中,一层运算可以写成「输入乘权重」。用户的一句话会被切成向量,与这一层的权重矩阵相乘,得到结果后再经过非线性函数,交给下一层。模型越大,矩阵越大,一次乘加的次数动辄上万亿。GPU 正是为这种规则整齐的乘加运算设计的,这也是为什么挖矿卡和 AI 卡本质上属于同类芯片。
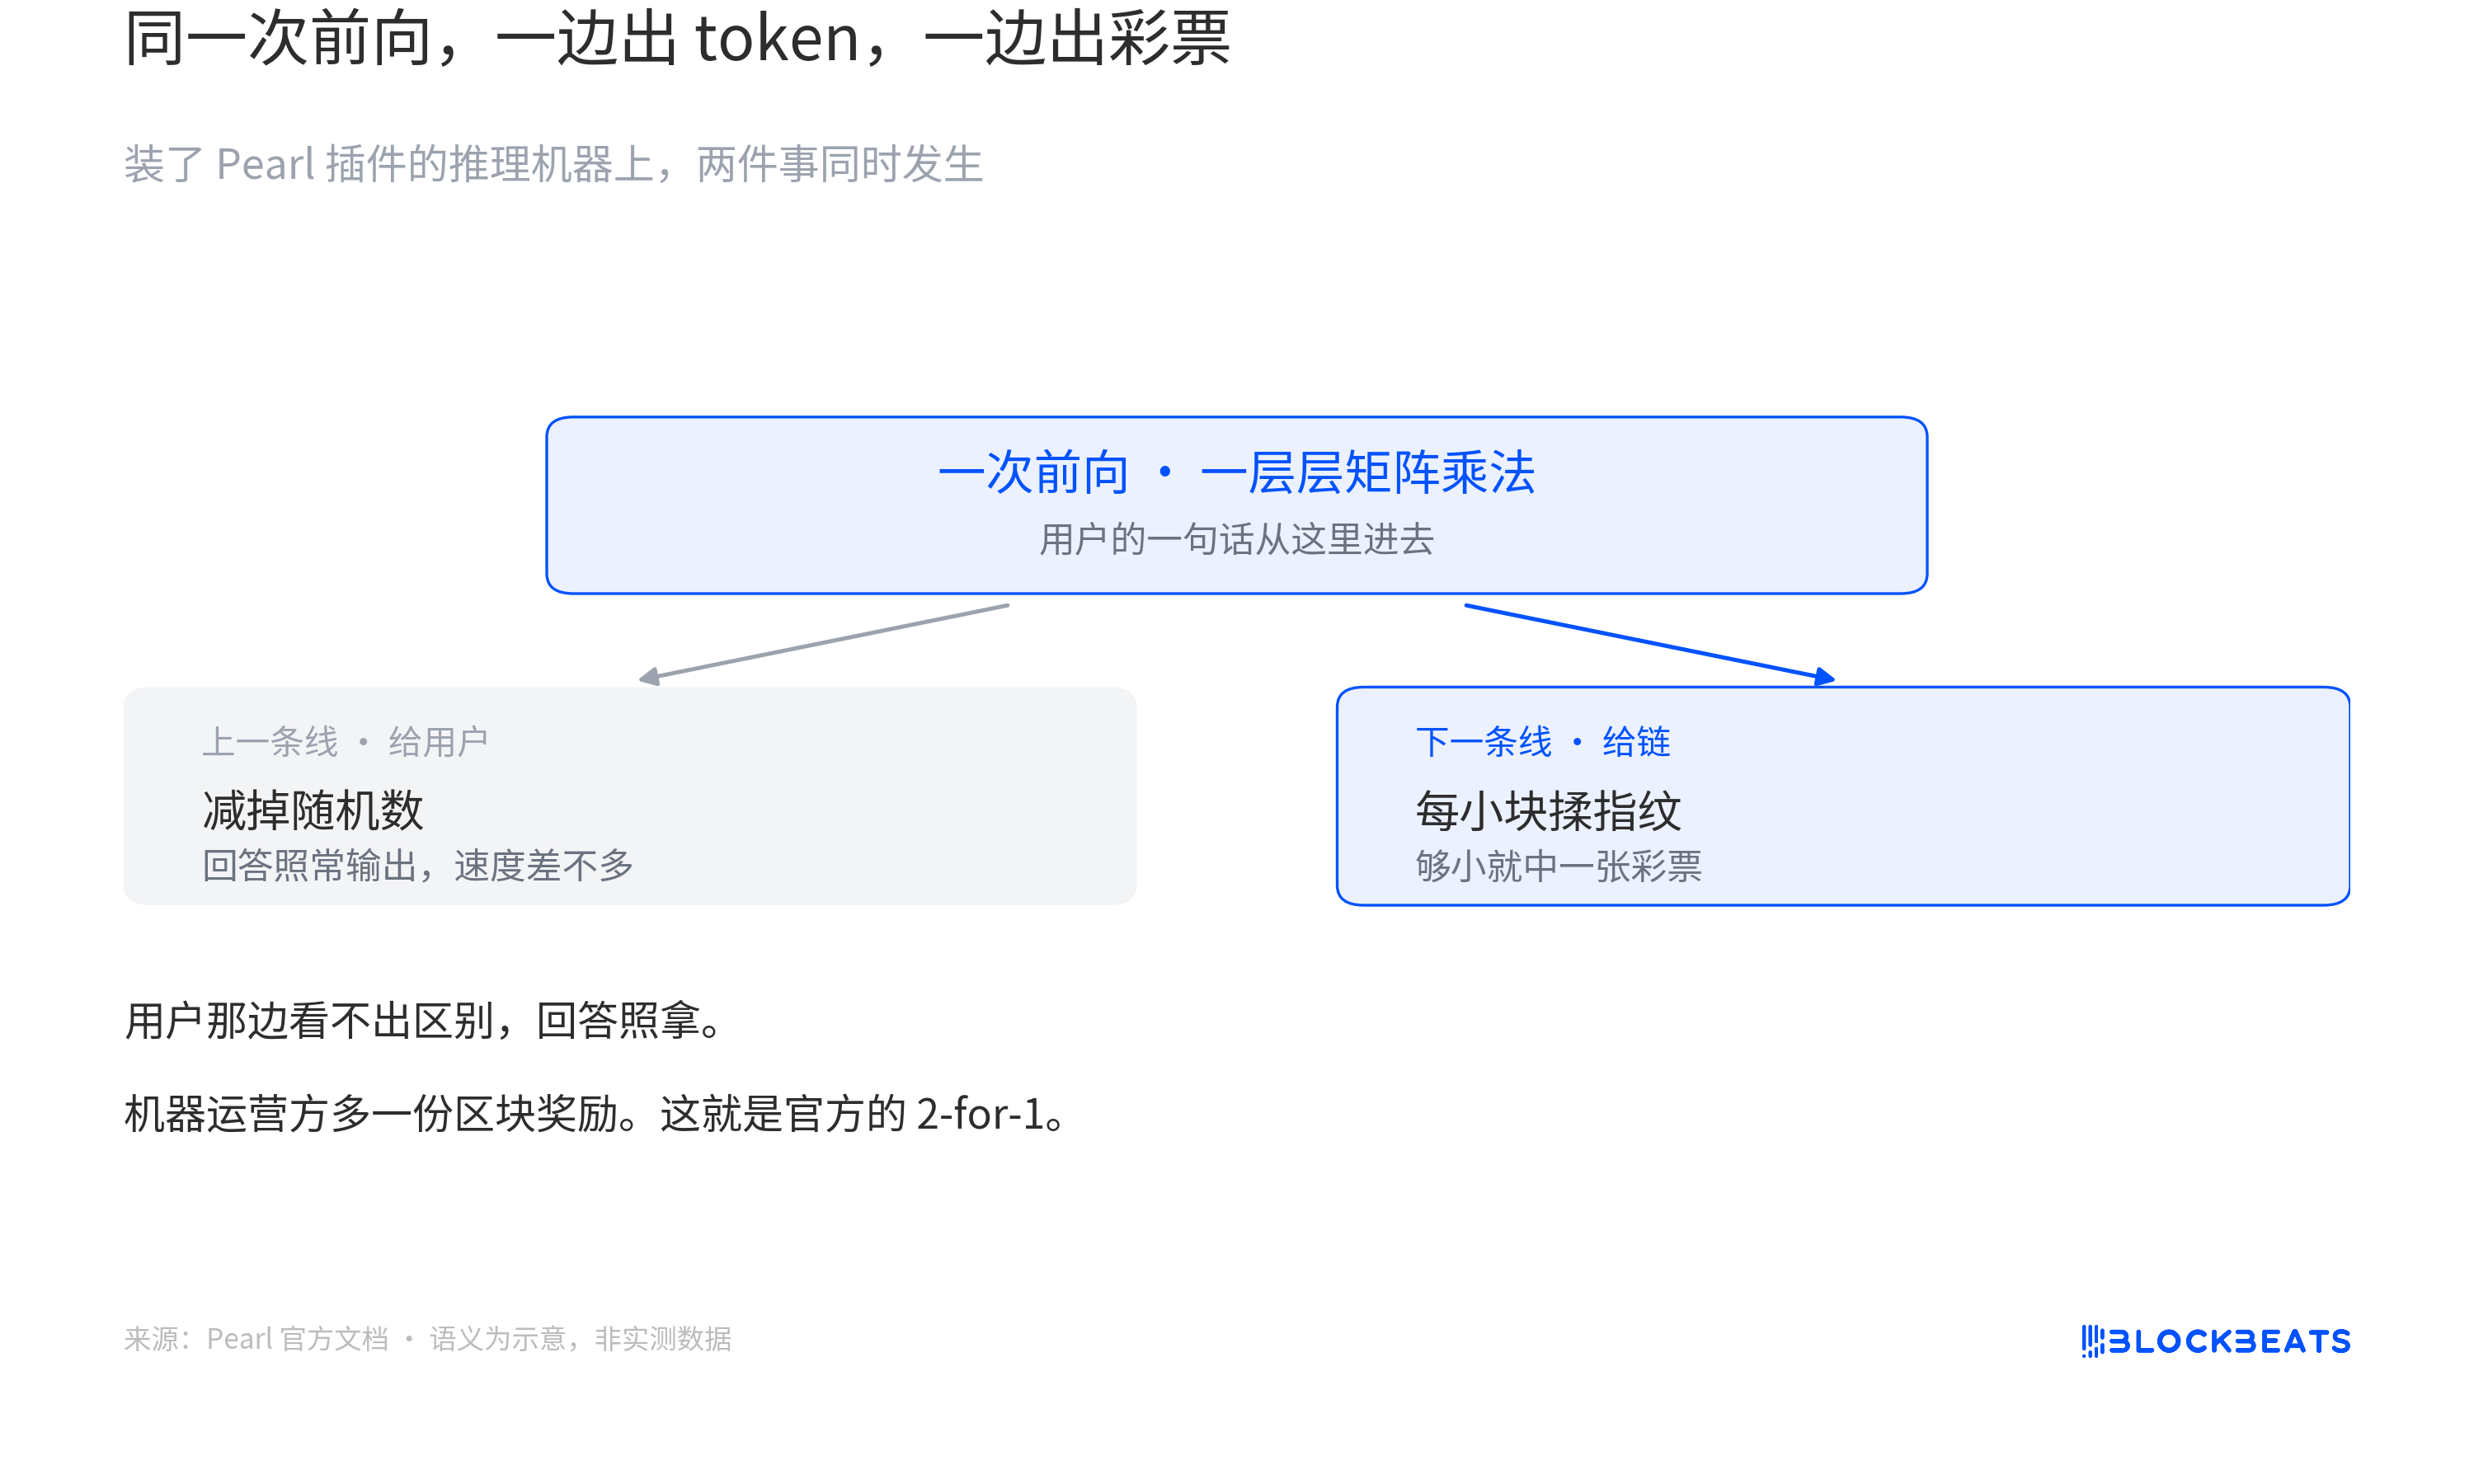
按 Pearl 的理想场景,用户在网上向聊天机器人提问,服务器上的显卡开始逐层执行矩阵乘法。如果这台机器安装了 Pearl 插件,并运行的是其认证过的开源模型,那么这些乘法在生成回答的同时,也会被拿去参与出块。每算完一小块,就会生成一次指纹;如果指纹足够小,就像中了彩票一样获得区块奖励。对用户来说,回答照常返回,价格甚至可能更低。同一批乘加运算,一边变成 AI token,一边变成链上代币。
协议如何防止矿工“偷工”
这套设计要成立,首先要解决矿工绕过大计算量的问题。
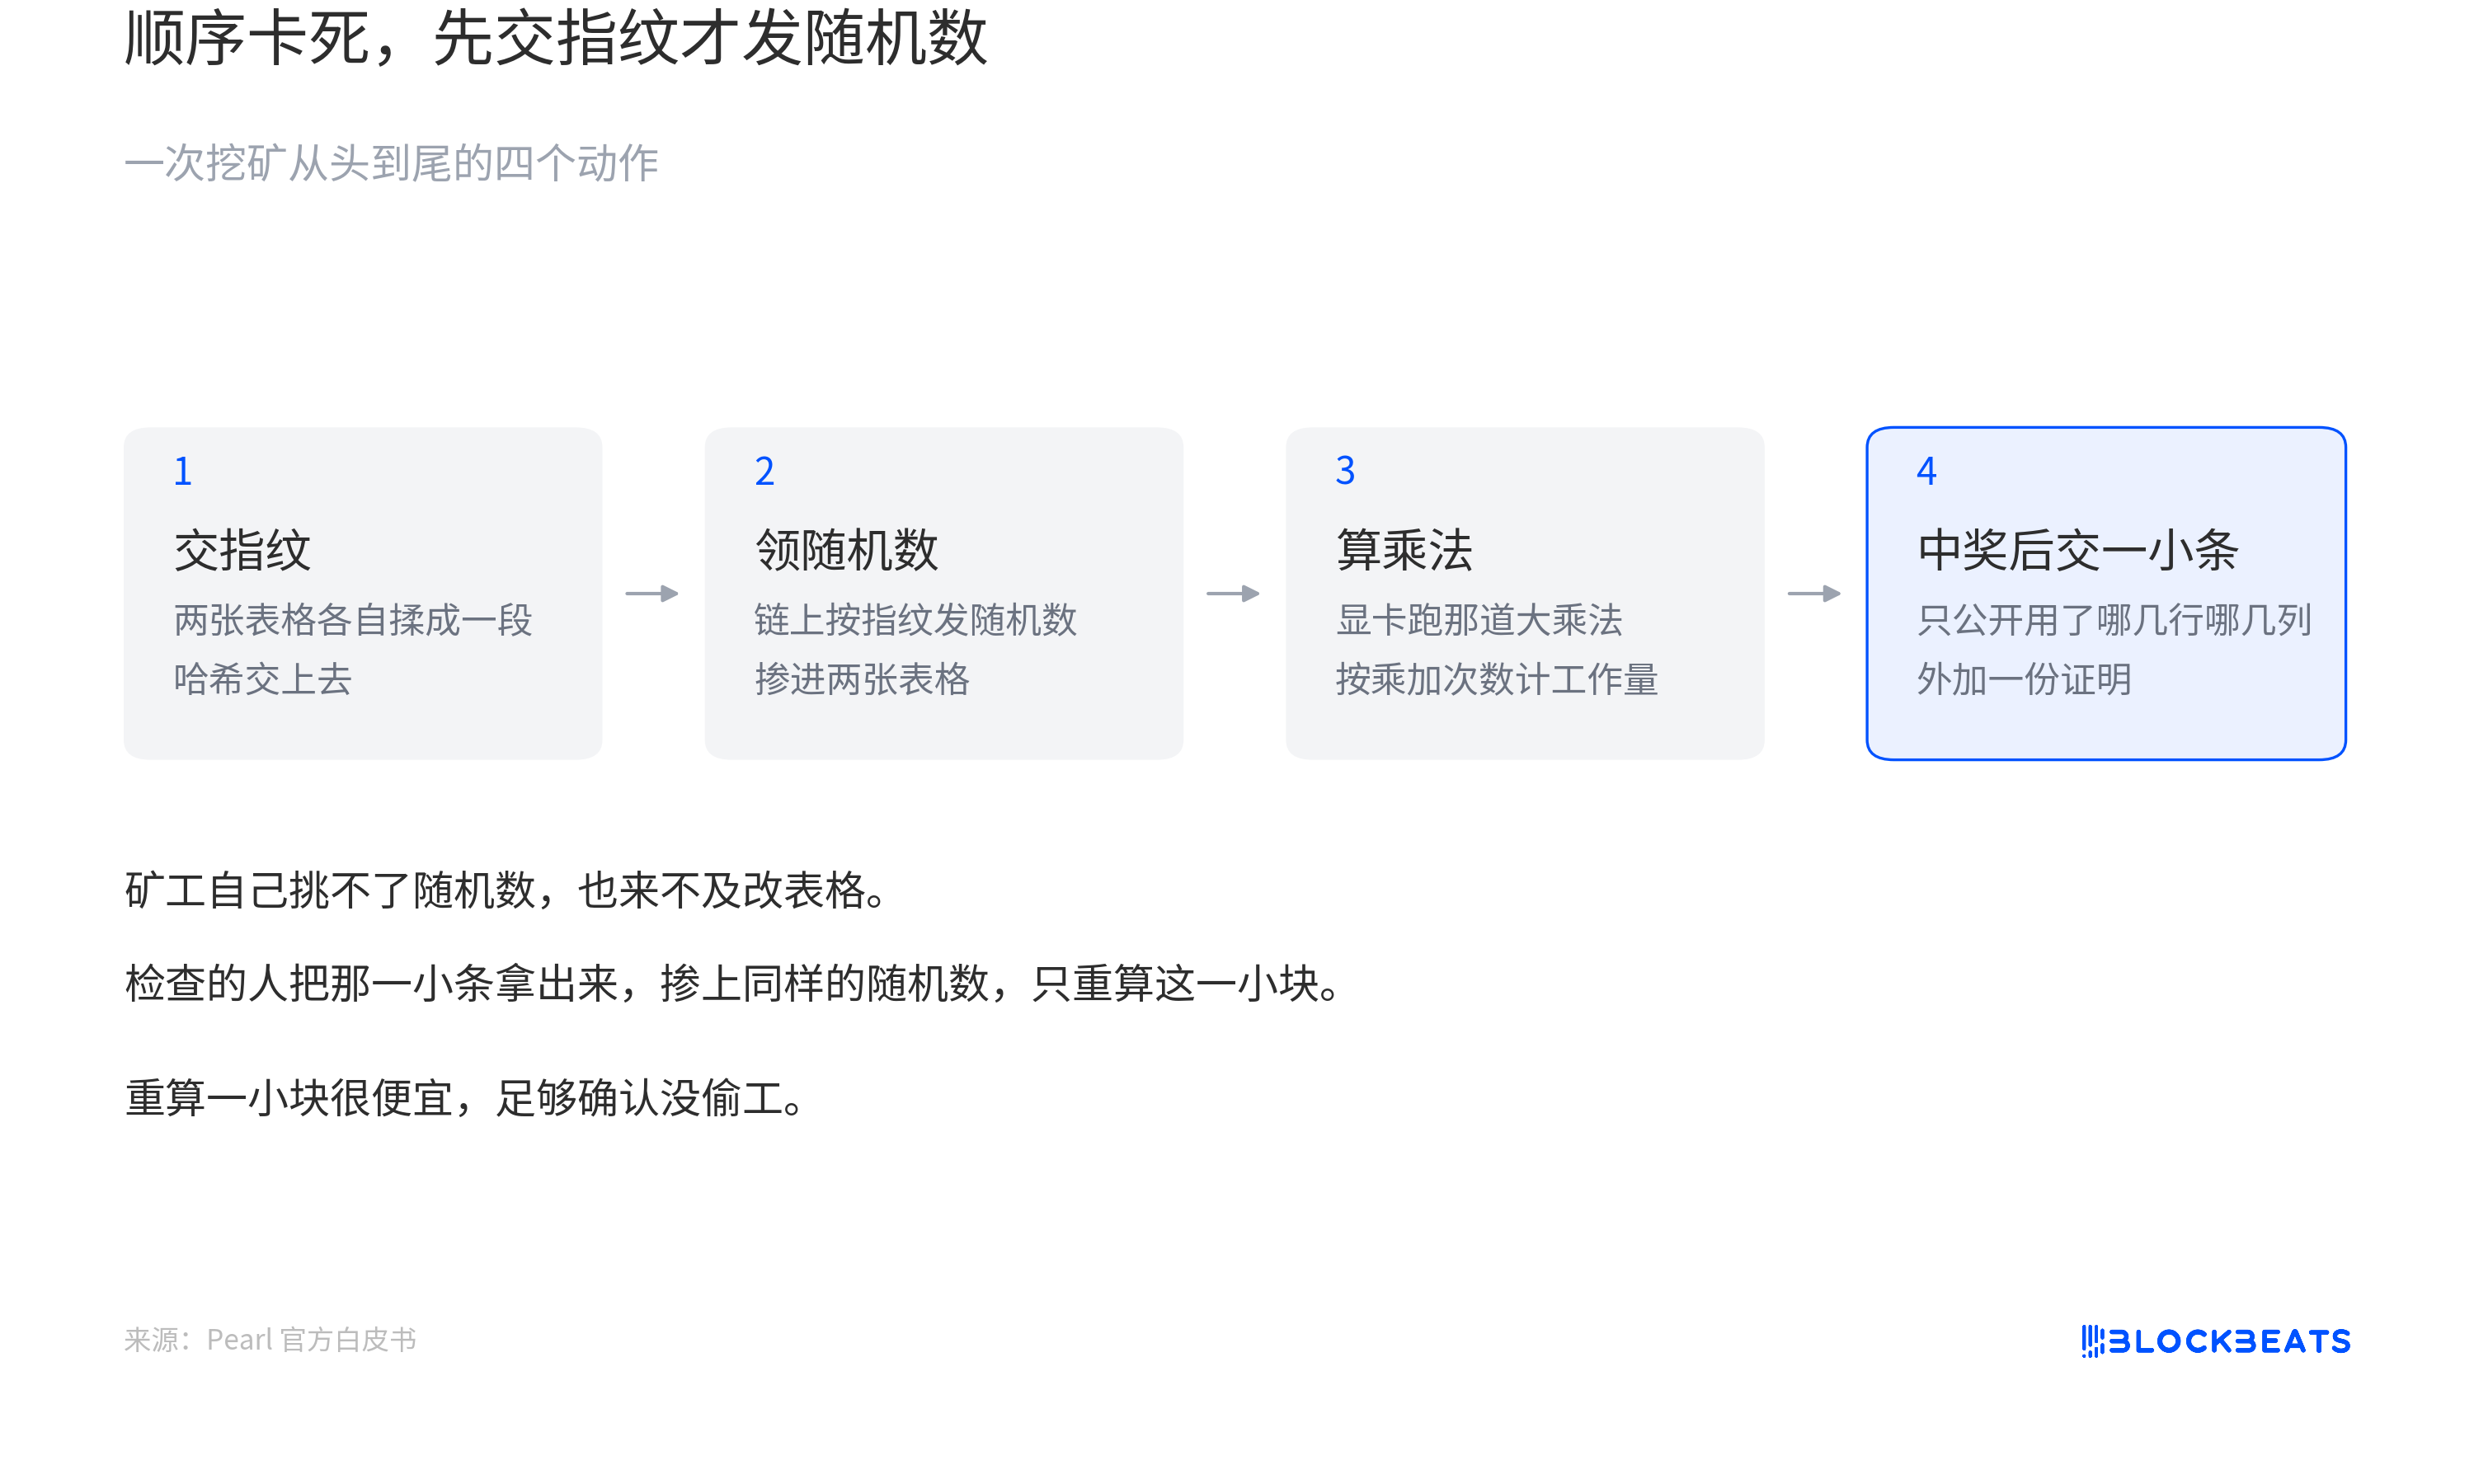
在 Pearl 的流程里,矿工手上有两张表格。他需要先把表格压成一个指纹提交上去。所谓压指纹,就是把表格中的所有数字一起做一次哈希,得到一段很短的结果。链上看到这个指纹后,才会告诉矿工要往表格里加入哪些随机数。顺序被锁死后,矿工就来不及再改表格。
官方把这个过程称为加噪声。更直白地说,就是往两张表格里掺入一批随机数字,掺多少、掺在哪些位置,都由前面的指纹决定,矿工自己不能挑。
如果不加这一步,就会出现捷径。干净的 A 乘 B,与加入随机数后的乘积之间,只差三个修正项。这三个修正项规模不小,但计算成本很低。矿工本来就持有干净的 A 和 B,完全可以先算出干净答案,再补上几个便宜的修正项,拼出加噪后的结果,从而绕过真正昂贵的大矩阵乘法。
因此,协议并不要求矿工直接提交完整结果,而是要求他提交所用到的若干行输入,再附上一份证明。验证者只需要把这一小部分取出来,加入同样的随机数,重算这一小块,再检查指纹是否一致。重算一小块的成本很低,但足以确认矿工没有偷工。
如果这些表格涉及公司权重或用户数据,还可以再叠加一层零知识证明,用来证明计算确实发生过,但不暴露具体使用的是哪两张表。
项目已经推出认证模型和商业接口
从当前公开进展看,Pearl 已经把一部分基础设施搭出来了。
在 Hugging Face 上,pearl-ai 组织名下有 4 个认证模型:Llama 3.3 70B、Llama 3.1 8B、Qwen3 30B 和 Gemma 4 31B。官方称它们为「认证变体」。做法不是重新训练,而是把同一批权重按 Pearl 的量化格式重新压缩,使其能够在插件中实现一边推理、一边挖矿。
按项目给出的数据,精度损失较小。Gemma 4 31B 的 MMLU 从 90.93 降到 90.56。
截至 2026 年 10 月 9 日,这 4 个模型近 30 天下载量在 195 到 6424 之间,点赞数分别为 0、3、5、6。
商业化出口也已有一条。2026 年 5 月,Pearl 与 Together AI 合作上线了一个运行 Gemma 模型的接口。根据 Together 的公告,该接口调用价格比普通接口便宜 25%,差价由代币未来价值抵扣。
模型已经挂出,代码也已开源,但接下来的问题是:网络里实际跑的到底是不是这些真实推理任务。
研究报告:网络算力存在,但有用 AI 产出为零
2026 年 6 月,研究者 Abhinaba Basu 在《The Usefulness Gap in Proof-of-Useful-Work》中测试了 Pearl 的实际运行情况。
报告称,当时全网算力约为 24 EH/s,约等于 32 万张 RTX 3090 级别显卡,估计耗电 112 兆瓦,但有用的 AI 计算产出为零。
作者抽查了 8012 个矿工工作单元。结果显示,这些硬件全部具备推理能力,但主流矿机软件中,与矩阵乘法相关的字符串有 4803 条,与机器学习框架相关的字符串则为 0 条。
他还自己编写了一个矿工程序,用随机数字填充表格,在英伟达、AMD、CPU 和苹果芯片上都跑通,并拿到了矿池认可的 44 个份额。也就是说,在设计上,「提供真实数据让模型算出结果」与「用同一张卡挖币」可以合并;但在实际运行中,两者仍然是分开的。
那网络上实际在跑什么?根据矿池 Kryptex 页面,全网算力已经升至 46.37 EH/s,难度为 2.26 TH,平均出块时间约 203 秒,每块奖励 2271.03 PRL,每日产出约 96.6 万枚,币价约 1.30 美元。过去 6 个月里,算力几乎翻倍,而新增上来的绝大多数算力,仍然是在填随机数字。当前市场上的主要行为,仍是买卡、插卡、填随机数、等待结算。
问题不在乘法真假,而在输入是否真的“有用”
这篇文章用一个比喻解释了 Pearl 当前的症结:如果食堂贴出告示,谁切够 100 斤菜,谁就能领工资,而检查只看有没有切够 100 斤,不看切的是什么菜,那么就会有人拉来一车烂菜叶,切够重量后照样领钱。切菜这件事是真的,力气也确实花了,但厨房并不需要这些叶子。
Pearl 现在卡住的地方就在这里。协议会检查表格指纹是否匹配、结果是否等于两张表相乘、工作量是否达到难度要求,正式设计里还有一层统计闸门,用来拦截明显做过手脚的输入。这些都能查。
但协议并不检查这两张表格究竟来自哪里。矿工完全可以自己构造两张随机数字表格。这样的乘法同样困难,指纹同样合格,也同样可能中块,只是结果没有任何人需要。协议只验证乘法关系,不验证语义。「有用」在这里仍然是商业问题,而不是密码学保证。
这一点并非推测。前述报告中,被抽查的机器都具备模型推理能力,但矿机软件里没有任何推理框架代码;作者自己用随机数字填表格,也拿到了矿池认可的份额。当前全网算力在 45 EH/s 上下,绝大多数仍然是在填随机数字。
从规模差距看,论文还给出一个反事实:如果这套设计真按宣传那样运转,那么当时 24 EH/s 的网络每天本应产出约 770 万 GPU 小时的有用 AI 算力。论文还提出一个「价值毁灭比」指标,Pearl 实测为 1.0,与比特币持平,而 Filecoin 约为 0.64。
矿工为什么不愿意接真实推理订单
矿工不接推理订单,并不只是因为不熟悉,而是因为账算不过来。
论文估计,把推理引擎和挖矿耦合在一起,会损失约 10% 到 30% 的有效算力。这意味着,接入真实推理任务不仅要改软件、适应请求节奏,还要先承担这部分算力损失。币价不高的年份,这笔账很容易变成负收益。
论文也列出了一些可能的解决路径。
第一条路是把表格来源管起来,要求矿工必须使用外部客户提交的表格。Pearl 当前的插件和认证模型,就是朝这个方向推进:把模型和插件交给矿工,如果矿工用真实模型跑推理,那份矩阵乘法就顺手完成了挖矿。问题在于,这仍然是自愿的,接不接单最终还是矿工自己算经济账。
第二条路是检查表格在统计特征上是否像真实模型权重,而不是随手生成的随机数。但论文自己否定了这条路,因为矿工只要调整分布,就几乎可以零成本骗过检查。
还有几条更远的路径尚未落地。比如把模型来源做成可验证签名,这需要模型方先建立公钥体系;使用可信硬件证明数据出处,则需要额外信任芯片厂商,而且会拖慢速度;在奖励机制上做区分,让真实数据获得更高回报,则需要先有一批愿意付费的真实客户。
开发团队与同类项目的不同押注
Pearl 的开发方是 Pearl Research Labs。Omri Weinstein 是联合创始人兼 CEO,这一头衔来自 Together AI 的合作公告。他的研究方向是复杂性理论,在希伯来大学任教,也是前述奠基论文的作者之一。
另一位作者 Ilan Komargodski 也出现在 Hugging Face 的组织成员名单中,但其具体身份是员工还是顾问,目前没有公开来源可以证实。能够对应上的还有 Erez Badash,他是讨论 GPU 逐位复现的 Hawkeye 论文第一作者。
与其他项目相比,Pearl 的押注更窄。Bittensor 的做法是让验证者给矿工提交的模型输出打分,分数由名为 Yuma 的共识决定;io 的模式则是按需把 GPU 租给机器学习任务。Pearl 押注的是另一件事:出块所需的那道矩阵乘法本身,就应该有人愿意购买。
它真正赌的是,推理需求最终会大到足以吃掉出块算力。到了那个阶段,矿工会自己算明白,接真实订单比填随机数字更划算。如果这一步始终到不了,那么 Pearl 仍然只是一条换了数学形式的显卡矿链,算出来的东西与 AI 同源,但与任何具体用户的真实需求没有直接关系。