
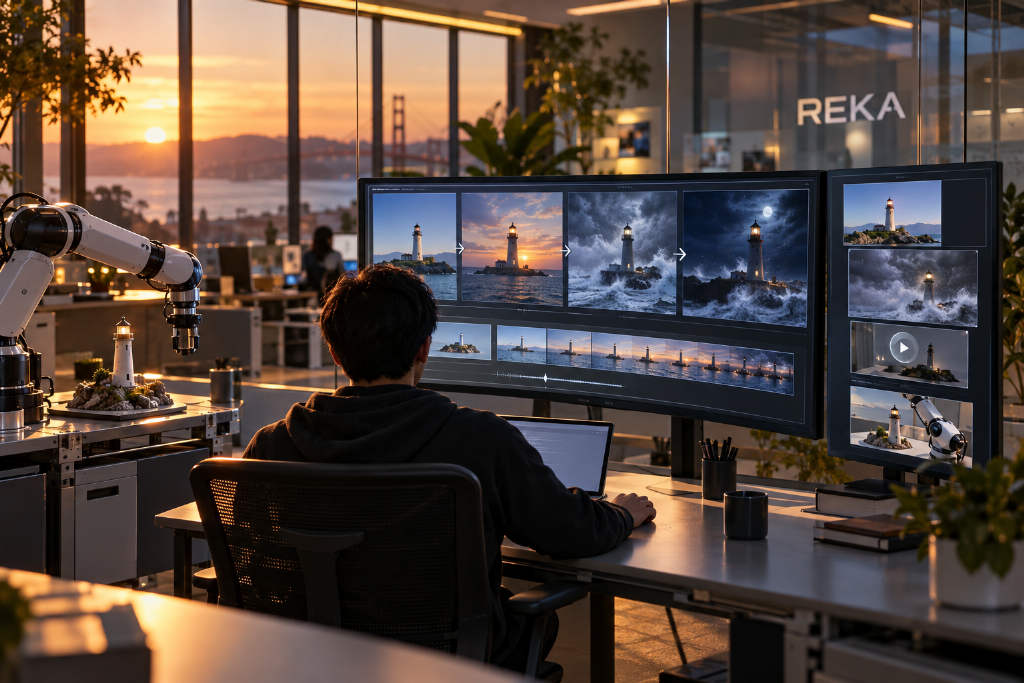
由前 DeepMind、Google Brain 和 Meta FAIR 研究人员创办的美国 AI 公司 Reka 发布 190 亿参数模型 Rho-1。该模型可在一次对话中同时处理文字、图片和视频,并输出机器人动作。
按照官方展示,Rho-1 可以先生成一张灯塔图片,再让灯塔动起来、修改视频中的天气,随后继续回答两段视频之间的区别。前面生成的内容会保留在同一上下文中,不需要再交给另一个模型处理。
支持在生成过程中继续修改视频
Rho-1 还支持在视频生成过程中继续接收指令。视频向前生成时,用户可以临时要求改变天气、运动方向或其他内容,后续画面会继续按新指令调整。
基础版生成速度约为实时的 0.79 倍。蒸馏版则将生成步骤从 99 步压缩到 8 步,Reka 测得其约 1 秒可以生成 5.3 秒视频。
机器人动作也接入同一模型
在机器人任务上,Rho-1 一边预测摄像头接下来会看到什么,一边输出机器人的动作信号,不再需要单独的规划模型决定如何移动。当前官方展示仍限于 LIBERO 仿真任务,尚未公布实体机器人的测试结果。
定位偏向连续交互
类似的统一模型今年已经出现。英伟达 Cosmos 3 也可以统一处理文字、图片、视频、声音和动作。相比之下,Rho-1 更偏向连续交互,重点展示同一上下文内的反复生成、修改和继续推理。
仍处研究预览阶段
Reka 表示,Rho-1 从零训练,使用 320 张 H100,训练时间约 3 个月。当前视频分辨率为 672×384,长视频仍可能出现画面结构漂移,视频定位和局部编辑也不够稳定。
目前,Rho-1 仍处于研究预览阶段,权重和 API 都未开放。
本文最初由 Bit.Fan 发布。 欲了解更多加密货币新闻与市场洞察,请访问 www.bit.fan.