
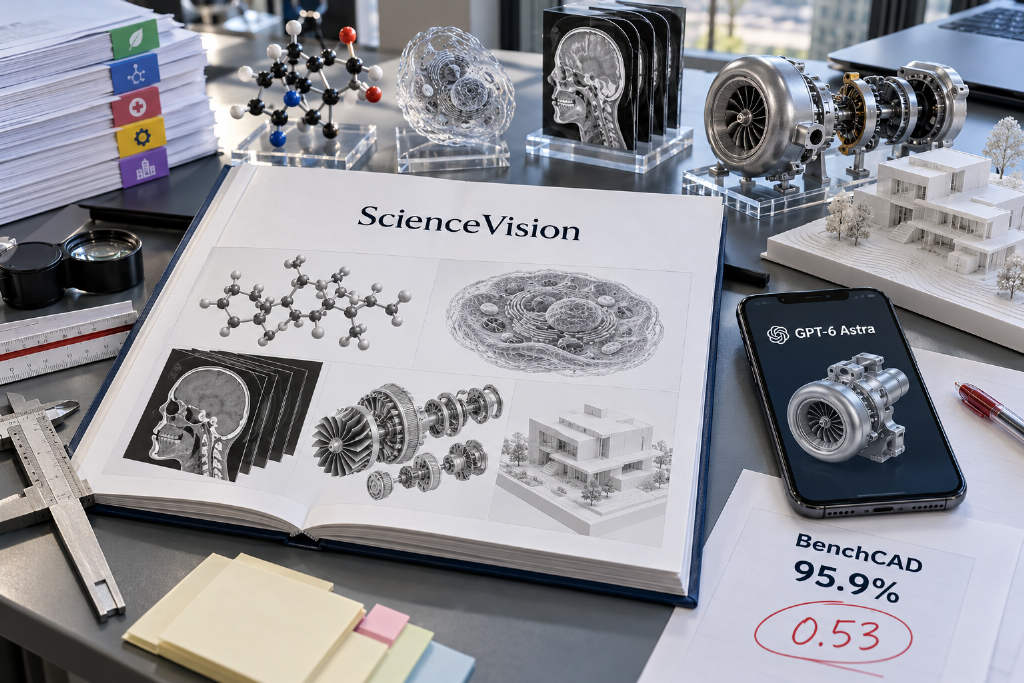
前一阵,GPT-6 Astra 在 X 上展示绘制 CAD 的视频走红。视频里的涡轮增压器把零件逐个建模,不仅可以正常转动,还能一键原地拆解展开,视觉效果很强。与此同时,GPT-6 Astra 的 BenchCAD 跑分达到 95.9%,评论区里已经有人开始讨论 CAD 工程师会不会受到冲击。
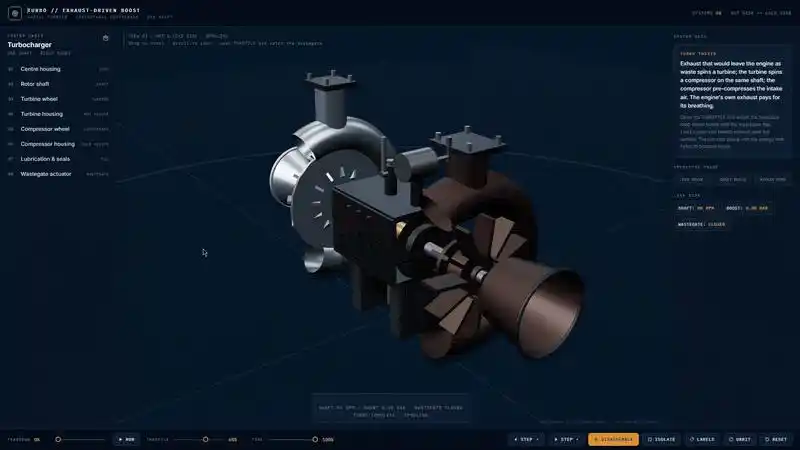
不过,工程师给出的反馈并不乐观:这些零件看起来像样,不等于能直接送上生产线。模型能复刻 CAD 的界面和外观,不代表它真的理解了科学原理、几何结构,以及部件之间的关系。
最近出现的一项 benchmark,正是冲着这个问题来的。它不只看模型能不能把三维对象“画出来”,而是按专业工程师的检查流程,逐项核验结构关系、几何细节和测量结果,判断模型生成或分析的三维对象是否符合科学与工程要求。
ScienceVision 覆盖 5 个科学领域、250 道真实三维题目
这套 benchmark 名为 ScienceVision,由 UniPat AI 和视觉推理实验室 Elorian AI 推出。团队给出的出发点很直接:AI 能不能像科学家一样观察和推理。
ScienceVision 不是只测工程制图。它覆盖生物、化学、医学影像、建筑和机械 CAD 共 5 个科学领域、22 个子领域,包含 250 道基于真实三维数据构建的题目。模型需要通过自主操作三维对象,完成观察、测量和分析。
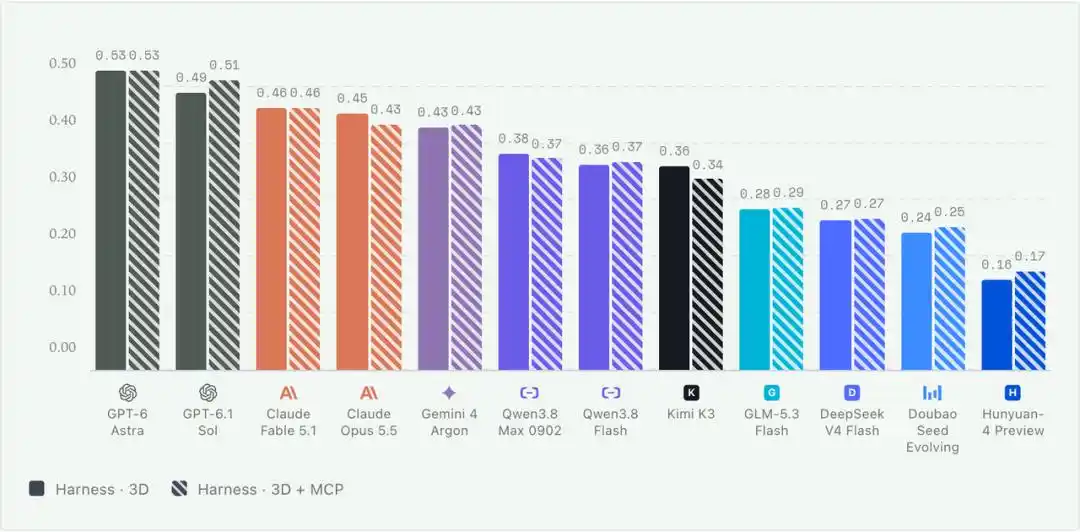
从现有结果看,评测纳入了 GPT-6 Astra、Claude Fable 5.1、Gemini 4 Argon、Qwen3.8 Max 等 12 个当前前沿的开源和闭源大模型,没有任何一个模型能在五个学科里同时领先。
成绩最高的是 GPT-6-Astra 搭配 Codex,得分只有 0.53,满分为 1 分。也就是说,在 BenchCAD 上拿到 95.9% 的模型,到了三维科学理解与推理的考场,只过了满分的一半。
题目怎么出:不是看图说话,而是按专家流程检查
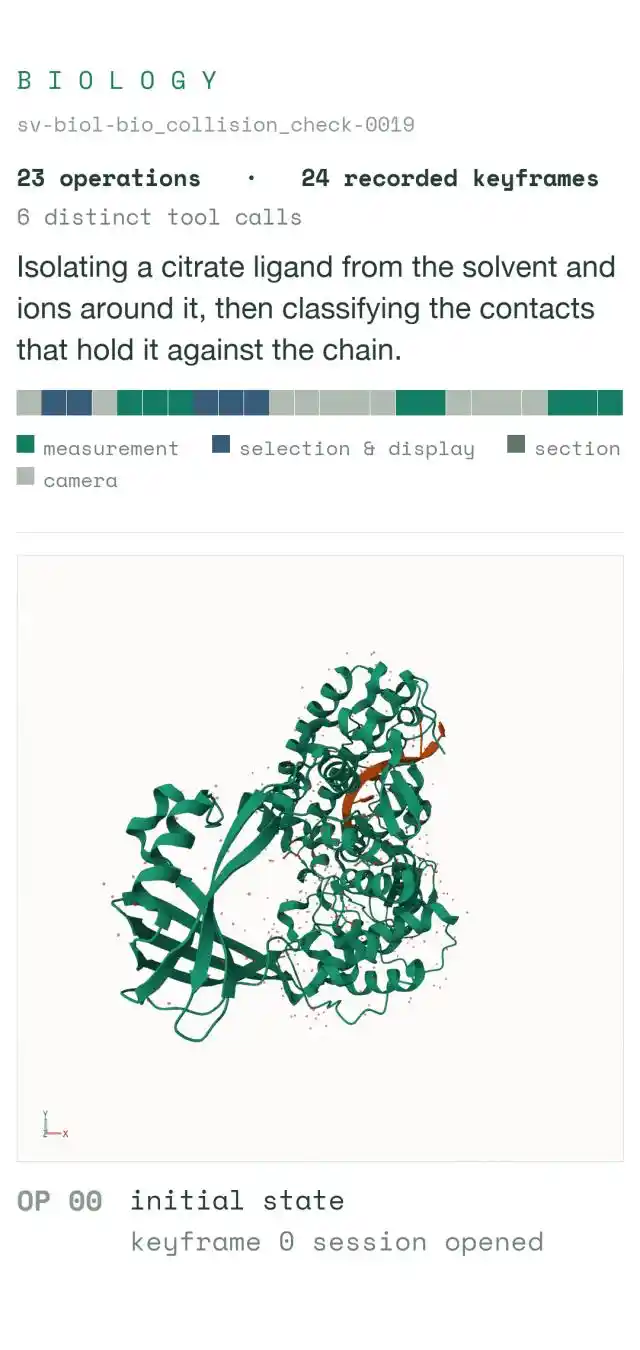
ScienceVision 的 demo 展示了五个学科各自的一段检视操作。所用的 3D 工具,是按照领域专家处理三维源数据的实际方式建模,尽量还原真实的 3D 观察场景。
- 生物题目里,整个蛋白质被隐藏,只留下一个柠檬酸分子和旁边几个离子,要求测量它们之间的距离。
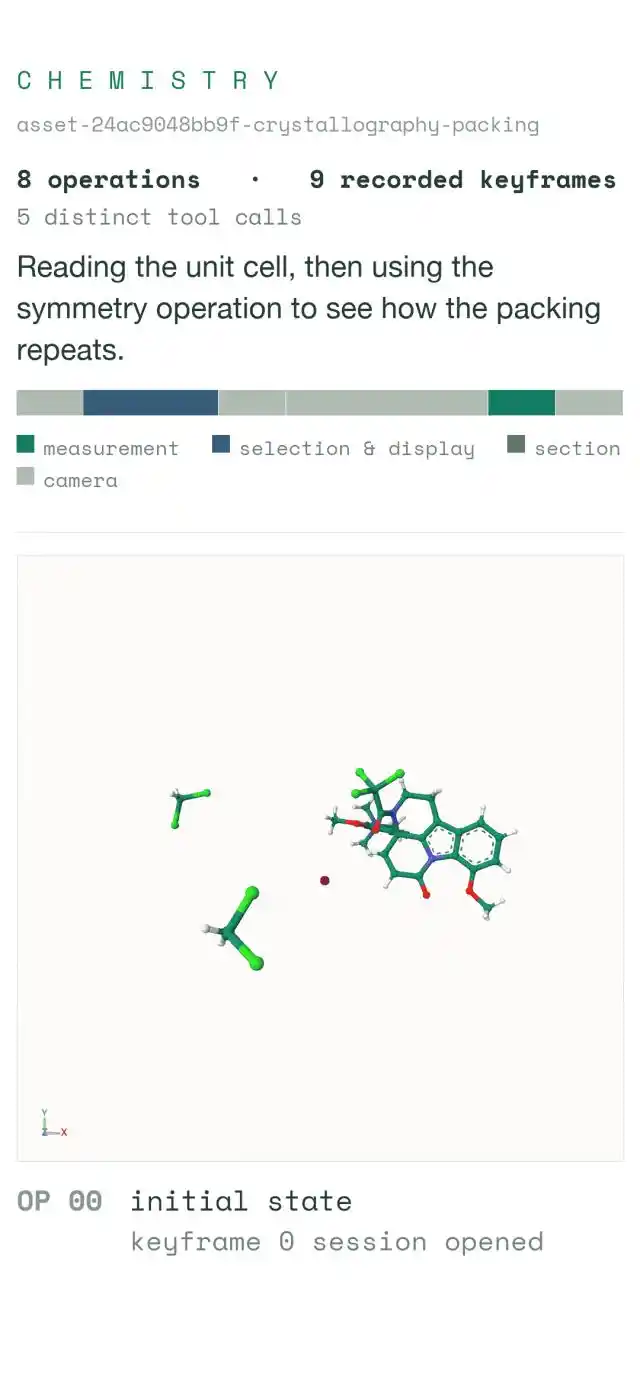
- 化学题目只有 8 步,需要框出一个晶胞,再用对称操作观察它如何一层层堆叠。
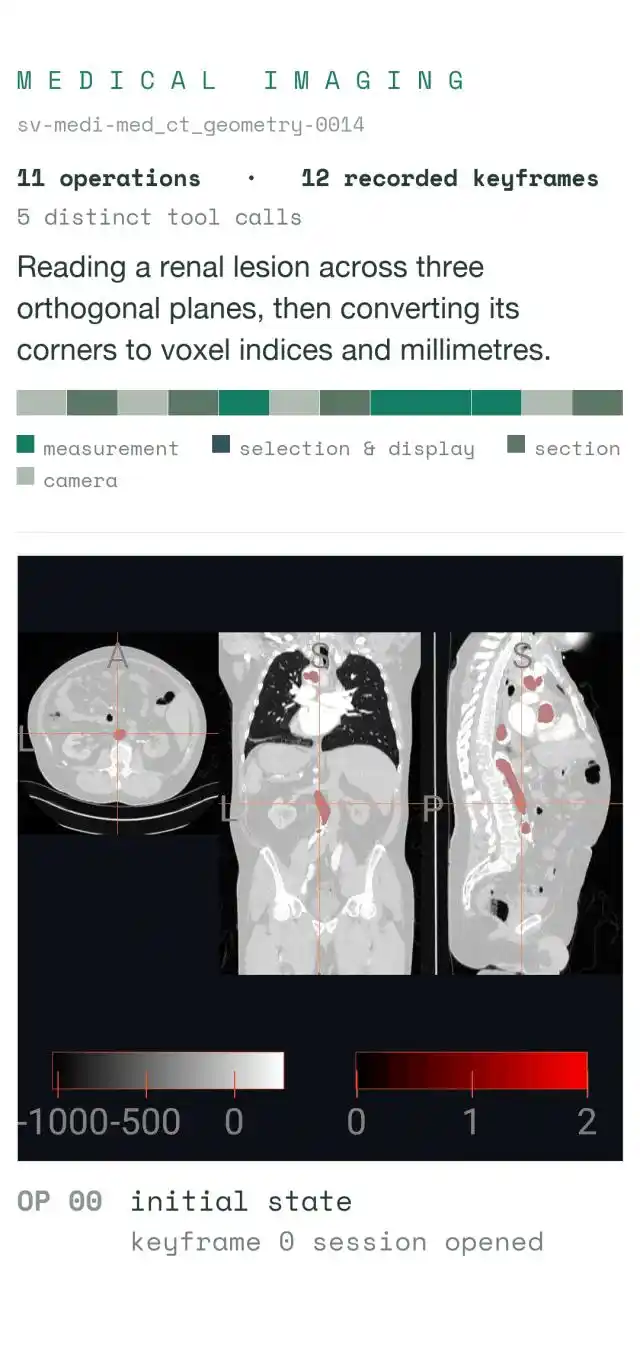
- 医学影像题目中,CT 需要从三个方向来回切片,找出肾脏病灶的边界。
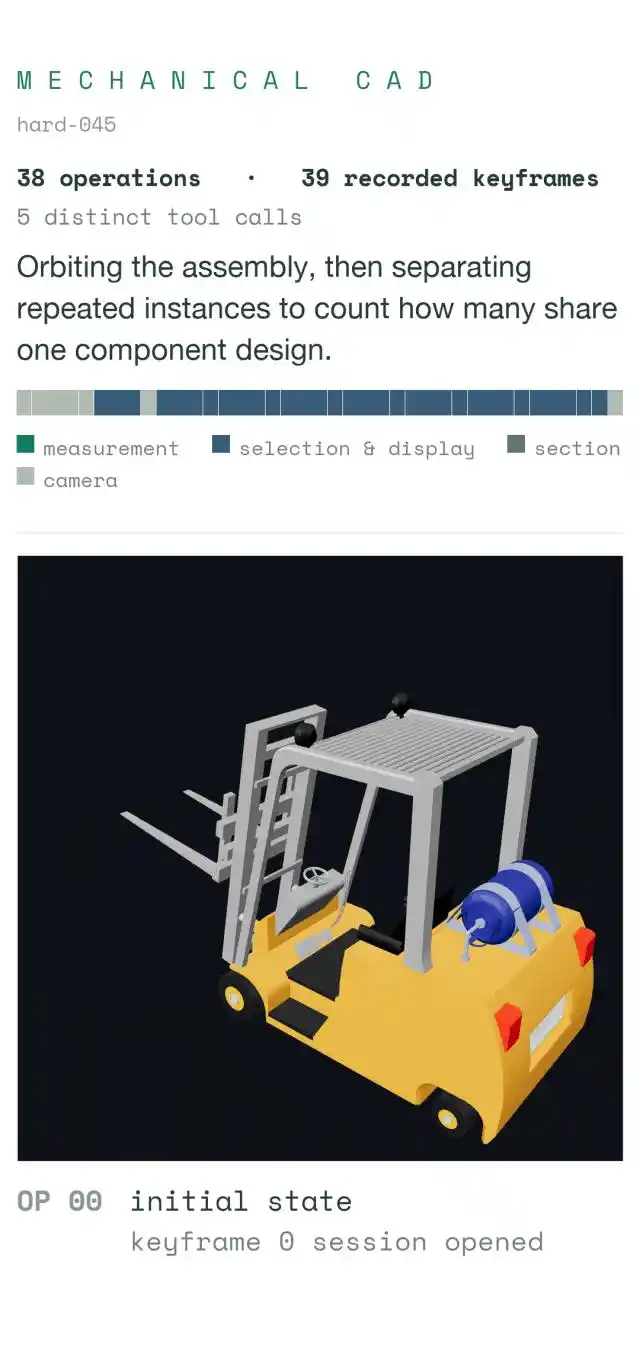
- CAD 题目给出一台叉车,要逐个点开零件,统计有多少个外形相同的部件。
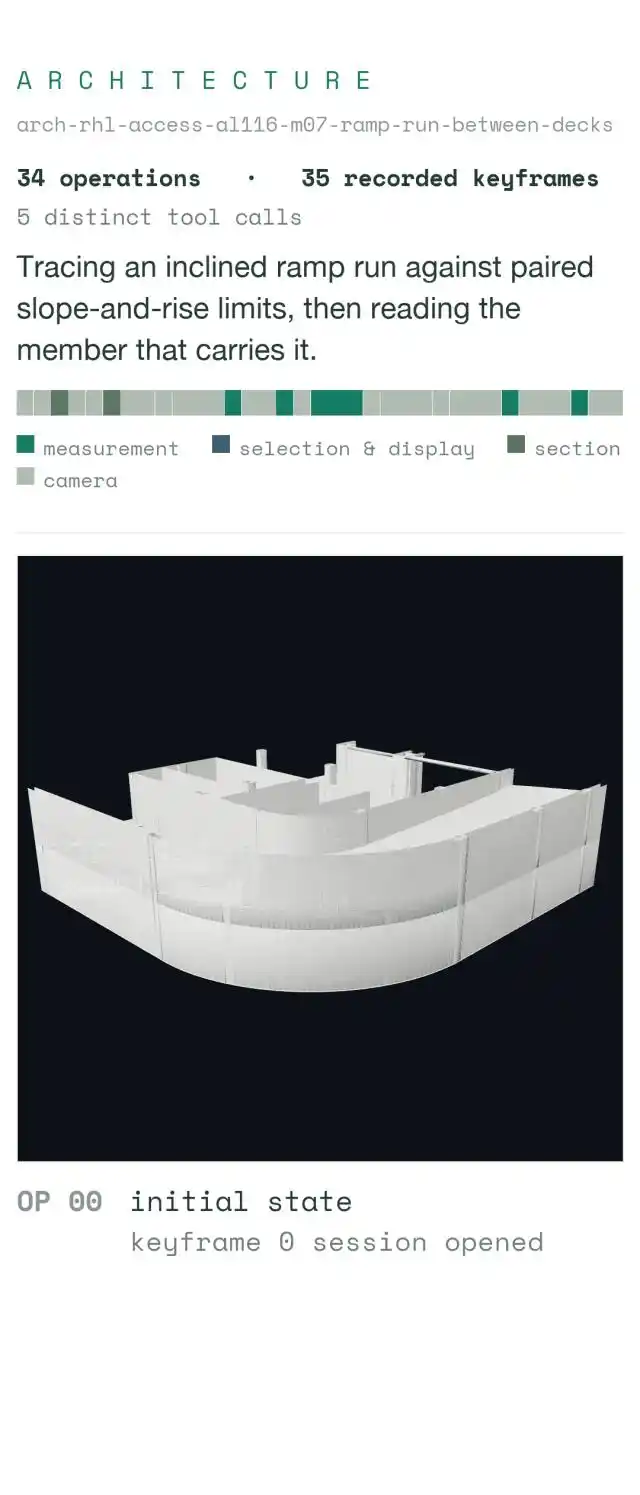
- 建筑题目则要求沿着一条坡道测量长度和高差,判断坡度是否超标。
这些操作本身并不复杂,核心动作无非是转、点、量。难点在于每一步之前都要先判断该往哪转、点什么、量哪里。没有扎实的观察、理解和推理,很难做出正确判断。
ScienceVision 还开放了这五道 demo 题的原始文件和检视工具,用户可以自己切换 3D 或平面视图,体验真实三维检视过程,看看这类题目到底在考什么。
为什么要做这套题:科学 3D 评测长期缺位
过去并不是没有 3D 理解与推理基准,但大多集中在室内场景理解、具身交互、抽象结构推理等方向,主要服务于日常场景感知、机器人操作或工业设计等通用任务。
真正面向科学领域的 3D 理解与推理基准,长期处于空白状态。现有工作里,只有医学影像、机械工程等少数场景有专门基准,而且还没有形成体系化的科学 3D 推理评测框架。
问题在于,科学研究天然依赖对真实三维世界的观察和推理。化学家要定位原子、测量几何关系;放射科医生要在不同切片之间追踪结构;建筑工程师要切换视角、排除遮挡、确认构件连接关系。
这些工作都不是看一眼图片就能完成。人类专家会根据经验决定往哪看、怎么看、量什么,再结合专业知识得出结论。ScienceVision 试图考察的,正是 AI 在这一流程中的能力。
题目和数据摆在模型面前,模型要自己决定看哪里、怎么查。文中把这种能力类比为「斯坦门茨画线」:画一条线值 1 美元,知道该把线画在哪里值 9999 美元。可靠的观察和理解,就是检验的第一步。
过去科学领域的 3D 评测还存在一个现实问题:不同学科的问题设定、任务输入和评估方式差异很大,3D 文件格式不统一,渲染后的交互逻辑也不同,表达形式更不一致。ScienceVision 想填补的,正是这个跨学科统一评测的空白。
250 道题背后:66 名专家投入 482.98 小时
ScienceVision 涵盖生物学、化学、医学影像、机械 CAD 和建筑学五个学科。每个学科 50 道题,共 250 道,横跨 22 个子领域。
每道题由四部分组成:一份真实的 3D 源数据,例如分子坐标、CT 体数据、机械装配体或建筑模型;一个领域问题,明确看什么、在哪找、用什么单位和坐标;一份作答要求,规定返回内容和格式;以及一份由专家标注的参考答案。
答案采用确定性规则核验,不使用语言模型充当裁判。没有「大致正确」的空间,达到就是达到,没有达到就是没有达到。
这种带确定性校验的 benchmark 还有一层潜力:它几乎可以直接转成强化学习环境。答对给奖励,答错不给,不需要再引入另一个模型做评判。
但真正难的是把题做出来。首先,题目必须在科学上有意义,而且确实依赖三维证据。构题时要从具体科学对象出发,明确观察目标、判定条件和所需证据,并确认题目能在给定环境中被解答。每道题都要同时满足专业成立、视觉目标清楚、答案可复核。
其次,不同领域的数据必须都能被正确观察和测量。分子坐标、CT 体数据、机械 CAD 和建筑模型在格式、尺度、坐标约定和操作方式上都不一样。转换和展示过程中,既要保留关键结构信息,也要提供适合不同对象的查看、隔离、切片和测量能力。
最后,可信答案和证据过程要靠领域专家建立。专家需要检查问题的真实性和相关性,亲自观察对象、计算或确认答案,记录关键步骤,并参与审核和返修。五个领域的规则不同,这些工作都离不开对应学科的知识和经验。
整套流程是自动化和人工接力完成的。先由自动化管线从三维资产库中挑选适合出题的对象,测试在查看器里能否正常显示和测量,再按模板生成候选题,经过规则筛选后打包。随后由专家在 3D 标注平台上审题、改题,亲自旋转、隔离、测量,写下参考答案,记录操作轨迹,最后再经过质量审核,不合格的题目会被打回。专家的反馈还会反向喂给出题管线,用于减少下一轮错误。
经过造题、专家审核、自动修题和管线改进的多轮循环,最终形成这 250 道题。
UniPat AI 为此搭建了覆盖五个领域的专家平台,维护 66 名领域专家,累计投入 482.98 小时。其中化学 113 小时,机械 CAD 116 小时,医学影像 103 小时,建筑 77 小时,生物 74 小时。
专家负责审查问题、标注答案、记录操作过程,并参与多轮审核和返修。按照团队的说法,ScienceVision 要测的是 AI 是否具备专家级观察能力,因此答案本身也必须由专家建立,才更有说服力。
前面 demo 中那样的操作记录,在 250 道题里每一道都附带,而且逐步保存了关键帧。这些记录把科学观察从一个只能看到结论的黑箱,变成了可以逐步回放的过程,也为未来训练 AI 学会「看」提供了现成的对标数据。
三种作答方式同场比较:给更多数据和工具,提升也有限
在评测设计上,ScienceVision 用同一套 250 道题比较了三种证据获取方式。
- 第一种是直接给模型原始三维数据,让它自己写代码分析,相当于把全部原始实验数据交给它自己计算。
- 第二种是在原始数据基础上,再提供一套交互检视工具,支持旋转视角、隔离结构、切片浏览、测量距离和角度,相当于不仅给数据,还给了一台显微镜。
- 第三种只给六张固定角度的二维渲染图,考察模型能从静态图像里看出多少信息。
三种方式使用同一套评分标准,因此可以直接比较一个问题:数据更多、工具更全,模型表现到底会不会更好。
结果:最高 0.53 分,没有模型五科全优
最终结果并不高。最高分是 0.53,由 GPT-6-Astra 搭配 Codex 获得,刚刚超过满分的一半。而且这还不是严格意义上的答对率,而是包含部分得分的平均指标,真正完全答对的比例还要更低。
比总分更有意思的是学科差异。没有任何模型能在五个学科里全部领先。
- GPT-6 Astra 在建筑、机械 CAD 和化学三科领先,得分分别为 0.458、0.580、0.609。
- 生物学科由 Claude Fable 5.1 领先,得分 0.650。
- 医学影像则由 Claude Opus 5.5 领先,得分 0.399。
医学影像的表现尤其值得注意。CT 本身就是一叠切片,放射科医生日常阅读的也是切片,模型训练时也见过大量二维医学影像。但当输入变成带轴序和体素索引的三维数组后,模型显然没有那么熟悉。
如果只给六张固定角度的二维渲染图,分数会掉得更明显。该设置下,表现最好的 Claude Fable 5.1 也只有 0.30,GPT-6 Astra 为 0.25。
换句话说,只给照片,模型很难看出来;给到三维数据后,分数确实会上升,但论文也提醒,这些分数里有一部分可能来自代码直接读取坐标并计算,而不一定意味着模型真的“看见了”。
更扎心的是,给了交互工具,提升也不明显。榜单前五的模型中,加入交互检视工具后涨幅最大的 GPT-6.1 Sol 也只提高了 0.02;GPT-6 Astra 在两种设置下差距不到 0.01;Claude Opus 5.5 甚至还下降了 0.02。
论文还提到一个细节:即便在工具模式下,模型依然会去读取原始坐标文件。也就是说,给它一台显微镜和一张数据表,它还是更愿意看数据表。
医学影像是最出人意料的一项。模型的操作次数大约是专家的三倍,但得分却是五个学科里最低。这说明当前前沿模型即使拿到最充分的 3D 数据和工具支持,在真实科学任务中的观察与推理能力,仍然距离专家水平很远。
点得更多,不等于会观察,也不等于会推理。
ScienceVision 想解决什么:统一框架下衡量 AI 的三维科学观察边界
在 ScienceVision 之前,科学多模态评测并非不存在,但多数只覆盖单一学科,只看二维图片,评分规则也各自为政。
ScienceVision 的价值,文中归纳为三点。
第一,题目是真三维。模型拿到的是分子坐标、CT 体数据、机械装配体、建筑模型这样的源文件,而不是平面截图。答题时需要用领域知识解释三维结构证据,有些题还要求先从观察中识别目标,再继续做拓扑和几何推理。
第二,工具按专家工作流设计。视角切换、目标隔离、切片浏览、科学测量等检视操作通过 MCP 向模型开放,具体能力取决于查看器本身。看哪里、怎么看、量什么,都由模型自己决定。
第三,评分是确定性的,而且五个学科使用同一套规则。每道题都有参考答案和预设规则,答案的各个组成部分会被分别核验,再按模型配置和学科汇总得分。不依赖另一个模型打分,因此化学分子和建筑构件的成绩第一次可以放在一起比较。
文中还提到,与 ScienceVision 最相关的 SciVisAgentBench 同样支持三维交互检查,但两者评测目标不同。ScienceVision 在五个学科中采用同一类受领域知识约束的结构性问题,并配套结构化领域问题和逐题参考答案评分;SciVisAgentBench 则主要围绕科学可视化软件中的任务展开,评估 Agent 生成的可视化与分析结果是否符合任务要求。
按照文中的说法,ScienceVision 第一次在统一框架下衡量出了 AI 三维科学观察的能力边界。知道差距在哪里,才知道后面该怎么追。
文章最后写道,下次再有人宣布「AI 科学家来了」,可以先让它把这 250 道题做完。
本文来自微信公众号「新智元」,作者为 ASI启示录。


