
海豚投研在一篇围绕闪迪的长文中表示,闪迪在剥离传统机械硬盘业务后,已将重心完全转向 NAND 闪存市场,并试图借这一轮行业回暖改善业绩。文章延续上篇对 AI 推理与闪迪业务重估的讨论,继续拆解三个问题:AI 浪潮到来前,NAND 是怎样的行业;为什么 NAND 供给总是陷入「减不掉」的循环;以及同属存储基础设施的 DRAM 与 NAND,为什么会走出不同的周期轨迹。
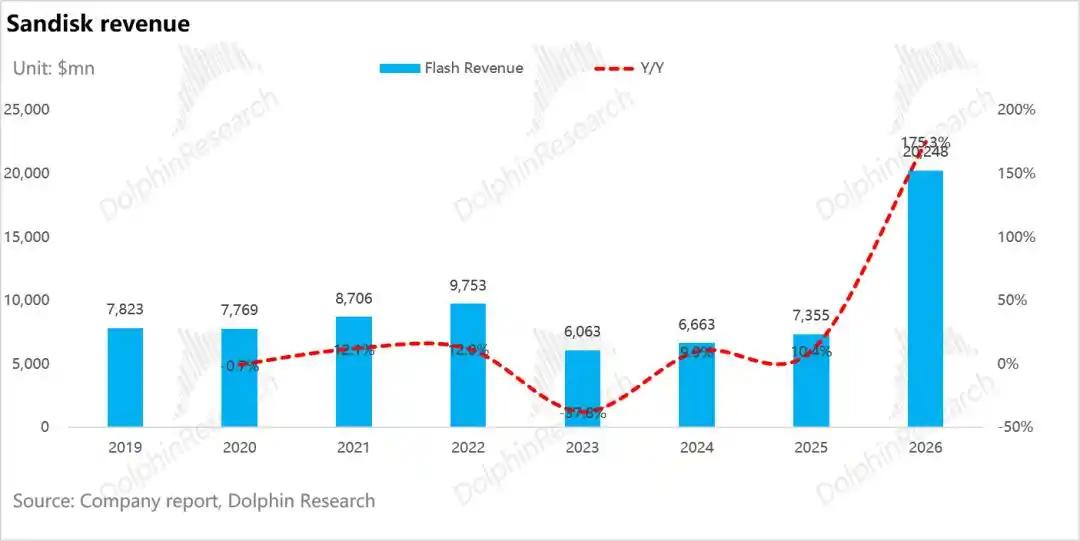
闪迪量增价跌,收入六年反而回落
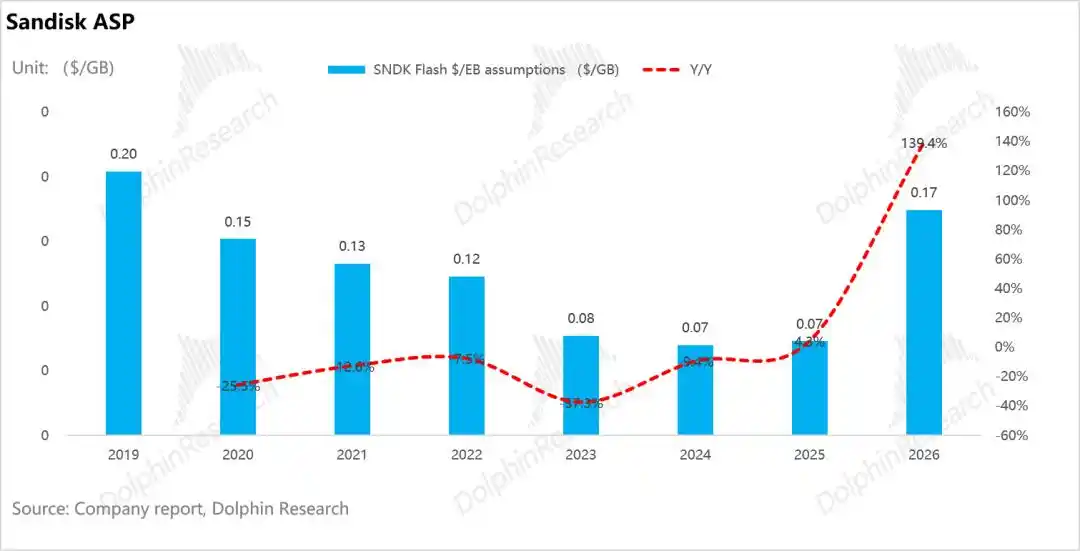
文章称,把闪迪 2019—2025 年闪存业务拆成出货量与价格两条线,可以看到一个少见的制造业特征:bit 出货量从 38 EB 增至 101 EB,六年增长 166%;但每 GB 均价从 0.206 美元降至 0.073 美元,跌幅达到 65%。最终,闪存收入没有随出货同步增长,反而从 78.2 亿美元微降至 73.6 亿美元,回落 6%。
海豚投研据此认为,NAND 行业的核心矛盾在于,技术进步带来的成本下降很难沉淀为制造端溢价,更多会被传导给下游市场。「做大量」与「做大收入」之间,并不存在稳定的正向关系。
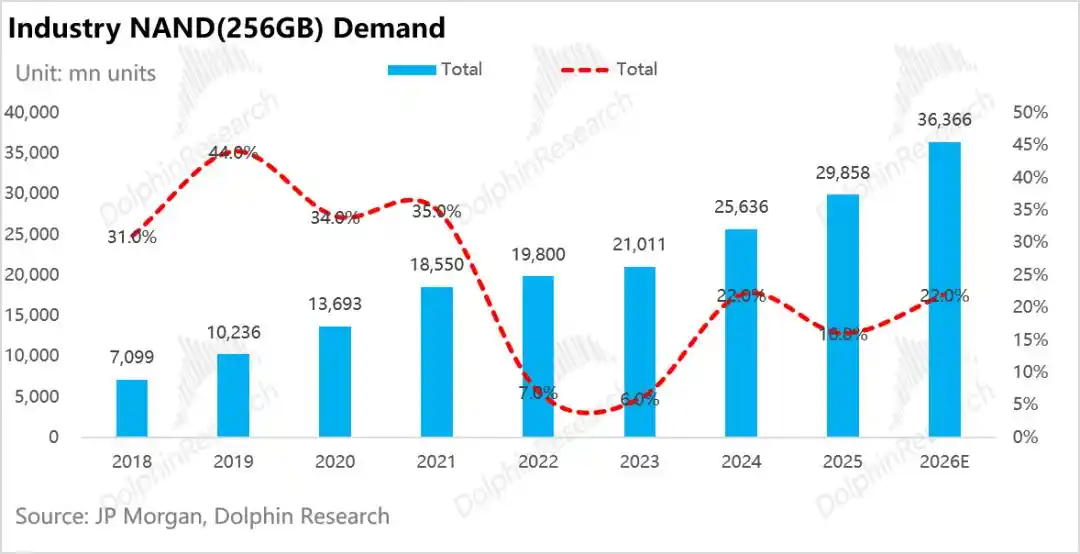
2018 至 2021 年需求高增,2022 至 2023 年突然失速
文章指出,2018—2021 年,NAND 下游需求持续保持 30% 以上增速,年增幅在 34% 至 46% 之间,主要来自三方面。
- 智能手机普及与容量升级,推动手机端 NAND bit 需求在 2018—2021 年间年均增长 34%;
- PC 从 HDD 向 SSD 全面切换,SSD 渗透率从约 50% 升至 90% 以上,2019—2021 年客户端 SSD bit 需求连续三年增速超过 34%;
- 企业级 SSD 扩张,云厂商服务器 SSD 部署加速。
但到 2022—2023 年,需求增速骤降至 6%—8%。文章列出四个拖累因素。
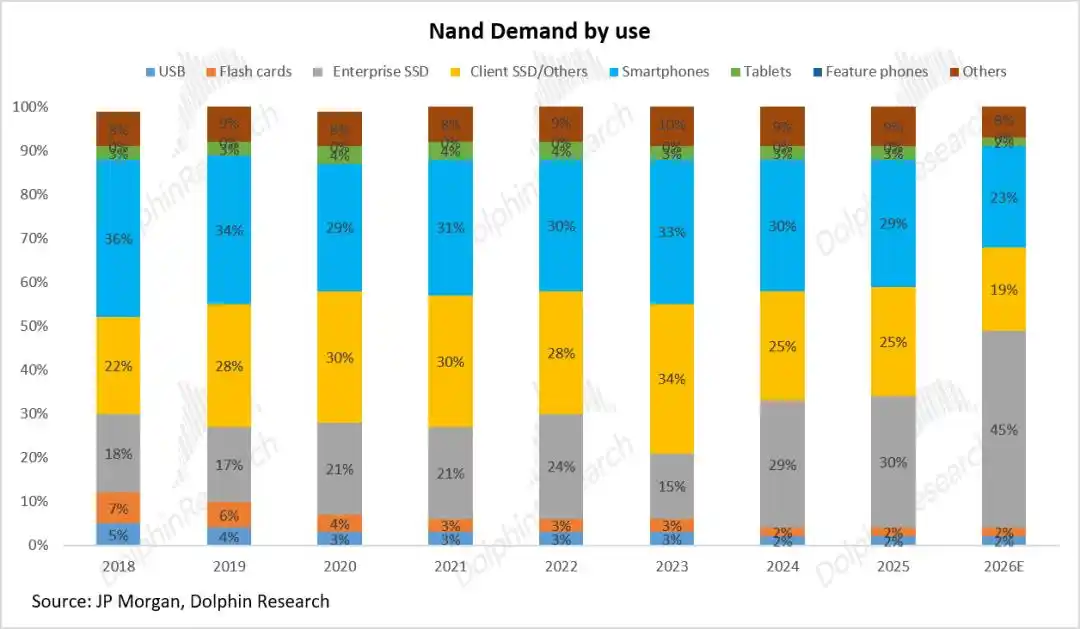
其一,手机市场全面走弱。作为 2023 年约占 bit 需求 33% 的最大单一终端,手机在通胀、利率上行以及 2021 年疫情透支换机需求的影响下,bit 增速从 2021 年的 46% 降至 2022 年的 2%。
其二,PC 市场回落。2020—2021 年居家办公带来的需求提前释放后,2022 年全球 PC 出货同比下滑 12%,2023 年继续下滑 10%。
其三,企业级 SSD 降温。标准服务器在 2021 年投资高峰后进入消化期,企业级 SSD bit 需求增速在 2022 年从 34% 降至 20%,2023 年进一步转为 -33%,而当年 AI 服务器尚未形成足够的新增需求来对冲。
其四,库存牛鞭效应放大了收缩。三大终端同时去库存,原厂库存从 6 周升至 16 周。文章称,跌价预期会自我强化:客户因预期价格继续下跌而推迟采购,转向按需下单;订单萎缩又加速价格下跌,反过来验证此前预期。
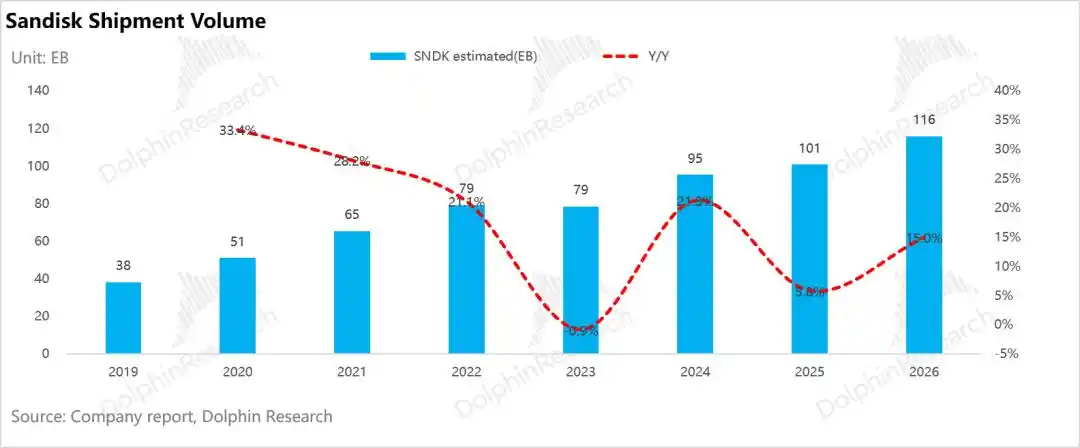
以闪迪为例,2023 年出货量基本持平,但每 GB 均价与收入同比均下降 37.8%;同年行业收入约下降 37%,ASP 下降 42%。文章认为,这说明收入下滑几乎完全由价格驱动,销量并未对下行形成额外拖累。
海豚投研将这一特征与钢铁、化工、航运等传统周期行业作对比。后者在下行期通常表现为需求萎缩、销量下滑、量价同向承压,并通过减产来推动价格企稳;而 NAND 即便在最差年份也出现了减产动作,出货量却没有明显缩水,价格反而单独大幅下跌。
减产力度空前,但 bit 供给仍在增长
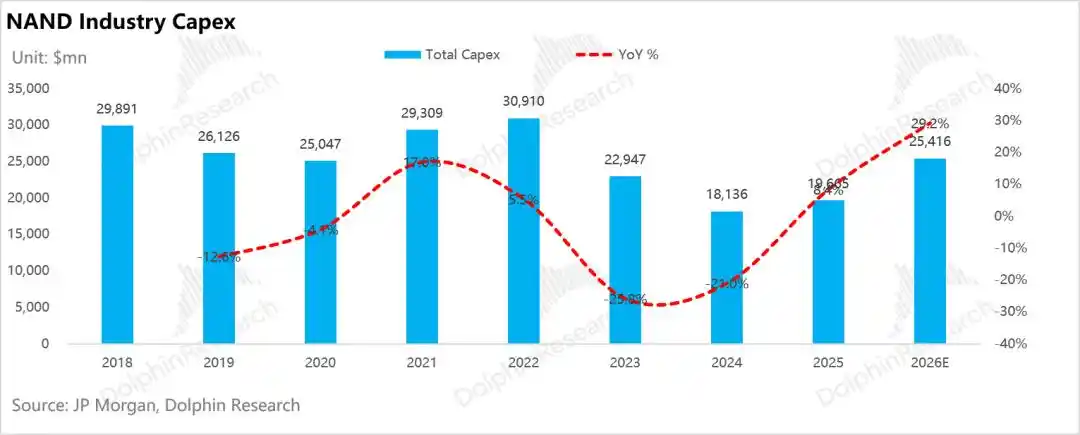
文章称,NAND 行业在供给端并非没有采取措施。资本开支方面,行业 CapEx 自 2022 年 309 亿美元峰值连续两年下降,2024 年降至 181 亿美元,累计收缩 41%。
NAND 晶圆投片量方面,自 2022 年 178 万片/月峰值回落,2023 年降至 127 万片/月,同比下降 28.8%。按闪迪说法,回调期间行业产能利用率一度跌至约 70%,约有 50 万片/月产能闲置。
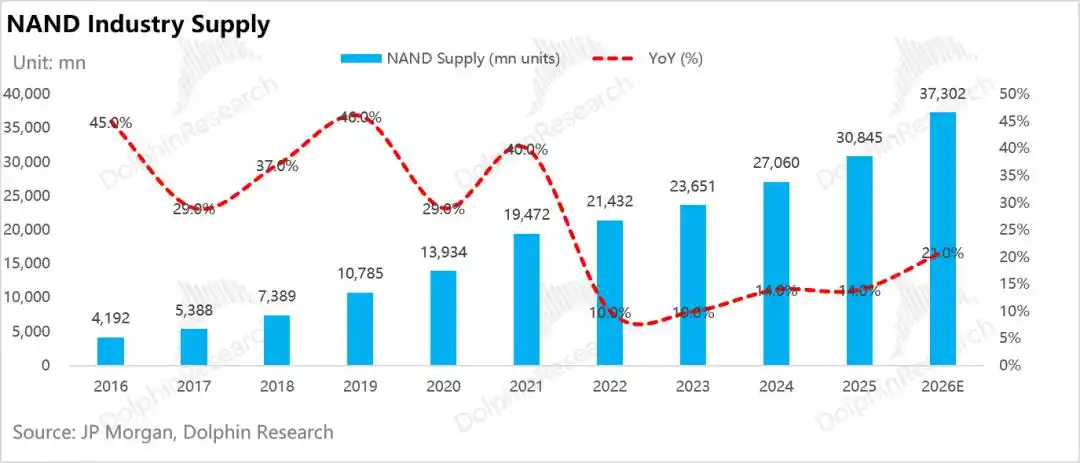
但即便如此,供给并未真正收缩。文章给出的数据是,2023 年投片量约收缩 29%,bit 供给却仍增长约 10%。从 2016—2026 年,NAND bit 供给没有出现过任何一年负增长,哪怕 2023 年行业收入下降 37%、全行业亏损。
海豚投研认为,晶圆投片减少而 bit 产量增加,二者方向相反,背后近 40 个百分点的落差,全部来自节点迁移带来的单位晶圆效率提升。也就是说,NAND 的技术迭代本身就在持续制造新增供给。
按闪迪披露,从 BiCS5 到 BiCS11 的五个节点,单位晶圆 bit 产出代际平均增幅为 54%,年化复合约 27%,明显高于行业长期 mid-to-high teens 的需求增速。厂商可以削减投片量,却无法削减每片晶圆自带的效率提升,这部分供给增长是自动发生的,与减产意愿无关。
单位晶圆 bit 产出由四个变量决定
文章将每片晶圆 bit 产出拆解为四个因素:存储孔密度、层数、存储阵列面积占比、每单元比特数。海豚投研认为,「逻辑缩放」和「架构缩放」大多属于一次性收益,而真正能持续推动单位晶圆 bit 产出增长的,是堆层数和横向缩小孔密度。
逻辑缩放:TLC 到 QLC 属于一次性台阶
文章称,NAND 通过阈值电压编码信息,从 SLC 到 MLC、TLC,再到 QLC,单元数与面积不变,仅通过增加编码位数提升容量。每增加 1 bit,存储容量都会提高。
但代价也很明确。QLC 需要分辨 16 个阈值电平,而 TLC 只需分辨 8 个,噪声容限减半、写入速度变慢、耐久度约为 TLC 的三分之一。更下一代的 PLC 性能更差,闪迪也未给出时间表。
文章还指出,这一杠杆无法完全兑现为行业持续增长。闪迪将 TLC 定位于高性能计算型 eSSD,用于承载 KV cache 中调用频率不是那么高的数据;QLC 则用于大容量存储型 eSSD,对应 KV cache 中很少用到的数据。
按闪迪预计,2030 年 AI 数据中心闪存 TAM 将达到 1.2 ZB,相当于 2026 年全球出货总量,其中 TLC 占 66%,QLC 占 34%。也就是说,即便在最乐观情景下,五年后仍有约三分之二的 bit 需求属于 TLC。
CBA:密度提升有限,性能改善更关键
在架构层面,文章重点讨论了 CBA,即 CMOS bonded on Array。其原理是将逻辑单元与存储单元直接进行铜铜键合。海豚投研称,从密度角度看,CBA 的本质是一次性回收原本被外围逻辑单元占据的闲置空间。
NAND 芯片由存储阵列和不存储数据的外围逻辑单元组成,架构演进路径是不断剥离这部分「无效率面积」:从逻辑单元与阵列并排放置,到置于阵列下方,再到阵列与逻辑分置于两片晶圆后通过混合键合贴合。
但空间回收存在上限。文章举例称,如果逻辑单元原本占面积 20%、阵列占 80%,那么逻辑完全移出后,阵列占比提升到 100%,密度提升 25%,之后便没有更多面积可回收。长江存储类似架构曾实现约 25% 的面积缩减,等效密度提升约 33%。
不过,海豚投研认为,CBA 对闪迪的真正价值不在密度,而在性能。逻辑单元和存储单元分开制造后,逻辑 CMOS 可以采用更先进制程,实现更高 I/O 速度和更低功耗。
文章称,相比 BiCS8 同规格 2Tb QLC,只是把逻辑单元改为更先进制程后,BiCS9 的写入和读取带宽分别提升 150% 和 75%,写入和读取能效分别提升 85% 和 40%,且增量资本开支很小。CBA 所依赖的混合键合与多晶圆堆叠,也被视为 HBF 的工艺基础,首代 HBF 阵列即基于闪迪首个 CBA 节点 BiCS8。
垂直缩放:没有单一物理上限,但经济上限逼近
文章称,3D 垂直堆叠仍是当前最直接的扩容路径,厂商普遍将提高层数作为核心策略。虽然不存在单一硬性物理上限,但隐性成本和资本支出正在快速抬升,主要受四项约束。
- 层数增加会让刻蚀、沉积工序成倍增加,在设备固定的情况下,单片加工时间拉长,月投片能力下降。从 176 层升至 300 层以上,单片容量虽增 50%—60%,但实际 bit 产量增幅达不到这一水平。
- 受沟道刻蚀深宽比限制,一次成型最高堆叠约 120—150 层,超过后就要采用多 Deck 方案,重新进行刻蚀、接触和填充等工序。
- 达到约 300 层后,传统钨材料电阻飙升、漏电失效,需要转向钼金属,对沉积和刻蚀设备的投资几乎翻倍。
- 超过 500 层后,氧化物材料更容易变形,继续堆层需要引入类似 HBM 的晶圆间键合,复杂度明显上升。
文章认为,500 层以上继续堆层,需要以键合能力为前提,而这正是铠侠和闪迪自 BiCS8 起率先量产并已积累经验的领域。
横向缩放:闪迪与铠侠的差异化引擎
在海豚投研看来,横向缩放,即缩小存储孔径、收紧 block 间距,是差异化价值最高的技术引擎。文章称,三星和 SK 海力士更偏向通过增加层数提升密度,而铠侠和闪迪则选择在平面维度上压缩存储单元、优化不同功能单元的组合结构。
结果是,铠侠和闪迪以全行业最低的 218 层实现了最高的 229 GB/cm² 位密度,每层贡献的密度较次优者高 29%;芯片面积为 55.9 mm²,也最小,较三星小 16%,同片晶圆可多切约 19%。文章称,这意味着层数虽低,但密度和性能并未落后。
两种路线的差异最终体现为资本强度不同。三星和 SK 海力士以更多工序和设备换取层数领先;铠侠和闪迪则以更少层数实现更高密度,消耗更少工序和设备。按文章数据,2025 年行业平均每增加 1 PB 产出所需资本开支,是闪迪与铠侠合资体系的 2.66 倍;2021—2025 年,两者以 13% 的行业资本投入产出了 29% 的行业 bit。
DRAM 与 NAND 的供给逻辑并不相同
文章接着将 NAND 与 DRAM 进行对比,认为两者供给扩张遵循的是完全不同的底层逻辑,这种差异不是策略选择,而是由物理结构决定,并最终反映为资本强度和周期性的不同。
供给扩张只有两条路径:一是技术工艺迭代,提高单片 bit 容量;二是增加晶圆投片量,通过新建洁净室和扩充设备提升产能。前者资本消耗远低于后者。
而节点迁移能带来多大产出提升,取决于存储密度还能多快提高,方向只有两个:纵向堆层和横向缩小单元面积。NAND 两条路都能走,既能堆层,也能横向缩微;而 DDR 内存只剩横向一条路,因为其单元结构中除了晶体管,还有一个垂直深孔电容,无法像 NAND 那样通过一次刻蚀低成本穿透多层。
文章称,这决定了两者迁移的产出上限。DDR 内存单代密度提升约 10%,从 1b 到 1c 已不足 10%;NAND 单代仍可达到 50%—60%。因此,DDR 仅靠迁移每年单位晶圆 bit 产出只能增加约 5%—10%,不足以覆盖需求,缺口只能靠新建洁净室填补;NAND 则相反,迁移本身带来的产出增量已能满足甚至超过需求。
为什么 DRAM 不能像 NAND 那样做 3D 堆叠
NAND 的 3D 扩容依赖批量成型与串联共享
文章称,NAND 单元本质上是可导通的晶体管,数百个单元可以串联在同一根垂直沟道上,共享一条位线。读取某一层时,只需向非目标层施加导通电压,使其等效为导线,电流即可穿透并读取目标层。
制造方式上,3D NAND 更像一次性浇筑:先交替沉积数百层氧化物与氮化物,再通过高深宽比干法刻蚀一次打通全部叠层,填入沟道材料,数百个单元同步成型。文章形容,NAND 单元不是逐个「造」出来的,而是通过材料交叉「形成」出来的。真正定义单元的关键动作,是把沟道柱一次刻穿,刻一次孔,300 层就同时得到 300 个单元。
这使得层数增加时,新增成本主要来自重复、相对低成本的沉积工序,而高成本的光刻与刻蚀次数并不会随层数同步增长。
DRAM 受二维极限约束,HBM 又放大了缺口
与之不同,DRAM 每个单元由一个晶体管和一个深孔电容组成,即 1T1C 结构,无法复制 NAND 的串联方式。文章称,电容会隔断直流电,相当于一道无法打开的墙,电流无法像 NAND 那样穿透多层单元。
同时,DRAM 作为 CPU 工作内存,需要在数十纳秒延迟内精确访问任意地址,无法像 NAND 那样通过整页、整块搬运来摊薄开销,因此纵向也无法共享位线,每增加一层都需要从底部额外引线。
在横向微缩放缓后,HBM 的兴起又进一步放大了产能缺口。文章称,HBM 的本质是在有限封装面积内塞入更多容量和带宽,但其堆叠方式与 NAND 完全不同。NAND 是在同一颗芯片的共同地基上堆 300—400 层;HBM 则更像把一栋栋带地基的平房逐层叠起来,每一层都要单独制造、打孔和对准,层数越高,成本越高,也越消耗晶圆产能。
文章列出 HBM 对晶圆产能的三重放大效应:
- die 更大。TSV 硅通孔与复杂 I/O 电路需要预留区域,减少可用存储面积,同容量下 die 面积显著大于标准 DDR;
- 多层堆叠需要消耗更多 die。单颗 HBM 通常由 8—16 层 die 堆成;
- 综合良率更低。即便单颗 die 良率较高,切割、键合等环节叠加后,复合良率仍会下降。
海豚投研称,三者叠加后,生产同等 bit 的 HBM 所消耗的晶圆产能约为标准 DDR 的 2—3 倍。
这也解释了 2024—2026 年 DRAM 与 NAND 在产能投资上的明显分化。文章称,HBM 占全球 DRAM 晶圆产能的比重将从 2023 年的 7% 升至 2026 年的 23%,绝对产能从 10 万片/月增至 47 万片/月,三年增长超过三倍。
但 HBM 的产能效率远低于标准 DRAM。文章给出的对比是,一片晶圆可产出约 1,500—1,800 颗 DDR die,却只能产出约 500—600 颗 HBM die;再考虑单颗 HBM 需要 8—16 层 die 堆叠,以及逐层消耗产能和良率折损,有效 bit 产出效率更低。HBM 渗透率每提升一点,都会实质性挤压标准 DRAM 产能。
因此,DRAM 资本开支持续上升,由 2023 年的 308 亿美元增至 2026E 的 998 亿美元,单年增速 68%;全球 DRAM 产能在 2023 年下降 13% 后重新扩张,从 140 万片/月增至 2026E 的 202 万片/月,较 2022 年峰值高 25%。
相比之下,NAND 资本开支虽自 2024 年 197 亿美元谷底回升,2025 年增长 21%,2026 年增长 29%,但到 2026 年的 254 亿美元仍较 2022 年峰值低约 18%。文章称,2026 年 DRAM 行业资本开支约 998 亿美元,同期 NAND 仅约 254 亿美元,前者接近后者的 4 倍。
若按资本强度衡量,2026 年 DRAM 资本开支/收入为 16%,NAND 仅 7%,持续维持在 DRAM 的一半以下,这也与闪迪给出的「中低个位数」长期资本开支指引相吻合。
同属周期行业,DRAM 与 NAND 的商业命运不同
文章最后从商业模式角度总结两者差异。
第一,周期方向不对称。NAND 下行更剧烈,因为技术迁移会自动带来供给增长,即便大幅削减资本开支,单片 bit 产出仍会随着层数增加而惯性上升,尤其 3D 过渡期还曾带来一次性跃升,使产能增速一度远超需求。DRAM 则相对温和,其迁移增速持续放缓且低于需求,扩张高度依赖新增洁净室,只要削减资本开支,就能在物理层面更快收紧供给。
第二,定价权基础不同。文章称,DRAM,尤其 HBM,当前的紧缺来自真实的物理产能限制与极高制造复杂度,厂商定价权更强;HBM 依赖的 TSV 和先进键合也形成了明显差异化,推动三大原厂将产能向 HBM 倾斜,并进一步加剧标准 DDR 紧缺。
而 NAND 当前的紧平衡,更依赖寡头之间的「默契」。文章称,闪迪主动将行业 bit 增速目标压制在约 15%,而不是历史上更激进的 30% 以上。这意味着行业内部仍有大量未释放的技术产能,无需巨额新增资本开支即可投放市场。一旦这种默契松动,或中国厂商加速扩产,供过于求的风险就会重新出现。
第三,现金流与资本回报不同。海豚投研认为,NAND 正在向「现金牛」转变。DRAM 需要持续把经营现金流投入重资本扩产,新建一座先进工厂的投资已超过 200 亿美元;而 NAND 的资本开支主要用于存量产线的节点升级,而不是扩产。
文章以闪迪为例称,其长期指引显示,资本开支仅占营收中低个位数,调整后自由现金流利润率约 50%,且 100% 超额现金将通过回购返还股东。文章同时提到,SK 海力士在 2026 年 8 月宣布 40 万亿韩元回购,显示 DRAM 厂商也在提高股东回报,但由于资本强度更高,其在超级周期中的现金流表现仍难与轻资产的 NAND 相比。
后续关注点仍在供给纪律与 AI 需求持续性
文章最后指出,当 NAND 供给端能够「自动」实现 bit 增长,而三大原厂又把更多资本优先投向 DRAM 和 HBM 时,后续供需变化主要取决于两个变量:一是其他原厂是否会打破当前默契,重新在 NAND 上扩产;二是 AI 对 NAND 需求的拉动能持续多久。
海豚投研表示,关于其他厂商是否会继续克制扩产、下游需求会出现怎样的结构性重塑、这一轮涨价行情还能持续多久,以及涅槃后的闪迪在当前估值位置是否仍有上行空间,将在下一篇报告中继续展开。
本文来自微信公众号「海豚投研」(ID:haituntouyan),作者为海豚君。