


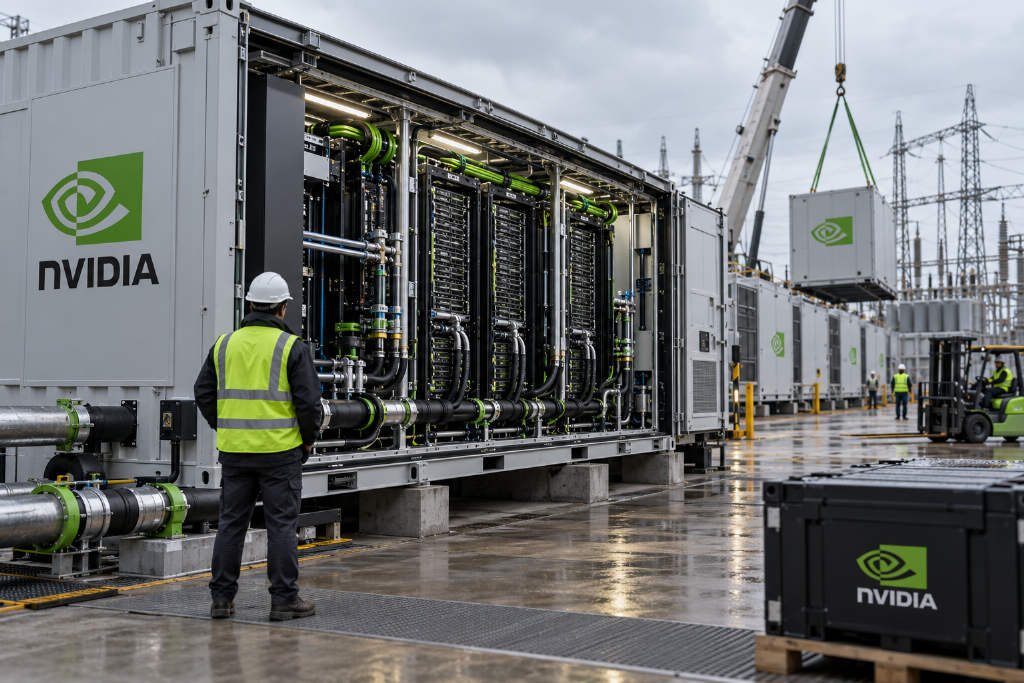
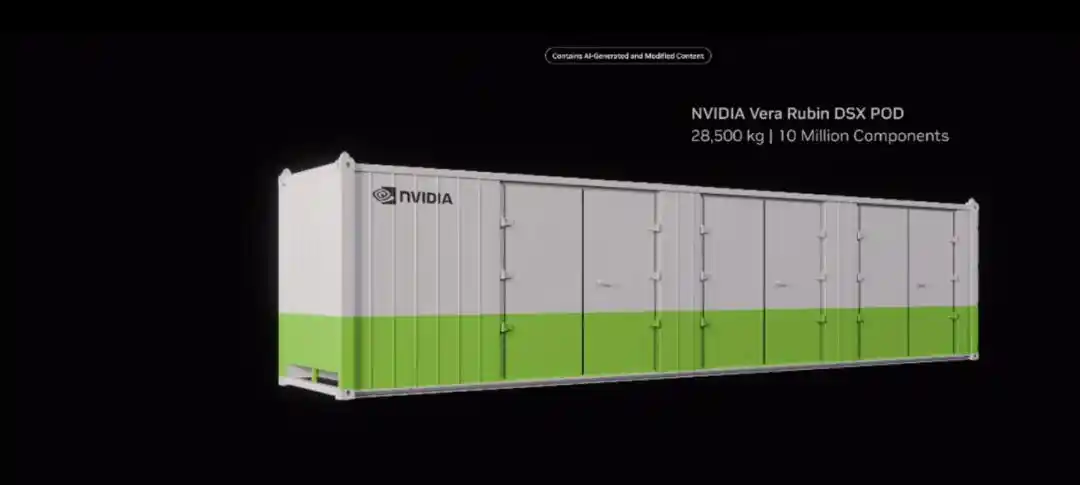
英伟达发布了面向 AI 数据中心的新一代模块化基础设施方案 DSX POD,并将其核心卖点直接指向交付速度:把包含 Vera Rubin 系统在内的计算、网络、供电和液冷设施预先集成到模块化集装箱中,现场部署周期可从传统 6 个月压缩至最短 14 天。
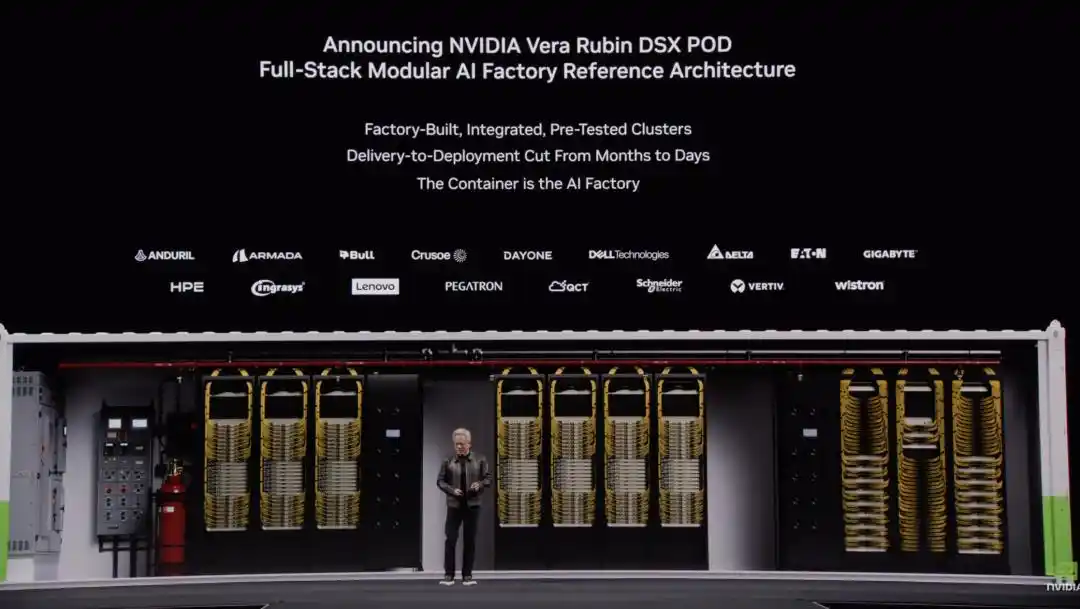
公司给出的衡量指标是 Time to First Token,也就是首个 Token 产出时间。英伟达 CEO 黄仁勋在现场表示:「一座 AI 工厂只有在开始产出 Token 时才创造价值,而不是在建筑施工完成时。」
DSX POD 把 AI 工厂做成预集成模块
按照英伟达的介绍,传统 AI 数据中心建设通常需要在现场完成计算节点安装、网络布线、机架级供电和液冷管道铺设,任何零部件延误或施工失误,都可能把周期拉长到半年以上。
DSX POD 的做法是把这些工作前移到制造工厂。英伟达称,合作伙伴会在工厂内完成计算、网络、布线、供电和液冷系统的集成,包括跨机架走线、管道连接和功能验证,之后再整体装入定制的模块化集装箱,运抵客户现场后接入预留的电力、冷却和网络基础设施即可启动。
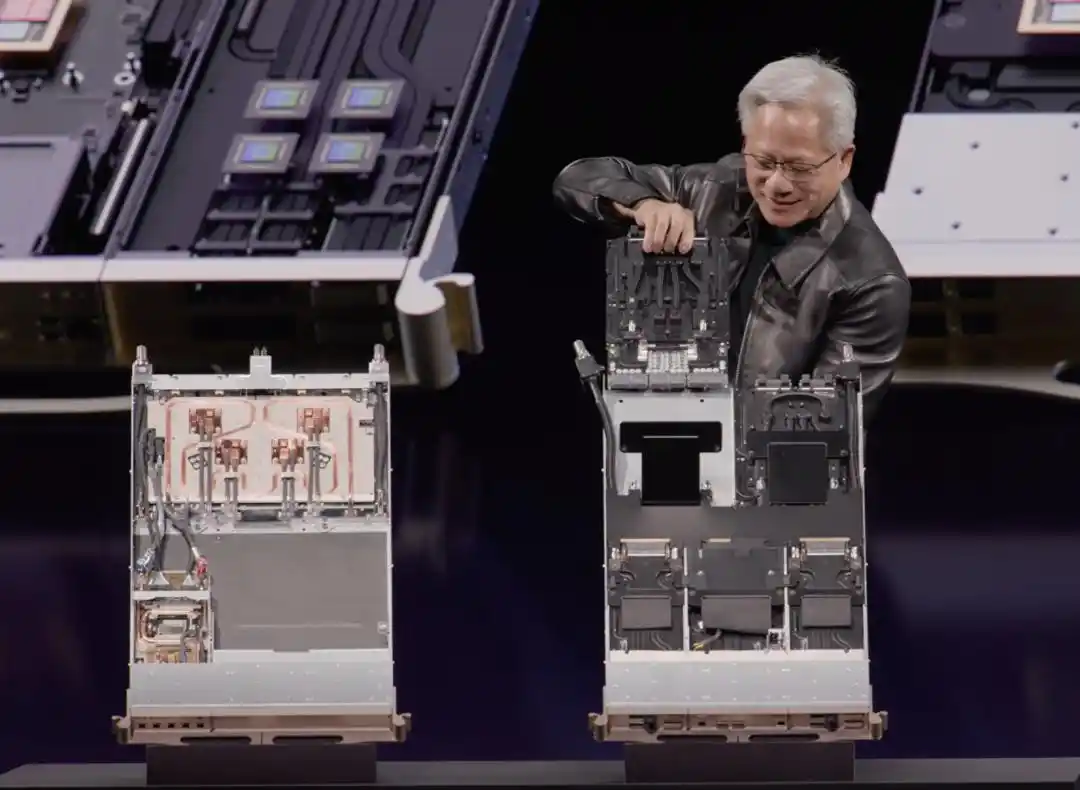
在硬件层面,英伟达首先将最新的 NVIDIA Vera Rubin 计算系统与高速网络、机架级供电和液冷散热系统打包。文中对比称,原先的 Grace Blackwell 方案组装一个节点需要 2 小时,布线复杂,液冷覆盖率为 80%;换成 Vera Rubin 后,采用无线缆架构和 100% 全液冷,单个节点组装时间缩短至 5 分钟,同时可靠性和性能提升。
英伟达称,机架之间的跨柜布线、电力接线、液冷管道铺设以及整套系统的功能验证,都可以在出厂前完成。客户现场则可同步推进场地准备,两边并行进行。集装箱到场后,接通现场基础设施即可点亮整套算力系统。
围绕电力预算做功率调度,披露多组吞吐测试数据
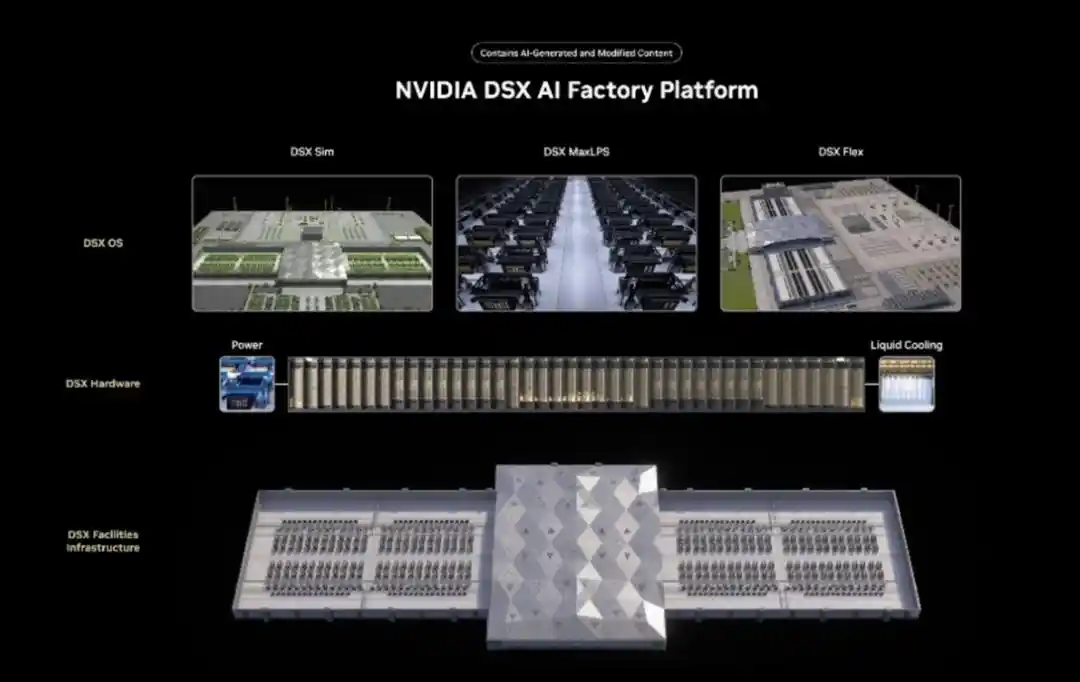
除交付周期外,英伟达还把 DSX 平台的另一重点放在电力利用率上。公司称,DSX POD 背后依托的是全栈式 AI 工厂参考架构 NVIDIA DSX 平台,该平台将计算、网络、存储、软件、供电和散热作为单一系统协同设计。
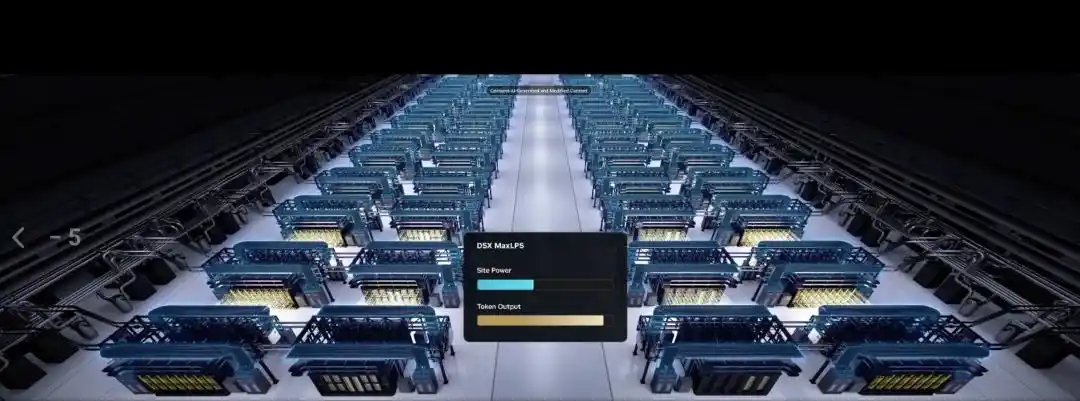
其中,DSX MaxLPS 用于在既定电力预算内进行动态功率分配。英伟达表示,在产出相同数量 Token 的情况下,该工具最高可节省 30% 电力;如果电力预算固定,节省下来的电力则可转化为更多算力容量。
英伟达列举了两组测试结果。在云厂商 Lambda 基于 NVIDIA HGX B200 系统的概念验证中,固定功率预算下,集群 Token 吞吐量提升 24%,可容纳的 GPU 算力容量增加 19%。在欧洲云厂商 Nscale 位于冰岛的 AI 工厂测试中,跨 4 个 NVIDIA GB300 NVL72 机柜、在相同 264 千瓦供电预算下,推理吞吐量提升 49%,受管 GPU 算力容量增加 37%。
另一项软件工具 DSX Flex 则面向电网侧调节。英伟达称,该系统可根据电网负载、电价波动以及现场光伏和储能情况,实时调整算力功耗,以帮助 AI 工厂更快获得并网审批。
在英国国家电网、Nebius、Emerald AI 与英伟达的联合测试中,面对模拟电网突发事件,Blackwell Ultra GPU 集群在不中断关键业务的前提下,可将集群功耗瞬间下调 40%。
液冷设计瞄准低耗水,2GW 设施日节水 5400 万升
散热也是这套参考架构的重点。英伟达称,传统数据中心依赖冷却塔蒸发水降温,耗水量较高;而 Vera Rubin 基础设施支持冷却液温度最高 45°C 的 100% 全液冷。
按照 DSX 参考设计,系统将闭环液冷与室外干冷器结合,冷却液在封闭管路内循环吸热,再由干冷器把热量排入空气,整个过程不蒸发水,可将设施冷却耗水降至接近于零,减幅达 100%。
英伟达给出的测算显示,在一座 2 吉瓦规模的 AI 工厂中,相比传统冷却塔方案,DSX 每天可节省 5400 万升水,相当于 18 万户家庭一天的用水量。
SimReady Central 上线 Hugging Face,DSX OS 放出三项开发者预览
英伟达还把基础设施设计和运维工具一并推向开发者社区。公司宣布,物理设备数字模型库 NVIDIA SimReady Central 已登陆 Hugging Face,库中包含维谛等合作伙伴经过验证的供电与散热设备 3D 数字资产。
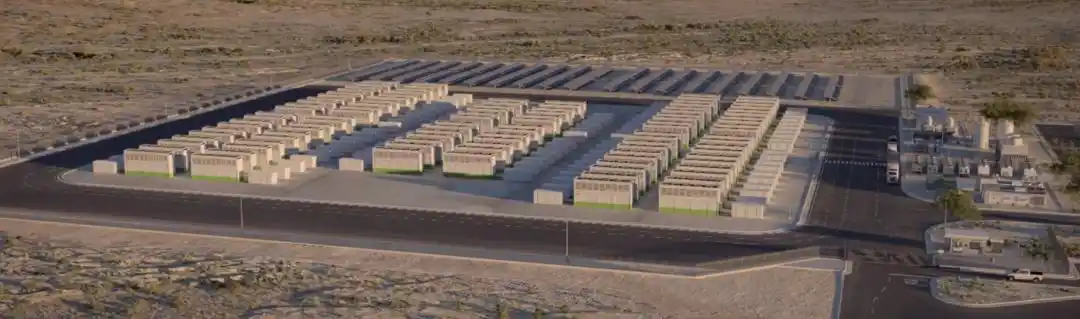
配合 DSX Sim 仿真工具,工程师可在实体施工前搭建 AI 工厂数字孪生,对供电、散热以及西门子正在测试的声学噪音等项目进行模拟验证。
在软件管理层面,英伟达扩展开源的 DSX OS 基础设施管理软件组合,并发布三项开发者预览版组件:
- NVIDIA Config Manager:用于自动完成 AI 工厂复杂网络配置。
- NVIDIA Rack Management Service:提供机架级电源、资产盘点、固件与交换机统一管理。
- NVIDIA Cluster Readiness Engine:在正式生产任务到达前自动运行分布式负载,对 GPU 集群进行验证,并将故障定位到具体节点。
按照文中描述,这套软件栈覆盖了从虚拟设计、集装箱出厂到自动压测上线的流程。
合作伙伴名单覆盖服务器、工业软件与能源企业
为推动 DSX POD 在全球交付,英伟达披露了一批制造与基础设施合作伙伴。负责生产并推广 DSX POD 集装箱的企业包括 Dell、HPE、联想、富士康旗下鸿佰科技、技嘉、和硕、广达旗下云达、纬创,以及 Anduril、Armada、Bull、Crusoe、DayOne、台达、伊顿等。
英伟达表示,预制化模块 AI 工厂预计将在 2027 年初开始全球交付。
在云生态侧,CoreWeave、Google Cloud、Lambda、Nebius、Nscale、Crusoe、G42、IREN 已采用 DSX 软件栈。工业与能源合作方则包括施耐德电气、AVEVA、达索系统、维谛、ABB、日立能源、西门子能源和 GE Vernova。
文中提到,施耐德电气与 AVEVA 正在为 Vera Rubin 建立全生命周期数字孪生;达索系统与维谛联合仿真 OneCore 基础设施;ABB 基于 DSX Sim 开发 SimReady 数字资产,并通过新发布的 Infinitus 直流产品组合推进 800 VDC 架构研发;日立能源、西门子能源与 GE Vernova 则参与从电网规划到储能系统的协同。
从卖芯片到卖整套 AI 工厂
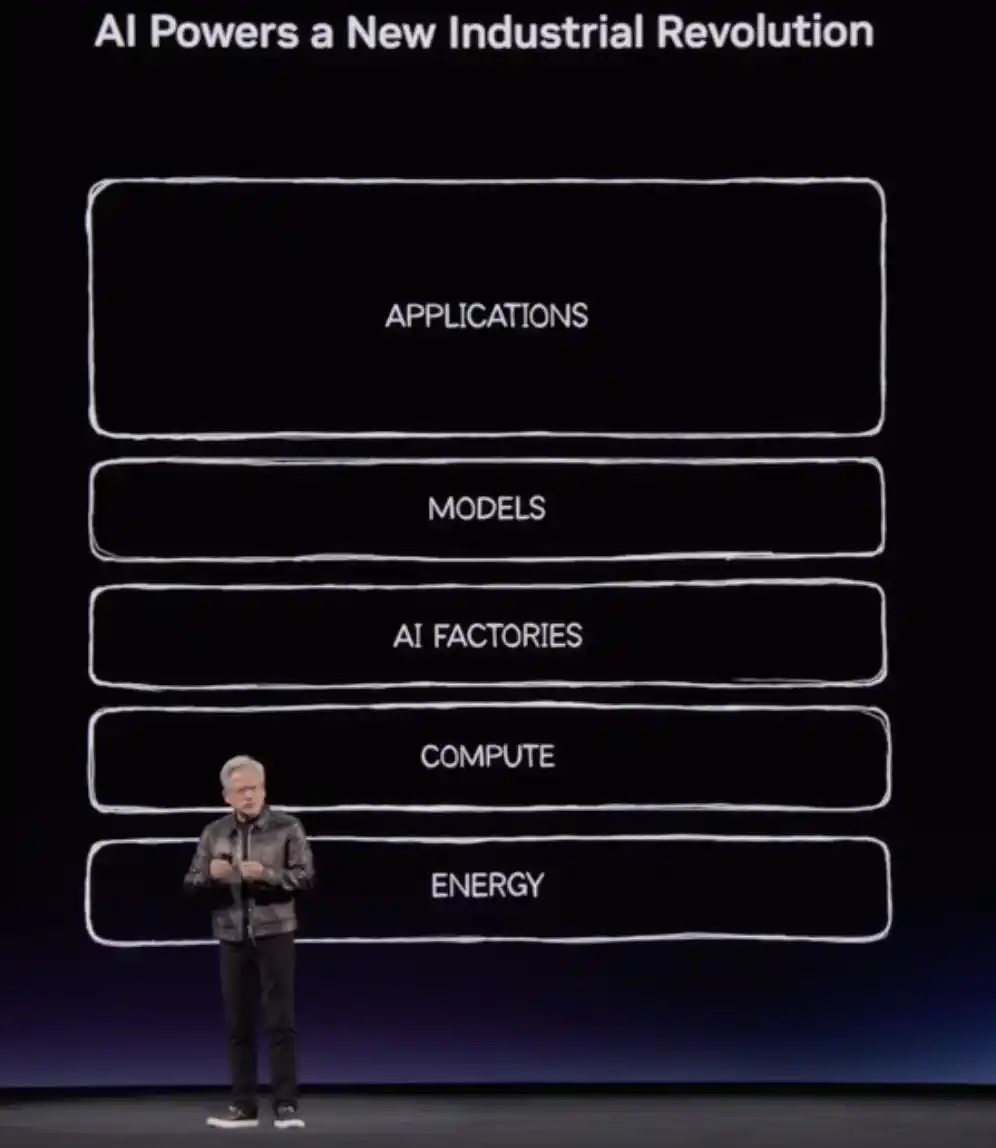
文章将这次发布放在英伟达 AI 基础设施路线的延长线上。回到 2024 年 GTC 大会,黄仁勋当时曾在介绍 Blackwell 机柜时表示:「英伟达的 AI 超级计算机,就是 AI 工业革命的工厂。」
而在这次更新中,英伟达把这一表述继续向实体基础设施推进。文中提到,英伟达不仅定义了芯片 Vera Rubin、机柜 NVL72,也把 DSX POD 集装箱、散热管路、电网调度以及工业设计工具纳入统一方案。
按照原文给出的测算,如果参考 DeepSeek 开源推理框架中「单卡每小时收入 38 美元」的口径,那么一个万卡集群在 14 天上线后,若处于满负荷且订单充足的理想状态,每小时收入可达 38 万美元。不过原文同时注明,前提是能够获得足够稳定的订单。
本文来自微信公众号「量子位」,作者为梦晨。文末附有视频回放链接:https://www.youtube.com/watch?v=PvFjbPYEOZI