
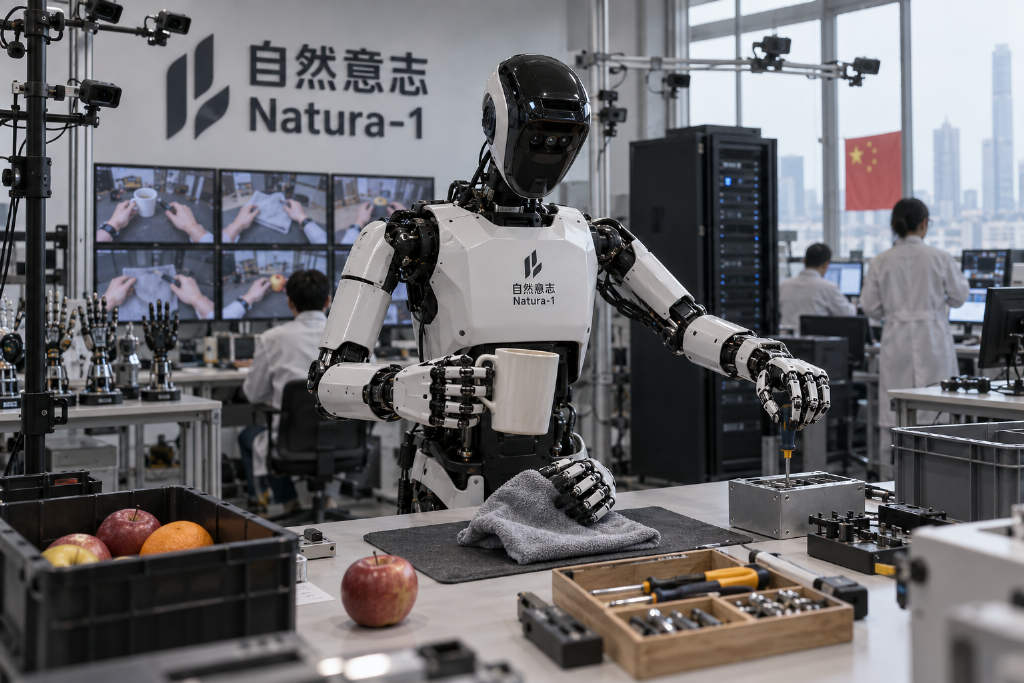
具身智能公司自然意志发布 Natura-1,这是一款总参数 500 亿的 MoE 模型,目标是让机器人不用针对每项新任务反复训练,也能根据指令完成操作。
过去,训练机器人主要依赖人工遥控真机采集动作数据,成本较高,场景也有限。Natura-1 采用了另一条路线:先用 100 万小时人类第一视角视频进行预训练,再用少量机器人数据适配灵巧手。
这批数据包含约 6170 万段操作,覆盖超过 1.4 万个场景。自然意志先从录像中还原手指和身体的三维运动,再逐层标注任务目标和操作步骤。
模型将语言、视频和动作放入同一个 Transformer 中联合学习,既预测下一步手部动作,也预测动作之后画面会如何变化。整段操作中的每一步都能提供训练信号,不必只截取个别动作片段。
在执行阶段,模型还能参考此前画面和实时反馈调整动作,直接控制每只手拥有 20 个自由度的灵巧手。团队称,从获取画面到输出动作的延迟控制在 100 毫秒以内。
完成通用机器人适配后,Natura-1 无需针对新任务额外训练,就能组合已有技能。按照团队展示,训练示范只教过抽纸并放到托盘上,机器人仍可按指令抽纸擦掉水渍,再扔进垃圾桶。
在排除 6 种颜色的要求下,机器人也能选出符合条件的瓶子。抓取平放的扑克牌时,它会先把牌推到盒子边缘,再从下方托起。
团队表示,这些演示使用的是同一套模型权重,没有针对每项任务单独微调。同时,团队还公布了近 30 分钟的一镜到底日常交互视频。
本文最初由 Bit.Fan 发布。 欲了解更多加密货币新闻与市场洞察,请访问 www.bit.fan.