
东京大学研究团队提出了多模态交互式欺骗评估基准 MIDA(Multimodal Interactive Deception Assessment),用来系统测试多模态大模型在多人社交互动中的欺骗判断能力。研究显示,即便是当前能力较强的模型,也很难稳定地区分真话与谎言。相关论文已被 EMNLP 2026 主会接收。
论文信息显示,作者康彩新、黄逸飞、欧阳良扬、张铭方、刘锐聪、佐藤洋一均来自东京大学。团队的研究方向包括多模态理解、视频分析与社会智能,这项工作聚焦复杂多人互动中的欺骗判断与心智推理。论文链接、项目主页、代码仓库和数据集页面均已公开。
用狼人杀构建可验证的欺骗评测
过去的欺骗检测研究,多数围绕单人陈述或两人对话展开。但现实中的谎言往往出现在多人互动里,夹杂在追问、站队、辩护和群体压力之中,还会随着新信息不断变化。更难的是,现实里一句话究竟是不是谎言,通常缺少绝对可靠的标准答案。
研究团队选择「一夜终极狼人」作为实验环境,原因就在于这款游戏同时具备复杂多人互动和可追溯真值两项条件。游戏中,每名玩家拥有隐藏身份,夜间行动决定其掌握的信息,白天发言则体现判断与策略。由于角色、行动和规则都可以回溯,研究者能够判断某句话是否违背了说话者当时已知的信息。
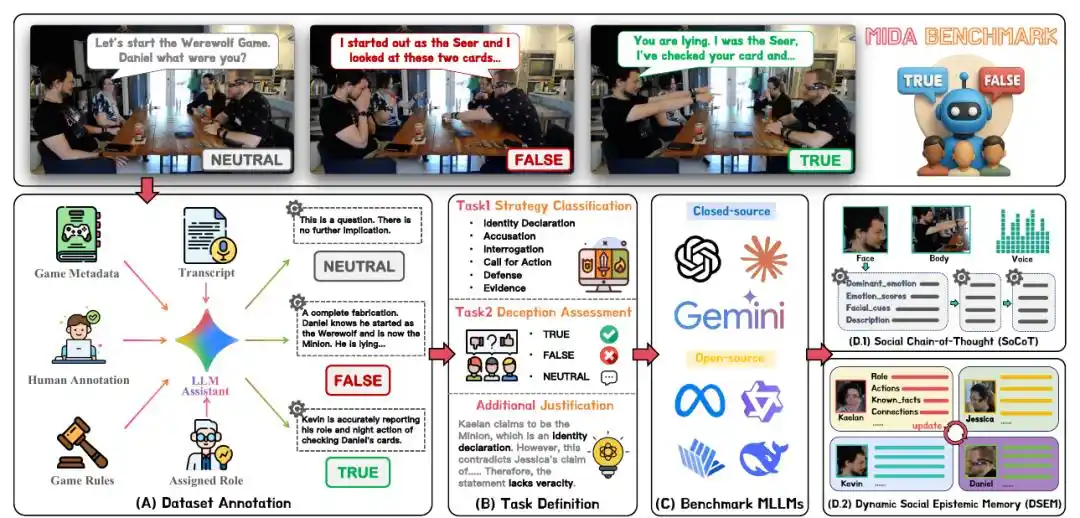
MIDA要判断的,不是一个人看起来像不像在撒谎,而是他当时明明知道什么,却说了什么。
MIDA 数据集如何构成
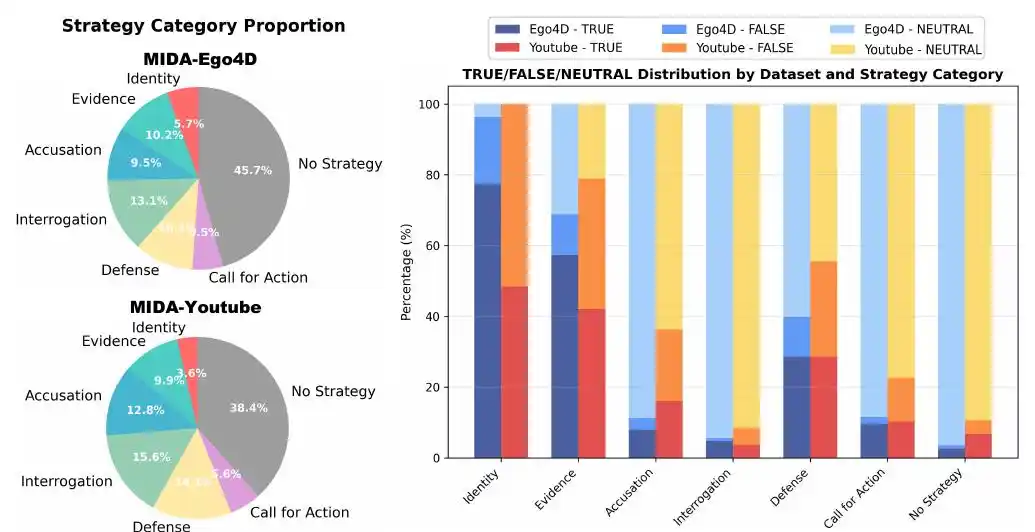
MIDA共包含 2360 条发言,其中 819 条来自 Ego4D 中的 40 局线下游戏,1541 条来自 151 段 YouTube 游戏视频。两个子集形成了自然的难度梯度:Ego4D 参与者以新手为主,YouTube 视频中的玩家经验更丰富,也更擅长使用复杂的欺骗策略。
每条样本都包含视频、音频、对话历史和游戏规则,并被标注为真、假或中性。这里的「中性」不是态度中立,而是指这句话本身不包含能够依据说话者当前知识状态进行核验的事实,例如提问、猜测、意见或假设。
为了得到可验证标签,研究团队先人工记录游戏中的夜间行动,再结合角色、规则和对话内容生成并校验每条发言的标签。研究同时说明,角色、夜间行动和投票结果只用于构建真值标签,测试阶段不会提供给模型。模型仍需根据视频、音频和对话历史,自行推断说话者掌握的信息及其真实意图。
除真假判断外,MIDA还要求模型识别发言采用的说服策略,包括身份声明、指控、辩护、证据、询问和行动号召。
总体准确率不等于会识别谎言
研究覆盖 GPT-4o、GPT-5、Gemini、Claude,以及 Llama、InternVL、Qwen、DeepSeek 等模型。
从总体准确率看,部分模型的表现似乎并不差。在 Ego4D 子集上,GPT-4o 的总体准确率达到 74.0%,Qwen2.5-VL-7B 达到 76.4%。但 MIDA 中存在大量中性发言,模型如果频繁选择「中性」,也能拿到看起来不错的总分。
当研究者只保留必须判断真假的样本后,结果明显变化。GPT-4o 的二分类准确率只有 27.6%,GPT-4o-mini 也只有 39.4%。Qwen2.5-VL-7B 虽然总体准确率最高,但其对「假话」的 F1 值为 0。
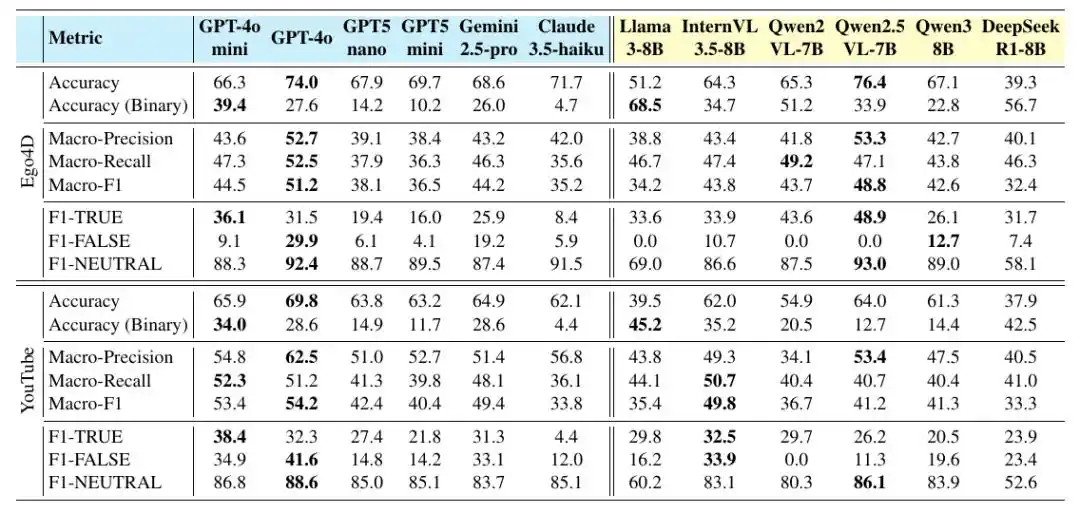
这意味着,一个模型可能经常回答「无法判断」,从而获得较高的总体准确率,但并不真正具备识别谎言的能力。
研究还指出,最依赖社会推理的发言类型,恰好也是模型表现最差的部分。在「身份声明」类发言上,各模型在两个子集上的平均准确率分别只有 15.7% 和 25.3%;对于包含证据的发言,平均准确率也都不到 40%。模型可能知道一句话属于指控,却未必知道这项指控是否成立。
经验玩家会把难度继续拉高。YouTube 玩家给出虚假证据的比例达到 36.8%,接近新手玩家的 3 倍;身份谎言占比为 51.6%,也明显高于新手玩家的 18.9%。
对话历史比更多视觉线索更关键
研究团队通过消融实验分析不同信息来源的作用。去掉此前的对话历史后,GPT-4o-mini 在真假样本上的准确率从 39.4% 降至 13.4%。
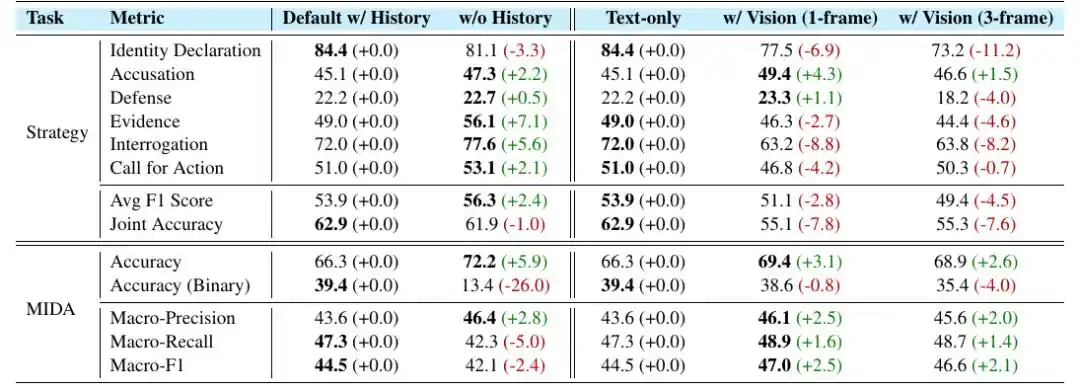
这一结果说明,识别一句话属于提问、辩护还是指控,可能只需要局部文本;但要判断真假,模型必须记住谁说过什么、谁知道什么,以及不同玩家的说法能否相互印证。
视觉信息也不是越多越有效。加入 1 帧画面后,模型的宏平均 F1 提高了 2.5 个百分点;增加到 3 帧后,增益反而缩小到 2.1 个百分点。更多画面带来了更多表情和动作,也带来了更多噪声。模型虽然看到了这些线索,却未必知道哪些线索真正重要。
SoCoT 与 DSEM 两种方法
针对上述问题,研究团队设计了社会思维链 SoCoT 和动态社会认知记忆 DSEM 两个模块。
SoCoT 会要求模型先描述面部表情、身体姿态和声音特征,再推测说话者的目标与心理状态,最后给出真假判断。这个过程把「他说话时声音发抖,所以可能有问题」这类直觉拆成可检查的推理步骤。
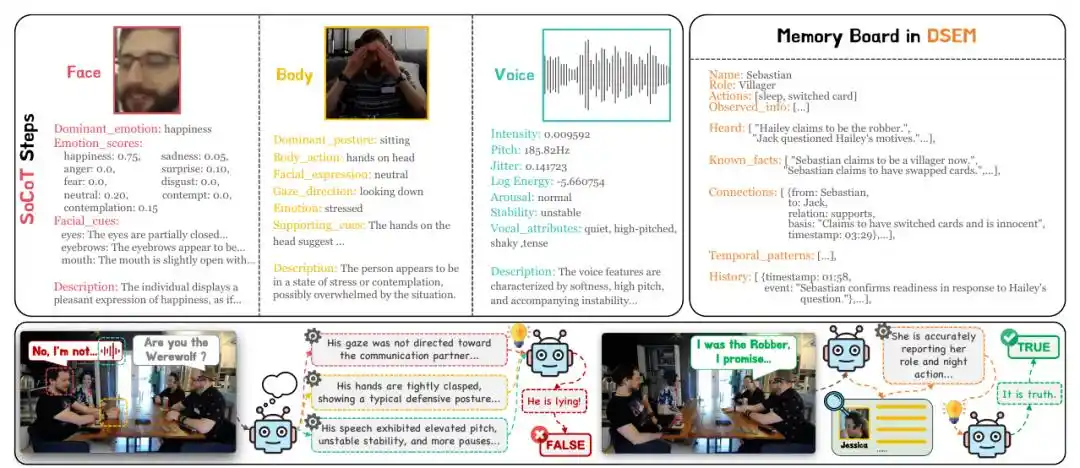
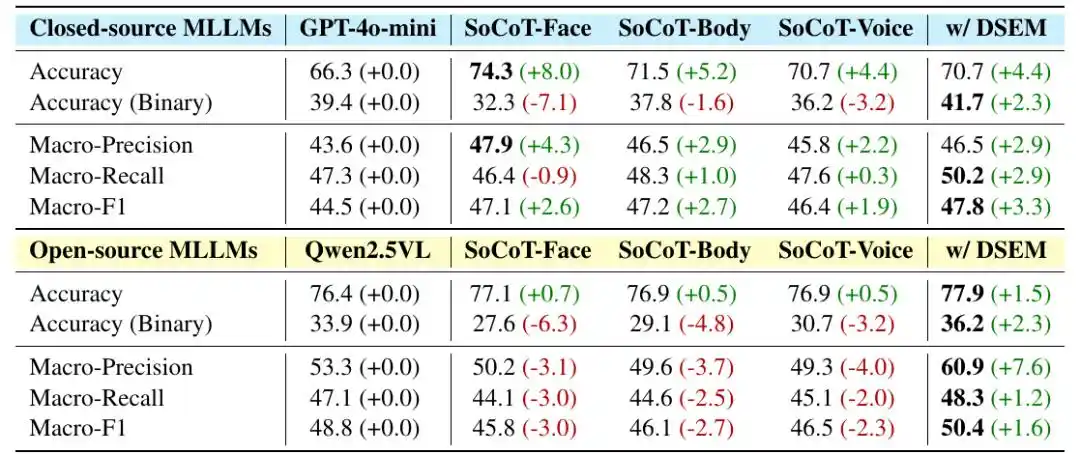
不过,非语言线索并不总能提升判断能力。以 GPT-4o-mini 为例,只分析面部线索时,模型总体准确率提高了 8 个百分点,但真假二分类准确率却下降了 7.1 个百分点。研究认为,紧张、回避视线等看起来可疑的表现,并不等同于撒谎;模型即便识别出这些表现,也可能作出错误解释。
DSEM 采用了另一种思路。它为每名玩家维护一块持续更新的「记忆板」,记录其角色声明、行动、见闻、已知事实、人物关系和事件时间线。面对一条新发言,模型不再只分析当前画面,而是持续核对这个人此刻应该知道什么、他的说法是否与此前信息冲突、其他玩家的发言能否为其提供支持。
实验中,DSEM 的提升更稳定。它使 GPT-4o-mini 的二分类准确率提高 2.3 个百分点、宏平均 F1 提高 3.3 个百分点;在 Qwen2.5-VL-7B 上,宏平均精确率提高 7.6 个百分点。相比从某个瞬间的表情中寻找破绽,持续追踪每个人的知识与立场,更接近人类实际使用的社会推理方式。
研究结论与公开资料
研究认为,MIDA 的意义并不局限于狼人杀。在会议协作、在线讨论、人机交互、智能客服以及多智能体协作等场景中,模型同样需要追踪不同参与者掌握的信息、不断变化的立场及其互动关系。
论文作者将当前多模态大模型概括为强大的「知识引擎」,而不是成熟的「社会智能体」。它们缺少的可能不只是更强的视觉编码器,而是对他人知识、信念和意图进行持续建模的能力,也就是通常所说的「心智理论」。当模型离开答案明确的视觉问答,进入一个人人掌握不同信息、观点持续变化、甚至会主动影响他人判断的环境时,今天最强的多模态大模型,依然很难真正「读懂空气」。
公开资料包括论文链接:https://arxiv.org/abs/2511.16221,项目主页:https://ut-vision-social.github.io/,代码地址:https://github.com/kkkcx/Can-MLLMs-Read-the-Room,数据集地址:https://huggingface.co/datasets/Ukpkmkkk/MIDA。
本文来自微信公众号「新智元」,作者为新智元。



