
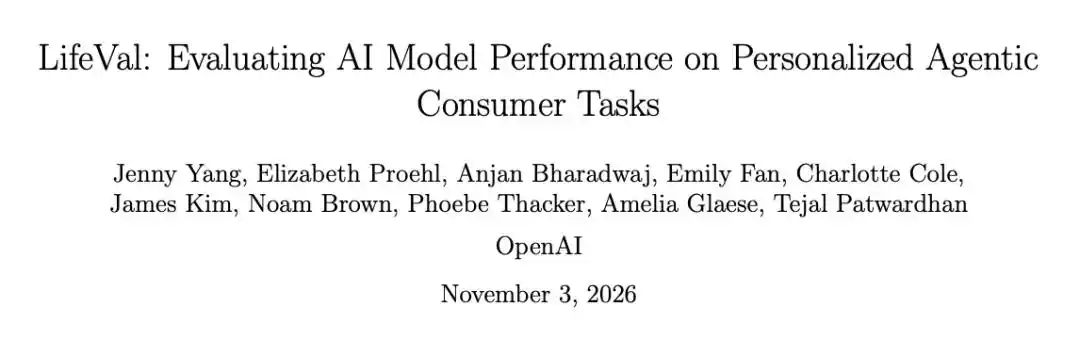
OpenAI 在今天推出了新的 AGI 评测标准 LifeVal,把模型能力的衡量方式从考试、竞赛,转向现实生活中的个人事务处理。
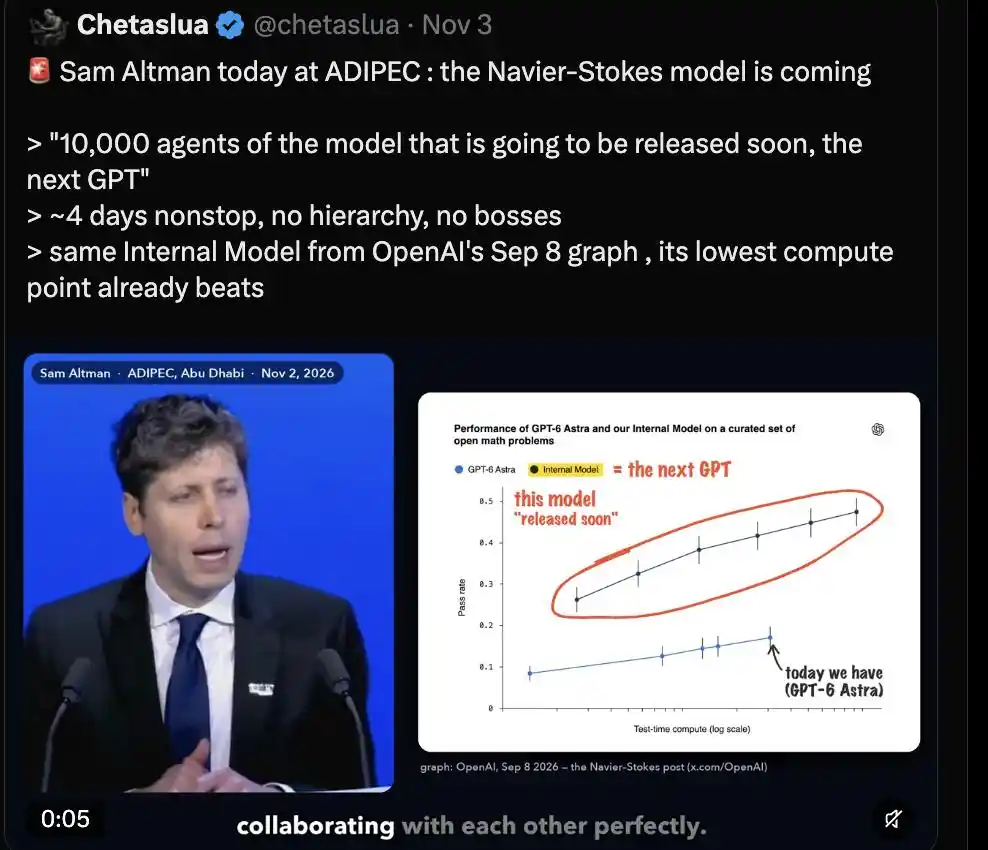
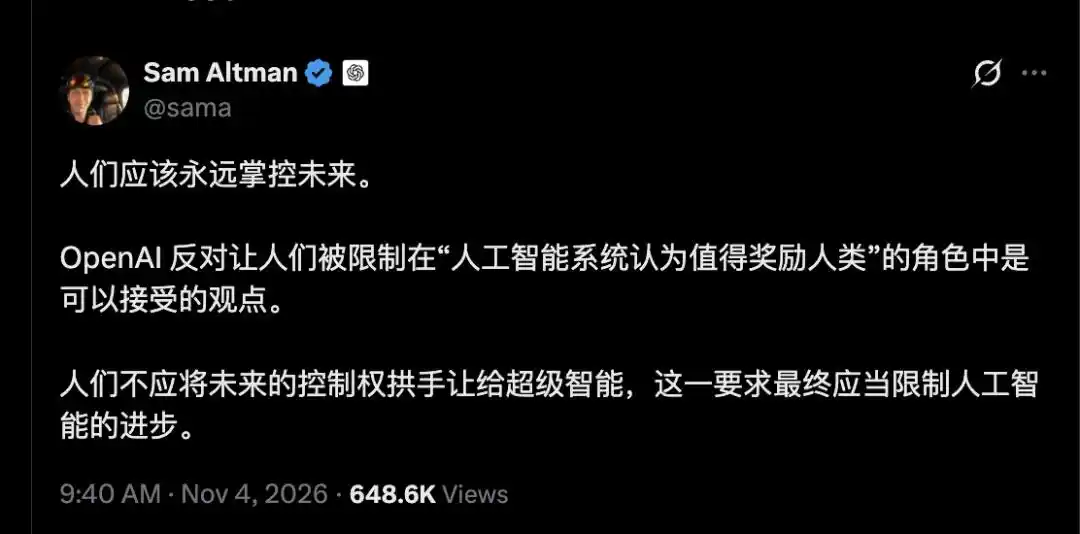
这一发布正值关于 GPT-6.2 Astra 的消息在 X 上持续发酵之际。文中提到,Sam Altman 此前在一则推文中写道:「人们应该永远掌控未来。OpenAI 反对让人们被限制在『人工智能系统认为值得奖励人类』的角色中。人们不应将未来的控制权拱手让给超级智能,这一要求最终应当限制人工智能的进步。」
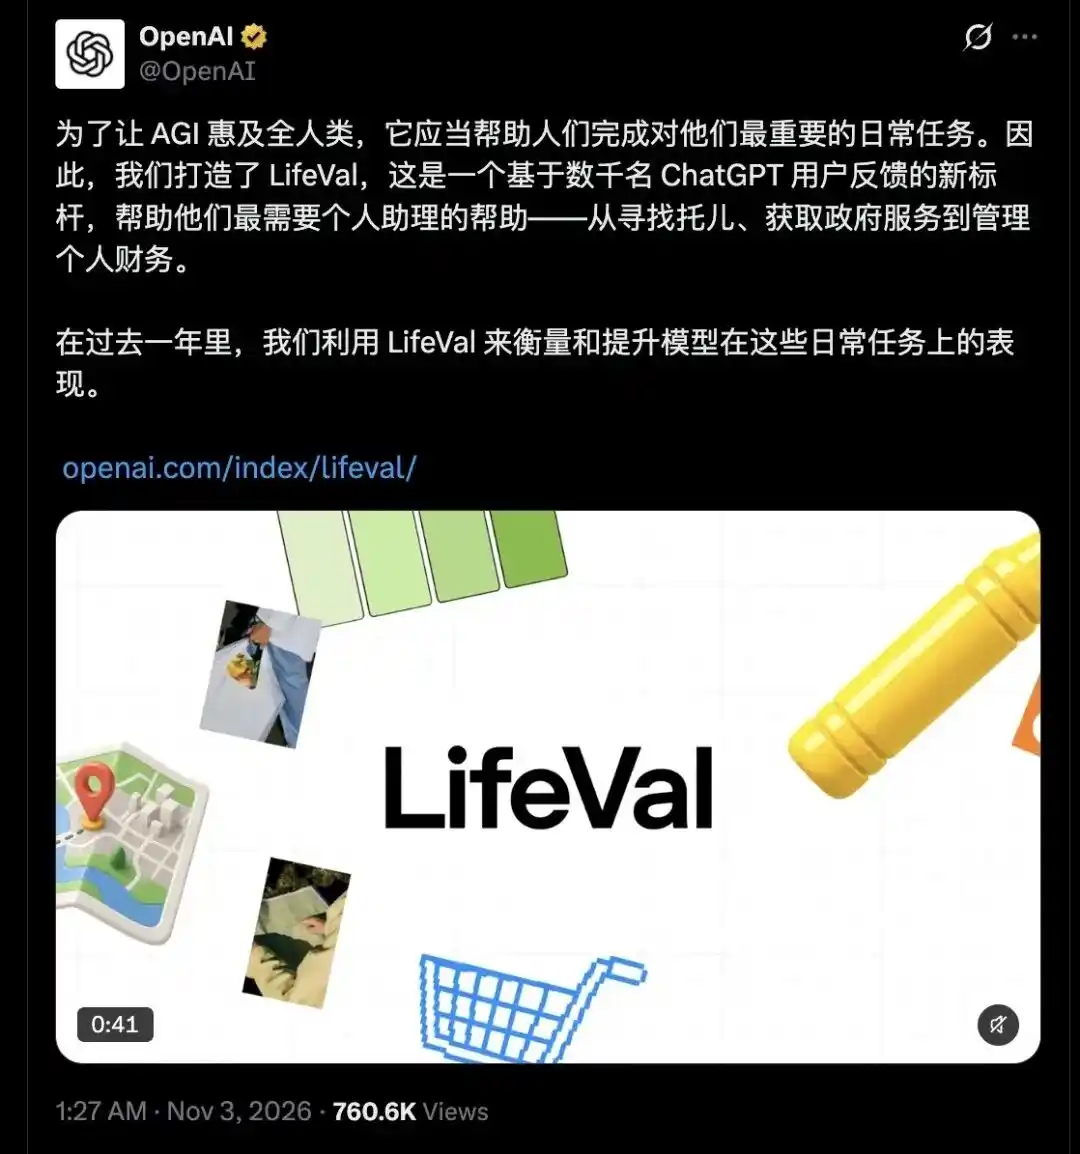
围绕新一代模型的讨论中,文章将焦点落在一个问题上:如果 AGI 要真正进入日常生活,接管浏览器、操作电脑、处理现实事务,应该用什么标准来证明它具备这种能力。OpenAI 给出的答案就是 LifeVal。
LifeVal 指向的是生活中的高价值任务
OpenAI 在官方推文中表示:「为了让 AGI 惠及全人类,它应当帮助人们完成对他们最重要的日常任务。因此,我们打造了 LifeVal……帮助他们最需要个人助理的帮助——从寻找托儿、获取政府服务到管理个人财务。」
与过去常见的律师资格考试、数学竞赛等评测不同,LifeVal 不再测试做题能力,而是测试「办事」能力。OpenAI 同时发布了一篇 16 页论文,论文地址为:https://cdn.openai.com/pdf/lifeval.pdf 。
按照文中说法,LifeVal 是全球第一个「个性化代理消费者任务」基准,核心不在答题,而在完成真实消费者愿意为之付费的生活任务。
1.7 万亿美元估值来自 148 项任务
为了确定人们最需要 AI 帮助处理哪些事务,OpenAI 先研究了美国劳工统计局的《美国时间使用调查》和《多国时间使用研究》,覆盖 25 个国家的人们日常时间分配情况。
随后,OpenAI 对 3800 多名符合美国人口普查分布的真实消费者进行了支付意愿问卷调查。最终,团队筛选出 148 个高价值生活任务。
论文给出的结论是,如果这些任务由一个完美的超级助理完成,美国消费者每年愿意支付的金额合计可达 1.7 万亿美元。原文将这一数字与韩国一年的 GDP 总量作比较,并据此认为,OpenAI 瞄准的是个人服务与家政管理市场中的大体量需求。
文章还提到,如果全球每个人都能用上这一等级的 AGI,影响范围将覆盖 80 亿人。
测试任务覆盖搬家、托育、医疗、出行和家庭事务
论文中列出的 LifeVal 任务具有四个核心特征:高价值、高上下文、个性化和强代理性。
文中举出的案例包括:
- 搬家后选择合适的幼儿园;
- 洪水发生前管理志愿者团队;
- 在预算和要求约束下寻找新住处;
- 陪奶奶远程观看比赛;
- 为被诊断出糖尿病的父母准备餐食。
另外几个案例更具体:
- 癌症康复后的医疗对接:「我 26 年前被诊断出患有脑癌。我要换个新医生,请帮我把我的所有健康信息、就诊记录总结成一个 PDF,并列出我下次就诊需要问的问题。」
- 全职保姆招聘:「我需要为女儿找个全职保姆。帮我筛选简历并找 3 个候选人。要求:必须懂 CPR(心肺复苏)和急救,不吸烟,预算在每小时 25-30 美元。」
- 用信用卡积分预订航班:「帮我找出从芝加哥飞往日内瓦的航班,必须在 3 月 9 日出发,最多中转一次。并且要用上我账户里的信用卡积分。」
LifeVal 要求模型读取记忆、操作网页并接受多重审查
文章称,要完成这些任务,AI 需要具备几类能力。
第一类是调用长期上下文。LifeVal 会接入用户真实的 ChatGPT 历史对话记录和个人记忆档案。文中举例说,如果用户要规划晚餐,模型不能只给出通用菜谱,而要从过往对话中找出「对花生过敏」或「父亲最近得了糖尿病」这类信息,再据此生成方案。
第二类是执行网页和系统操作。LifeVal 为模型提供了一个「强化学习环境(RLE)」,模型需要自己打开浏览器、登录网站、筛选信息、点击按钮、填写表单,并最终生成 PDF 报告。
第三类是通过反作弊审查。OpenAI 为此开发了两个评分 AI,背后使用 GPT-5.6。其一负责核对模型是否真的完成了操作,例如是否真的买到机票,而不是伪造结果;其二负责识别模型是否试图通过后台代码走捷径,一旦发现会直接判 0 分。除此之外,文中还提到至少三轮人类专家交叉审核。
OpenAI披露 GPT-5.2 至 GPT-6 Astra 的 LifeVal 成绩
在论文第 7 页,OpenAI 首次公开了过去一年多代模型在 LifeVal 上的跑分结果,涉及 GPT-5.2、GPT-5.4、GPT-5.5、GPT-5.6,以及 GPT-6 Astra。
文章称,数据呈现出的趋势是,模型能力提升已经不再是线性增长。早期的 GPT-5.2 是唯一一个会因为 Token 耗尽而导致任务失败的模型,在复杂网页操作中经常无法完成任务。
到 GPT-5.4 和 GPT-5.6,表现出现明显转折。文中将原因归结为模型在「电脑使用」「浏览器使用」和「连接器」上的大量训练,成功率显著上升,模型也更接近人类操作网页的方式。
在这组结果中,GPT-6 Astra 被描述为 OpenAI 目前「最对齐」的模型。文章称,在需要高度个人隐私上下文和复杂跨网页操作的任务里,GPT-6 Astra 表现出更高稳定性。
附录测试显示,缺少背景信息会让模型表现明显下滑
不过,文中也提到,即便是 GPT-6 Astra,当前最大的痛点仍然是「错误的信息或建议」。
在附录 B 的测试中,研究人员删除了用户的「附加任务背景」后,模型表现出现明显下滑。这说明模型在从大量历史聊天记录中准确提取关键细节时,仍然存在短板,例如从几万条对话中找出用户几年前提过一次的航班偏好。
文章同时提到,GPT-6.2 Astra 即将到来,并将其描述为下一代更强模型。
从行政负担到个人控制,LifeVal背后的讨论没有结束
围绕 LifeVal 的意义,文章给出了两组相反方向的观察。
一方面,论文提到,低收入家庭可能因为报税、申请社会福利等手续繁琐而放弃本应获得的权益,这类现象在学术界被称为「行政负担」。如果数字超级助理能够免费且准确地完成这些复杂流程,社会福利可能因此增加。
另一方面,论文也引用了多位经济学家的研究。文中写道,当一项技术的成本下降到足够低时,它未必只是替代工作,也可能创造新的需求。文章用洗衣机解放家务劳动作为类比,认为 AI 超级助理可能把人们从查资料、比价格、填表格等事务中解放出来。
但文章最后也提出疑问:当财务数据、医疗记录、家庭关系和饮食偏好都被集中到服务器中,当模型不仅知道用户想吃什么,还能直接代为支付和下单,人与 AI 之间的控制关系会变得更复杂。
参考资料包括 OpenAI 的 LifeVal 页面、Sam Altman 在 X 上的相关推文,以及题为《LifeVal》的论文。原文注明,本文来自微信公众号「新智元」(ID:AI_era),作者为 ASI启示录,编辑为 Aeneas。



