
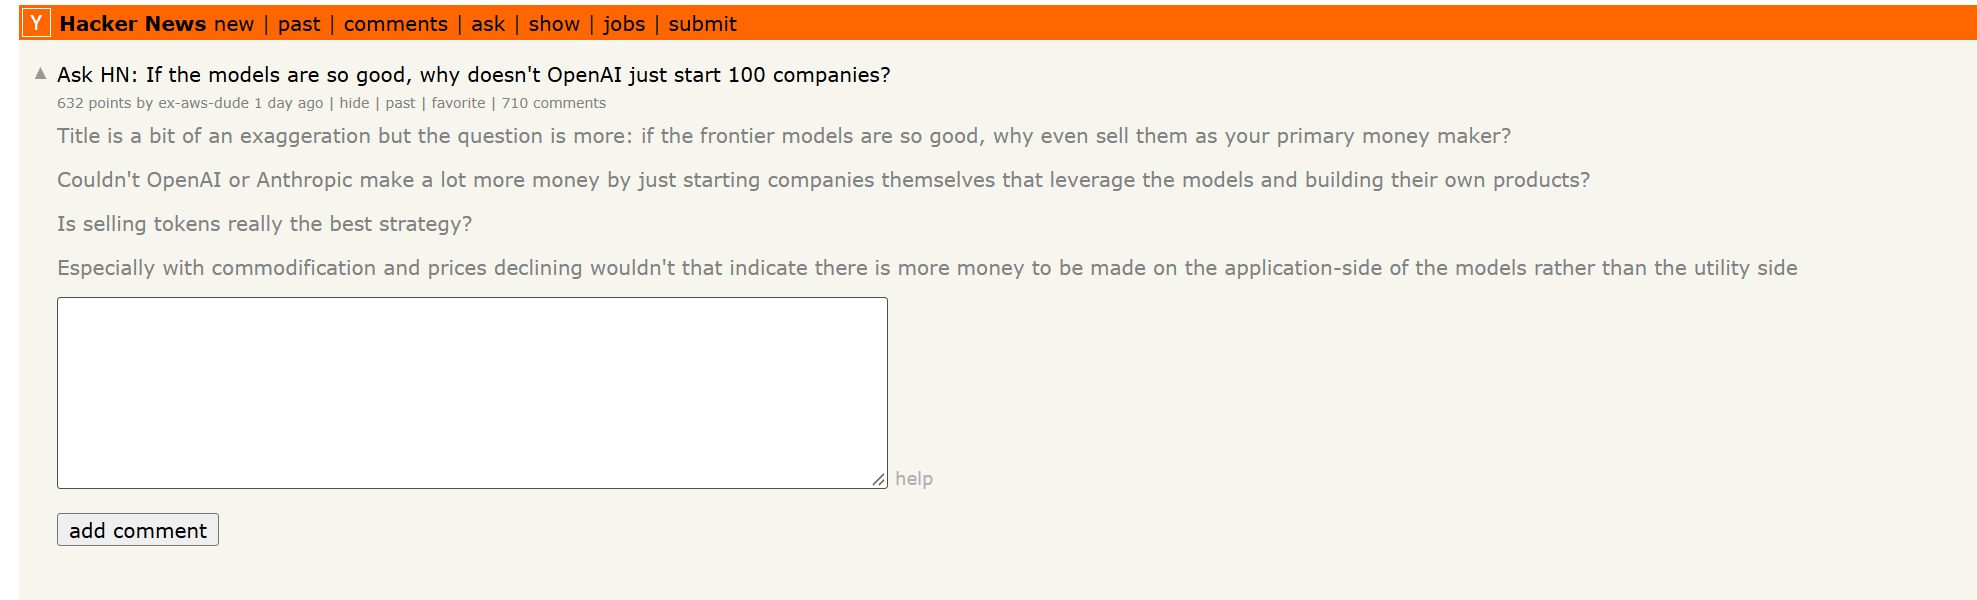
Hacker News 上一则匿名帖子,把一个 AI 行业常被回避的问题摆到了台面上:如果模型已经这么强,OpenAI 为什么不自己开 100 家公司?发帖用户 ex-aws-dude 也承认这个标题带有夸张成分,他真正想问的是,当前前沿模型能力已经很强,为什么 OpenAI 仍主要靠卖 token 赚钱,而不是直接做应用、拿走终端利润。
评论区很快分成两派。一派认为,模型已经强到可以替代大量人力,真正的利润池在应用层;另一派则认为,经营一家公司远比写出好软件更难,AI 还做不到。讨论继续推进后,双方的论据却逐渐指向同一条边界:问题不只是模型够不够聪明,而是没有人愿意让它对结果负责。
模型能力已不再停留在概念层面
从测试结果看,OpenAI 给出的数据已经相当具体。GPT-5.5 在 Terminal-Bench 2.0 上得分 82.7%,GPT-5.4 为 75.1%,Claude Opus 4.7 为 69.4%;在 OSWorld-Verified 上,GPT-5.5 得分 78.7%,高于人类基线。GDPval 的测试结果也被拿来作为佐证:在 44 个职业任务中,GPT-5.5 有 84.9% 达到或超过行业专家水平,上一代 GPT-5.4 为 83.0%。
除了跑分,OpenAI 首席财务官 Sarah Friar 在 2026 年 9 月高盛 Communacopia 会议上还提到两个企业客户案例。她称,Canva 的代码「100% 来自 OpenAI」,平台每周生成数十亿张图片;保险公司 Travelers 的 AI 理赔助手则在两个月内从 8 个州扩展到全美。
这些案例对应的已不是实验室演示。按照文中描述,模型已经能够写生产级代码,处理结构化的专业任务,并在边界明确的场景里高效执行。
真正的限制不在智力,而在判断与责任
Hacker News 评论区对模型短板的判断相对集中:大模型缺乏判断力,也缺乏长期自主性。这里的判断力,不是把已有答案填对,而是在信息不完整、后果不可逆的情况下决定该做什么。
有用户总结,2026 年的模型擅长执行边界清晰、已经被定义好的想法,但看不到全局,缺少远见和创造力。于是原帖的问题被进一步压缩成一句更尖锐的话:如果模型这么好,为什么它们不能自己经营一家公司?
文中的回答是,经营 1 家公司都比经营 100 家更难。公司要成功,远不只是写出好软件,还要判断市场、管理现金流、应对监管、处理客户投诉,并在不确定中押注方向。这些任务没有标准答案,做错了就会带来真实损失。
因此,边界不在于模型能否完成某个智力任务,而在于谁来为结果负责。
Codex 计费调整,把这条边界写得更清楚
OpenAI 自己的产品动作,也被文中视为这条边界的直接体现。2026 年 4 月,Codex 的计费方式从「按消息估算」改为与 API token 用量严格对齐,先覆盖 Plus、Pro 等个人和企业用户,4 月下旬又扩展到教育、医疗、政府等渠道。
与此同时,OpenAI 还推出了「仅 Codex 席位」,没有固定月费,完全按 token 计量,也不设速率限制。
第三方对 Codex credits 的核算显示,1 credit 折合 0.04 美元,Sol 档 750 credits 对应每百万输出 token 30 美元,结论是这套价格「既不是折扣也不是溢价,就是把 API 价目表预付了」。
这意味着,Codex 从一个更像「包月自助」的产品,变成了按 token 精细计量的服务。文中还引用开发者的实际账单作对比:过去 30 天里,他使用 Claude Code 消耗了价值 1199.79 美元的 token,使用 Codex 消耗了 980.37 美元,合计 2180.16 美元,而他实际支付的订阅费只有 200 美元。改成按量计费后,同样能力对应的账面价值被放大了接近 11 倍。
文章据此提出一个反向观察:如果 OpenAI 对模型交付能力已经足够有把握,那么按任务收费或按成果分成理论上可能更赚钱。但 OpenAI 没有这么做,而是把计费颗粒度压到了 token 级别。按 token 卖,卖的是算力和能力的使用权,不是结果本身。至于用户拿去做什么、最后做成还是做砸,风险仍由用户承担。
400 亿美元年化收入,建立在 token 生意之上
Sarah Friar 在高盛会议上披露,OpenAI 的年化营收运行率在 2026 年 7 月突破约 400 亿美元,其中企业端业务,也就是企业订阅加 API,已经超过一半。她说:「我们年初是 60 比 40,但企业加速远超预期,两条线现在已经交叉。」
按照她给出的数据,OpenAI 整体年化收入在 6 月到 7 月环比增长 20%,企业业务同期增长 32%。
第三方数据也被用来交叉验证这一趋势。支付数据公司 Ramp 在 2026 年三季度报告中称,企业在 OpenAI API 上的支出环比增长 82%,在 Anthropic 上的支出环比增长 76%。
价格变化同样值得注意。GPT-5.5 相比 GPT-5.4 单价翻倍:输入价格从每百万 token 2.5 美元涨到 5 美元,输出价格从 15 美元涨到 30 美元。OpenAI 的解释是,模型更智能、token 效率更高,完成同一任务所需的 token 更少。
而在更早的型号上,降价也带来了相反方向的收入效果。文中提到,Luna 型号在最多降价 80% 后,用量增长约 10 倍,粗略计算对应收入约为降价前的 2 倍。单价下降,但总量增长更快,总收入反而上升。文章将这一现象视作 AI 语境下的杰文斯悖论:效率提升和成本下降,并没有缩小市场,反而把市场做大了。
Friar 还给出一组使用强度数据:前 10% 客户的人均每周 token 消耗是平均客户的 8 倍,此前这一倍数为 3 倍;OpenAI 公司内部员工的人均消耗则是平均客户的 33 倍。她的判断是,「头部客户今天的用法,就是普通客户两年后的用法」。如果这一判断成立,token 总消耗量仍未见顶。
Codex 用户规模也在快速增长。文中称,这一产品的用户数从 2026 年 1 月约 10 万增至 9 月约 2500 万。OpenAI 官方估算,平均每名开发者每月消耗 100 到 200 美元。若仅取中间值 150 美元乘以 2500 万人,年化规模会非常可观,不过文中也同时指出,实际付费率和平均消耗必然低于这一上限。
按成果收费仍是方向,但还不是主流现实
在同一场活动上,Friar 也谈到另一种可能的商业模式。她表示,企业客户越来越需要针对特定需求定制的 AI 系统,OpenAI「将基于业务成果而非使用量定价」。她还提出,行业应按「每任务成本」而不是「每 token 成本」评估模型,并引用第三方数据称,Astra 在达到同等结果时,所用 token 比竞争前沿模型少 68%。
不过,文章认为,这两句话放在一起,恰好说明 OpenAI 想去的方向和它当前所处的位置并不相同。「将基于业务成果定价」仍是将来时,而 Codex 刚完成的改革却是把计费进一步压到 token 粒度。
按成果收费的前提,是模型能够对结果负责,或者至少稳定交付可度量的结果。Travelers 的理赔助手扩展到全美,看上去接近这一标准,但那发生在保险理赔这种流程高度标准化、判断标准相对明确的场景中。对大多数企业业务来说,「成果」本身就不容易定义,更不用说由谁承担成果不达标的风险。
文中还提到一个类比。评论区有人把 OpenAI 比作苹果和 App Store,认为卖 token 是一种「无风险的钱」:平台从每个应用中抽取收益,却不承担经营风险。文章指出,这个类比并不完全准确,因为苹果抽的是交易流水固定比例,OpenAI 卖的是算力消耗,但背后的逻辑相通:平台把自己放在不对业务结果负责的位置上,收入就能随着下游应用总量一起增长。
广告则被视为另一个试探方向。Friar 称,OpenAI 的广告业务上线 7 个月后达到 10 亿美元运行率,是公司「最快达到 10 亿美元的产品」,已覆盖 40 个国家,客户包括 WPP 与电通,AI 原生广告格式尚未推出。相较 400 亿美元的大盘,10 亿美元占比仍小,但广告的商业逻辑是按注意力或转化收费,比按 token 更接近按结果付费。文中判断,它目前仍只是侧翼业务。
还有评论者指出,当前 API 价格中可能包含风险投资补贴成分,推理层面毛利为正,但公司整体仍在亏损。如果这一判断成立,那么 token 定价还没有覆盖全部成本,OpenAI 当前更紧迫的任务,是先把 token 收入规模做大,而不是贸然切换到尚未验证的收费模式。
HubSpot 已在部分场景试水成果定价
文章最后提到,已经有公司开始在更容易量化结果的场景里试探这条边界。根据 HubSpot 公司新闻稿,自 2026 年 4 月起,HubSpot 将旗下 AI 客服代理 Breeze Customer Agent 的收费方式从「每对话 1.00 美元」改为「每个成功解决的对话 0.50 美元」;销售线索代理 Breeze Prospecting Agent 则改为「每一条被推荐用于外呼的线索 1 美元」。
HubSpot 首席客户官 Jon Dick 的表述很直接:「企业正在被要求为 AI 下大注,但太多时候,他们买的是潜力而非表现。按成果定价去掉了这个风险——有效果才付钱,没有但是。」
不过,这仍是发生在客服和销售线索这类成果容易度量的场景里,距离「替客户经营一门生意」还有明显距离。
OpenAI 现在卖的不是结果,而是能力使用权
文章的核心判断是,模型确实已经很强。它强到 Canva 可以用其生成全部代码,强到 Travelers 能在两个月内把 AI 理赔助手从 8 个州扩展到全美,也强到在 44 个职业任务中,GPT-5.5 有 84.9% 达到或超过行业专家水平。
但从「强」到「能经营一家公司」,中间还隔着一层更难跨越的要求:对不确定性的判断、对结果的承诺,以及对失败的承担。
按 token 出售模型,本质上是一条更安全的线。OpenAI 站在线的一边提供能力,客户站在另一边承担风险。文中认为,约 400 亿美元的年化营收、82% 的 API 支出环比增长、约 2500 万 Codex 用户,都说明这条线目前画在了一个有效的位置。至于 Friar 所说的「基于业务成果定价」,描述的是这条线未来可能移动的方向;而 Codex 改成按 token 计费,则说明这条线现在还没有真正跨过去。



