
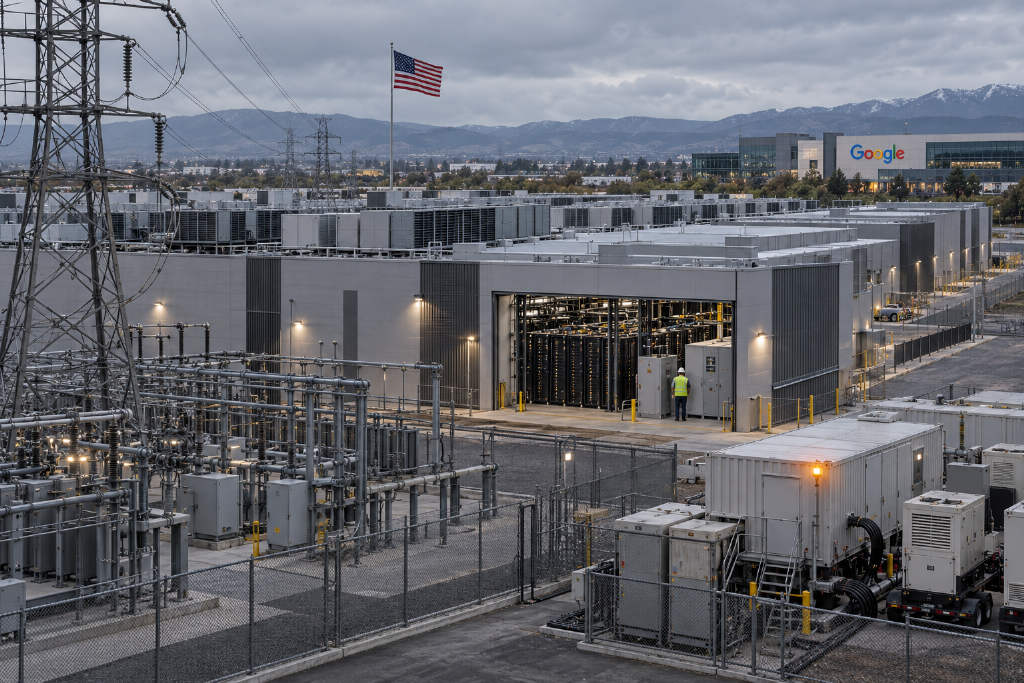
一名前 Google 员工近日在一场访谈中表示,当前 AI 算力的真正瓶颈,可能不在 GPU 产量,而在数据中心容量与电力。他指出,美国市场的 GPU 供给跟不上需求,主因是机房与电力不足;部分 Neocloud 业者的可靠性问题,也让客户承受不小压力。
低延迟 GPU 容量在美国供不应求
这名专家表示,目前最大的限制是「容量」。部分公司的流量增长达到 5 倍,但市场上可用的 GPU 容量不足,尤其是对延迟要求最严格的客户,GPU 必须部署在美国境内。
从技术上看,业者可以把部署地点转向新加坡、马来西亚或澳大利亚来取得 GPU,但多数客户并不接受更高的延迟。他形容,市场上「可用的容量很多,但没有一个好」。
他举例说,部署大型模型时需要快速加载,像约 3 TB 的模型,理想状态下要在 10 分钟内从文件系统载入 GPU。也就是说,除了 GPU 本身,网络与文件系统质量同样关键。
GPU 云服务商分三层,各有各的问题
这名专家将 GPU 云端供应商分成三层。
- 第一层是 Hyperscaler。包括 AWS、Azure,以及他认为也应纳入的 Oracle。这类平台可靠性高,但价格昂贵,合约通常要求至少 3 年。与此同时,客户当前追逐的是 B300,连 B200 近期都开始被视为「过时」,因此很少有人愿意为一批旧世代 GPU 绑定 3 年合约。
- 第二层是 Neocloud。例如 Nebius、Vultr 和 CoreWeave 等,数量约 20 至 30 家。专家称,其所在公司约 80% 至 90% 的容量放在这一层,但这类服务商可靠性较差,需要投入更多工程资源进行协调。
- 第三层是新兴小型业者。这类公司多由看见商机的投资人和传统基础设施业者自建数据中心,分散在美国各地,单一据点约有 4,000 颗 GPU,知名度不高。按这名专家的说法,「连卖不卖得出去都是问题」。
Neocloud 稳定性与付款条件都更棘手
谈到 Neocloud 的可靠性问题时,这名专家举例称,有客户部署了 90 个模型副本,每个副本需要 8 颗 GPU,总计 720 颗;但某天凌晨,其中 20 颗 GPU 在没有预警的情况下断线,原因被推测为网络问题,或 Blackwell GPU 过热。
在付款条件上,他表示,多数美国 Neocloud 业者要求 20% 至 30% 的预付款,其余款项按月或按季支付,等到合约期满后,再就事故造成的损失协商折让,例如流量长期损失 15%。相比之下,亚太地区业者通常不要求预付。
开源模型追赶加快,客户开始替换 Anthropic 与 OpenAI
这名专家还提到模型侧的变化。他观察到,开源模型正在追赶先进模型,而且最近一个月速度更快。自今年第二季度前后开始,客户已在多代理架构中,用开源模型替换部分 Anthropic 与 OpenAI 的模型。
在他看来,这种替换路径会由简到繁推进:
- 先从调用工具、MCP 等简单任务开始;
- 再向底层编排(low-level orchestration)推进;
- 最后进入日常开发与调试。
他以 Cursor 为例称,最上层编排仍使用 Anthropic 与 OpenAI 的模型,底层并行搜索代码则可以换成 Composer 2.5,并称其为 Qwen 的后训练模型。他还透露,下一波值得关注的是 GLM 5.2,市场也已经在讨论 Kimi K3。
未来一两年 GPU 供给会改善,但电力仍是关卡
对于未来两年,这名专家认为,随着 NVIDIA 持续扩大出货,GPU 的可用性会在一两年内明显改善。但他同时强调,真正投入数据中心运行的 GPU 总量不会增加太多,原因是美国缺乏足够电力。他的判断是,「极度短缺的是数据中心,而非 GPU」。
他还观察到,Meta 与 xAI 已有部分闲置 GPU 集群,并开始自建云业务对外出租,预计未来会有更多业者跟进。
马斯克随后转发相关内容并回应称:「『缺电』这个说法过度简化,要让大规模算力以极快速度上线,每个环节都很困难。」他表示,如果时间多一倍,事情会相对容易,但现实是根本没有那么多时间。



