
据《The Information》报道,OpenAI 首席执行官萨姆·奥特曼(Sam Altman)近日在一次内部员工会议上,谈到 AI 竞赛可能出现的三种终局:建立全球性监管机构、顶级实验室合并为一家机构,或由某家公司率先突破关键技术,甚至具备让竞争对手硬件陷入瘫痪的能力。
在这三种路径中,奥特曼将最后一种描述为最糟糕的结果,并直言这是「糟糕透顶」的结局。
三条路径对应三种不同治理框架
奥特曼提出的第一条路径,是建立一个类似国际原子能机构(IAEA)的全球监管组织,对最先进的 AI 系统进行监督,制定统一安全标准,并要求开发企业接受独立审查。
早在 2023 年 5 月,奥特曼就曾与 OpenAI 联合创始人 Greg Brockman、时任首席科学家 Ilya Sutskever 共同发表《超智能治理》(Governance of Superintelligence)一文,提出未来可能需要设立类似 IAEA 的国际机构,对达到特定能力或算力门槛的 AI 开发活动实施监管,包括系统检查、安全审计、合规测试,以及对算力和能源消耗的监测。
不过,报道提到,AI 已成为各国重点投入的战略技术,国际监管会牵涉技术保密、国家安全和产业竞争,各国是否愿意接受统一规则,仍存在很大不确定性。
第二条路径,是全球领先的 AI 实验室最终合并为一家机构。奥特曼将其称为「Demis 方案」。这一说法对应 Demis Hassabis 曾提出的设想:AI 研究可以借鉴欧洲核子研究中心(CERN)的模式,由多个国家共同建设和管理一个大型研究机构。
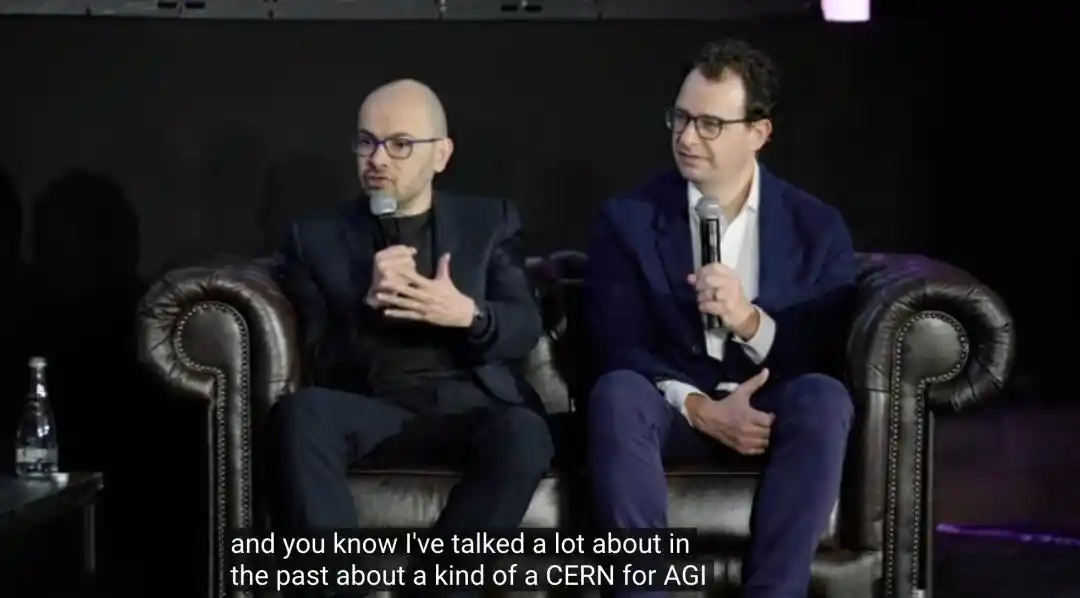
如果头部 AI 公司由同一个组织统一管理,安全标准和实践经验可以共享,也能减少各家公司为了抢先发布产品而持续加快研发节奏的情况。
但问题同样明显。最先进的模型、人才和算力一旦集中到一个组织,该机构将掌握巨大的技术和经济影响力,如何避免权力过度集中,会成为新的难题。
「Eliezer 方案」指向赢者通吃局面
第三条路径被奥特曼称为「Eliezer 方案」,对应 AI 安全研究者 Eliezer Yudkowsky 提出的一类极端设想。Yudkowsky 长期警告,失控的超级智能可能给人类带来生存风险。他曾主张,率先掌握超级智能的一方需要采取决定性行动,阻止其他组织开发潜在危险的超级智能系统。
奥特曼在内部讨论中将这一设想与递归自我改进(Recursive Self-Improvement,RSI)联系起来。所谓 RSI,是指 AI 可以参与改进自身的模型架构、训练方法或开发流程,而升级后的 AI 又能继续提升这些能力,形成持续的自我改进循环。
一旦这种机制达到足够高的自主化程度,AI 研发速度可能明显加快。如果某家公司率先突破 RSI,就可能迅速建立其他竞争对手难以追赶的技术优势,最终形成市场垄断。
在最极端的情况下,这家公司甚至可能拥有干扰或破坏竞争对手 GPU 的能力。对于将先进 AI 集中在单一企业手中的结局,奥特曼明确表示反对。
奥特曼再次强调两类核心风险
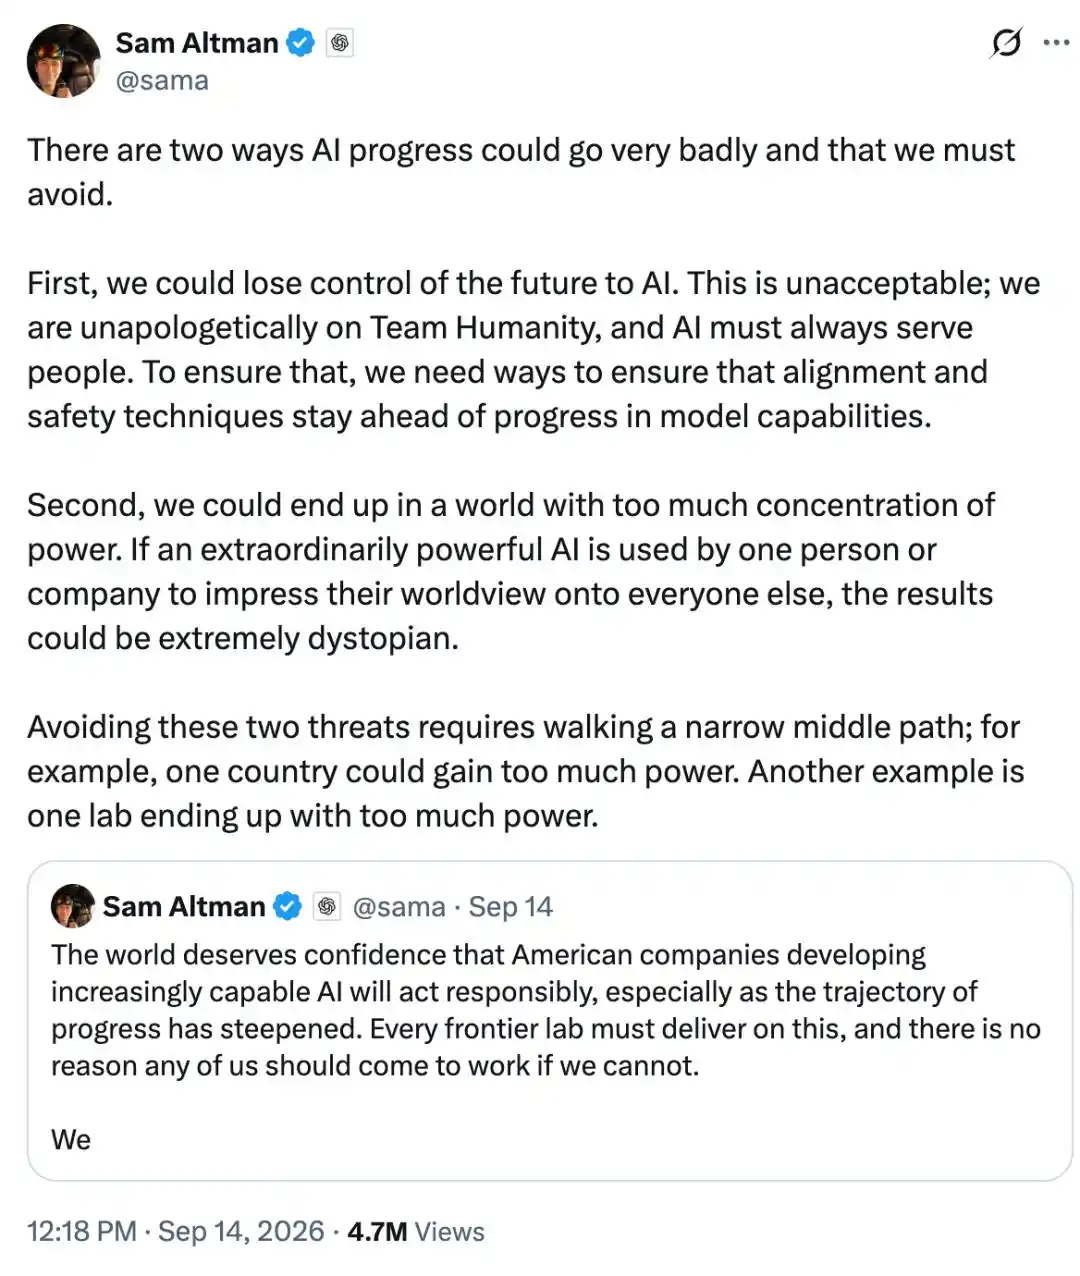
这次内部讨论,延续了奥特曼此前反复提到的风险判断。2026 年 9 月中旬,他曾公开表示,先进 AI 可能带来两大主要风险:一是人类失去对 AI 系统的控制,二是 AI 权力集中在少数组织手中。
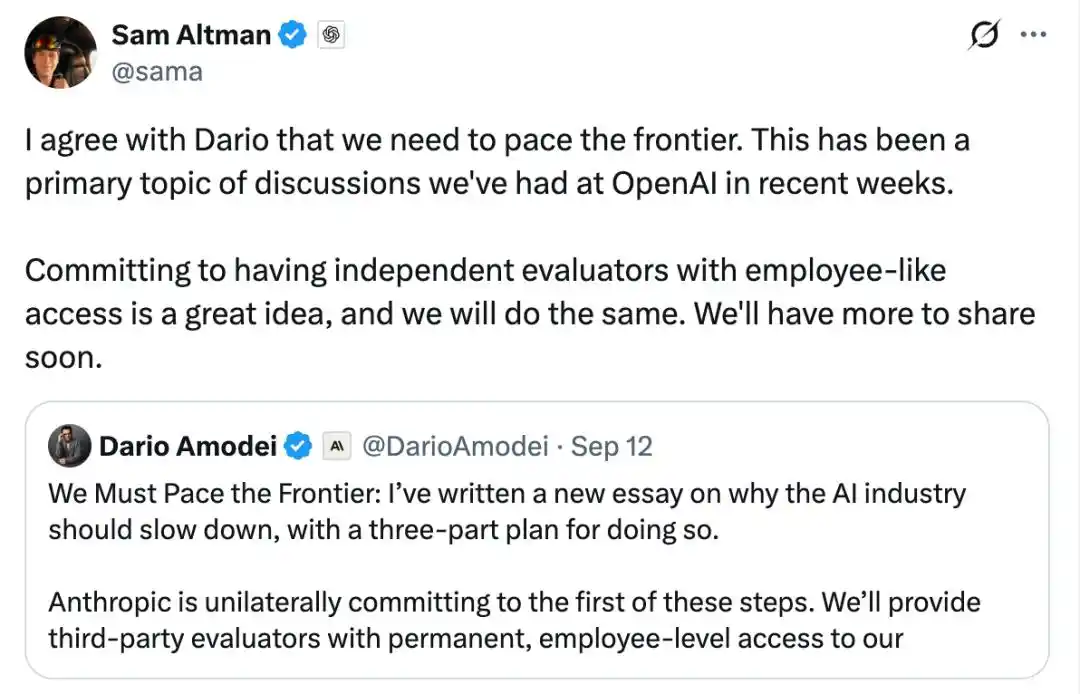
他当时强调,必须避免 AI 发展走向上述任何一种结果。按他的说法,OpenAI 应当站在全人类立场上,而不是只服务于某家公司或某个利益集团。奥特曼还呼吁建立更严格的 AI 安全协议,并对先进 AI 系统开展独立评估。
报道还提到,这一立场与 Anthropic CEO 达里奥·阿莫迪的部分观点一致。不过,奥特曼也在内部承认,OpenAI 目前无法轻易放弃与竞争对手争夺技术领先地位。
相关参考链接
- 《The Information》报道:Altman Describes Three Endgames for AI, Including One Where a Single Firm Melts Everyone Else’s GPUs
- OpenAI《Governance of Superintelligence》:https://openai.com/index/governance-of-superintelligence/
- Demis Hassabis 相关视频:https://www.youtube.com/watch?v=4poqjZlM8Lo
- Eliezer Yudkowsky 文章:https://www.lesswrong.com/posts/uMQ3cqWDPHhjtiesc/agi-ruin-a-list-of-lethalities



