
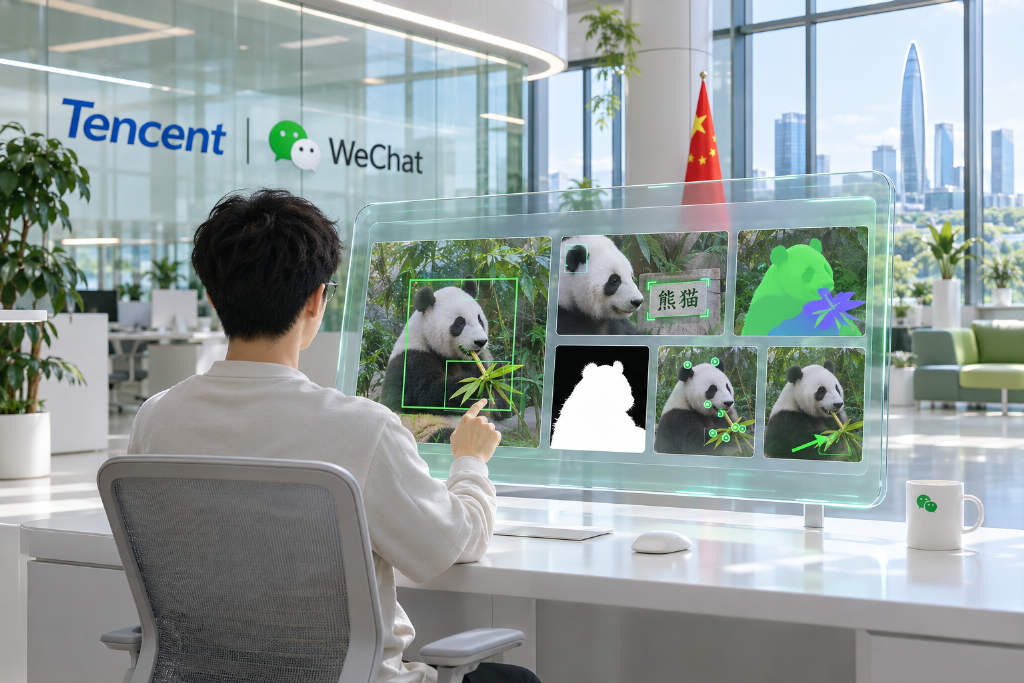
Techub News 消息,腾讯微信视觉团队发布开源视觉语言模型 WeVisOne-VL,提供 2B 和 4B 两种参数量版本。
该模型可在一个模型中统一处理目标检测、指代、计数、指向、OCR、分割与 Alpha 通道抠图等任务,无需单独的 SAM 模型。其像素输出由一个 960 万参数的解码器生成。
据 MarkTechPost 介绍,WeVisOne-VL 在 30 多个基准测试中,在多数任务上超越了同规模基线模型。
本文最初由 Bit.Fan 发布。 欲了解更多加密货币新闻与市场洞察,请访问 www.bit.fan.



