
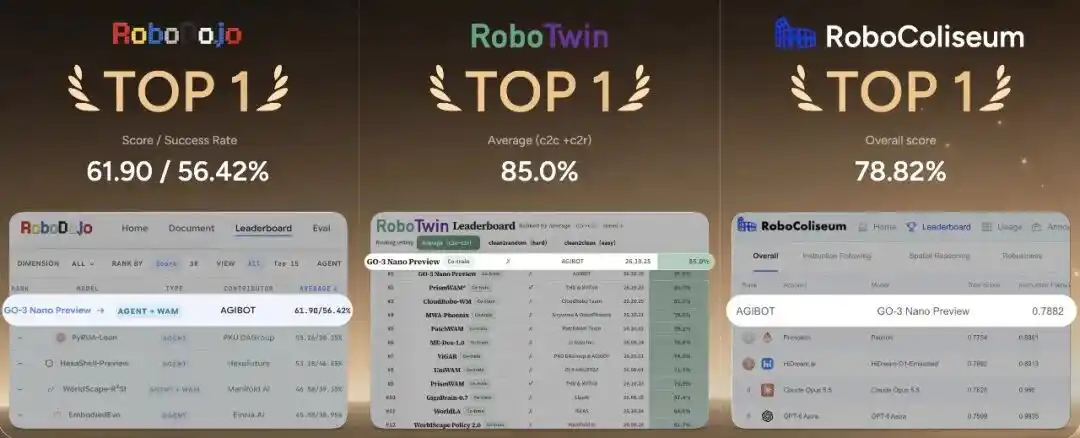
智元于 10 月 29 日发布具身模型 GO-3 Preview,称其实现了预训练、后训练和部署后三个阶段的全链路规模化学习,并在 RoboDojo、RoboTwin、RoboColiseum 三项权威评测中拿下第一。
从 GO-1 的 ViLLA 架构、GO-2 的「动作思维链」,到 GO-3 Preview 的全链路规模化学习,智元这次把重点放在机器人更完整的生命周期上:不只是在训练阶段学习技能,也希望机器人在真实工作中继续积累经验、改进能力。
预训练:先从人类第一视角视频学习技能
在 GO-3 Preview 的预训练数据中,约 90% 来自人类第一视角数据。智元称,这类数据覆盖的场景和技能范围,比机器人示范更广。
不过,看懂人类如何操作,并不等于机器人可以直接复现。人体位姿与机器人的关节控制、末端执行器轨迹并不能一一对应,机器人还需要把观察到的操作经验转成适合自身执行的动作。
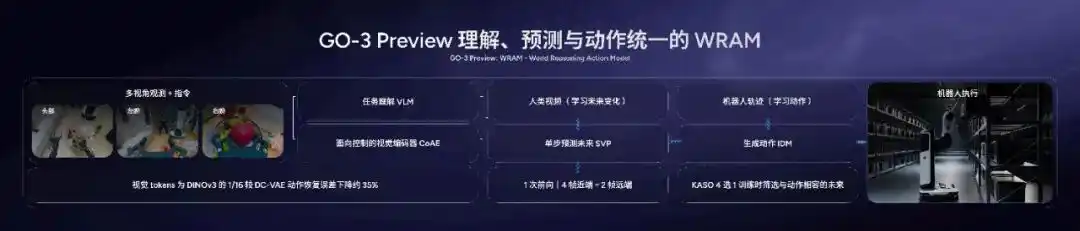
为此,GO-3 Preview 采用具身原生架构 WRAM,即 World Reasoning Action Model。该架构把任务理解、未来状态预测和动作生成串联起来,让机器人既能预测物理状态如何变化,也能学习实现这些变化所需的动作。
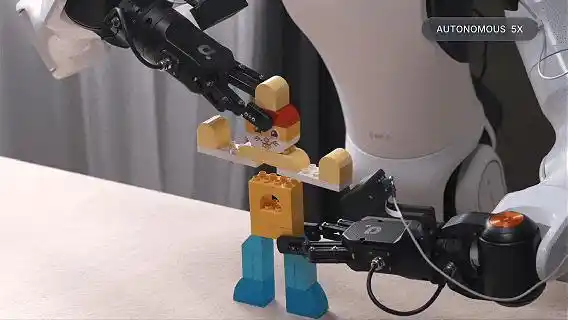
以乐高拼装为例,机器人不仅要识别零件与插槽之间的空间关系,确定目标位置和姿态,还要控制机械臂完成抓取、对齐和插入,并处理不断变化的接触关系。
WRAM 将这一过程拆分给多个协作模块。首先是 CoAE,作为面向控制的视觉表征模块,负责从相机画面中提取物体位置、形态及相互关系等操作信息,同时兼顾视觉信息丰富度与实时推理效率。
在获得当前场景表征后,SVP 即单步视觉规划器会根据当前观测和任务条件,通过一次前向计算预测多个未来时刻的视觉状态。随后,逆动力学模型再结合机器人自身状态,把这些预测转化为可执行动作。
在这一框架下,人类视频与机器人轨迹分别承担不同作用:前者帮助模型学习物理状态如何变化,后者提供从状态变化到动作控制的训练信息。
但未来状态预测并不只有一种答案。同一个任务,往往存在多条合理路径。比如把杯子放到指定位置,机器人既可以从左侧接近,也可以从右侧抓取,不同路径都可能完成目标。
针对这一问题,GO-3 Preview 引入 KASO,即知识对齐选择性优化。该机制会生成多个候选未来,评估预测结果与真实动作的相容程度,再选择更合适的结果参与联合训练,让未来状态预测与动作学习保持协调。
智元表示,在给定测试条件下,扩大训练数据规模能够改善模型在新场景、新物体上的操作表现,并在不同机器人本体上带来性能收益。
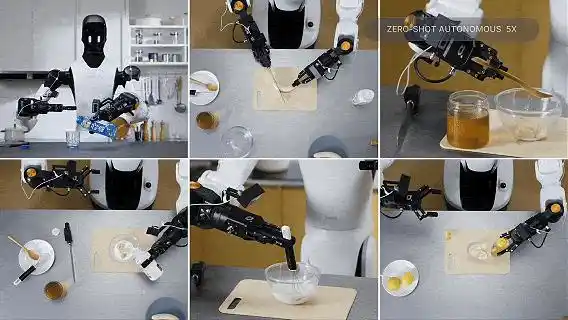
具体到 GO-3,智元将预训练后的任务能力分为 Zero-shot 和 Few-shot 两种设置。Zero-shot 用于检验模型在无需目标任务专属真机监督微调时的迁移能力;Few-shot 则通过少量示范,提升复杂操作的精度与协调性。
据智元介绍,GO-3 Preview 已具备数百种任务的开箱即用能力。在乐高拼装演示中,经过少量示范微调后,模型可以完成零件抓取、对位、插入等精细动作,并在 Agent 编排下连续完成拼装。
除了桌面操作,GO-3 Preview 还展示了跨本体能力。在双足人形机器人 X2 上,模型能够完成双手持物开门、跪地取物等动作。
后训练:在真机、仿真和世界模型中反复练习
智元认为,预训练扩展了机器人的技能范围,但面对更复杂的物理任务,仅靠「看视频」还不够,机器人还需要在交互中持续练习。
桌面冰壶是其给出的一个案例。任务要求机器人控制力度和角度,把对手的冰壶撞出得分圈,同时让自己的冰壶留在圈内。实际执行时,摩擦、碰撞和运动轨迹都会影响结果,出手力度稍有偏差,就可能改变最终位置。
根据智元提供的实验案例,GO-3 Preview 通过在真实环境和世界模型中持续练习,仅用几个小时,就在桌面冰壶任务中取得了高于普通人类玩家的胜率。
这对应的是具身智能后训练中的一个方向:让机器人通过交互、反馈和策略更新,持续提升复杂动作的执行能力。
问题在于,机器人练习会消耗真实资源。每次物理交互都涉及设备运行、环境复位和数据采集,反复试验还伴随设备损耗与安全成本。要让机器人掌握更多技能,就需要扩大交互经验规模,同时提高数据利用效率。
为此,GO-3 Preview 构建了 Genie Evolver,这是一套结合真机、物理仿真和世界模型的分布式混合环境后训练系统。
真机:提供可靠的物理反馈
在真实机器人层面,Genie Evolver 依托百台级真机集群,通过 CEL,即群体经验学习,汇聚执行经验。
例如,不同机器人在抓取物体时,有的成功,有的滑落。系统会检索成功动作片段,分析失败上下文,并更新共享策略,让个体经验服务于群体学习。
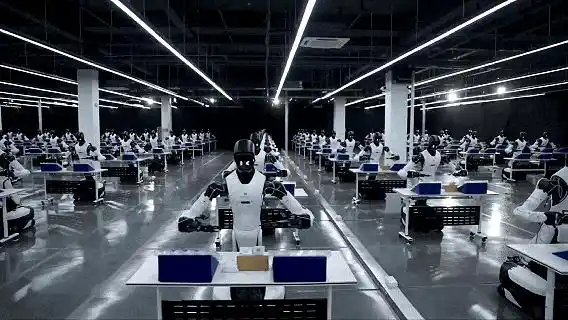
智元给出的真机规模实验显示,在同等训练时间下,随着参与学习的真机规模扩大,手机包装任务成功率由 50.8% 提升至 98.3%。在多阶段手机包装长流程测试中,120 次测试的失败次数由 25 次降至 2 次,减少 92%。
仿真:扩大可重复练习的范围
第二类环境是物理仿真。系统可以在仿真中调整物体位置、摩擦系数和碰撞条件等参数,让机器人尝试不同策略。
以桌面冰壶为例,仿真环境能够覆盖更多初始状态和出手条件,便于比较不同策略的执行结果。
世界模型:扩展候选动作的探索空间
第三类环境是世界模型。仍以冰壶任务为例,如果一次投掷偏离目标,世界模型可以回到此前的关键决策点,预测不同力度和角度可能带来的结果。这样,一次真实经历就能成为探索多种候选动作的起点。
系统会利用世界模型生成的反馈优化策略,再回到真实环境验证,以提高真实交互数据的利用效率。智元同时提到,由于世界模型仍可能误判摩擦、碰撞等物理过程,真机验证仍不可缺少。
除了冰壶,智元还给出抽积木实验。GO-3 Preview 需要依次抽出堆叠的红色积木,但每次操作都会改变剩余积木的位置、姿态和受力关系。机器人必须持续观察并调整后续动作,这考验的是长程任务中的状态跟踪与持续适应能力。
从系统设计看,Genie Evolver 的目标是扩大机器人能够利用的有效交互规模:真机提供物理反馈,仿真拓展训练范围,世界模型探索候选未来,三者共同推动策略持续改进。
部署后:在真实作业中继续积累经验
在智元的设想中,机器人完成训练后进入真实作业环境,工作本身也可以成为新的学习来源。便利店补货就是其部署后 Scaling 的一个场景。
在这一场景中,机器人需要根据补货任务识别商品、规划操作顺序,并完成抓取、移动和摆放。货架空间、商品位置和包装材质各不相同,还可能出现滑落、摆放空间变化等异常。如何把这些作业数据用于下一轮学习,是 GO-3 Preview 部署后阶段关注的重点。

为此,智元构建了具身 Agent 框架 Genie Master,把任务规划、执行检查、异常恢复和经验记忆组织在一起。
为了让任务判断落实为动作,Genie Master 引入具身执行协议 EEP,连接能力调用、执行引导、结果反馈与任务连续性。机器人执行后,成功与否、卡在哪一步等信息会返回 Agent;如果任务中断,系统也能保留进展,并从断点重新规划。
以便利店补货为例,Genie Master 可以安排操作步骤、检查执行结果,并在异常发生后调整计划。作业过程中积累的成败经验,则通过两条路径参与能力改进。
经验进入提示与记忆,改善任务规划
第一条路径,是把成功、失败和异常恢复案例沉淀为记忆,提取操作顺序、关键约束和注意事项。当机器人再次遇到类似任务时,可以检索相关经验,辅助规划与异常处理。
智元举例称,在便利店挂货时,机器人曾因头部相机看不清、标签牌遮挡而无法定位挂钩。Agent 回溯失败记录后,调整执行方式:让左手靠近目标,用腕部相机补充近距离视角,再由右手完成挂货。这套处理方法也可以沉淀为经验,供后续类似任务调用。
执行与恢复数据进入训练,更新动作策略
第二条路径,是把真实作业中积累的成功与失败轨迹用于动作模型训练。
例如在打包外卖时,水瓶和夹爪容易被白色提带缠住。Agent 会通过更具体的动作提示,引导夹爪先收回,再重新尝试放入包装袋。相关执行与恢复数据经过处理后,可用于后续动作策略训练。
智元称,这是行业首次跳出仿真环境、走出实验室,在真实业务场景中验证 Physical RSI,即具身递归自进化。按照其说法,真实作业中的成功、失败和异常恢复经验,都可以成为下一轮能力更新的素材。
据智元介绍,搭载 Genie Master 的精灵 G2 已在真实便利店开展部署验证。在不依赖人工示范与调试的情况下,机器人通过定位问题、调整执行方式和积累经验,在熟食打包、取货、补货等任务中持续改进。
从预训练到上岗后的持续学习
按照智元的划分,GO-3 Preview 负责建立通用操作能力,Genie Evolver 通过虚实交互优化策略,Genie Master 则让机器人在实际工作中继续学习。
整套路线对应的是一条从预训练、后训练到部署后的连续成长路径:先通过人类第一视角视频和机器人轨迹学习技能,再在真机、仿真和世界模型中反复练习,最后把真实作业中的成功、失败和异常恢复经验重新纳入下一轮能力更新。
本文来自微信公众号「机器之心」(ID:almosthuman2014),作者署名为「关注具身智能的」。



