ICM

DigClaw
2026-08-25 02:36:09

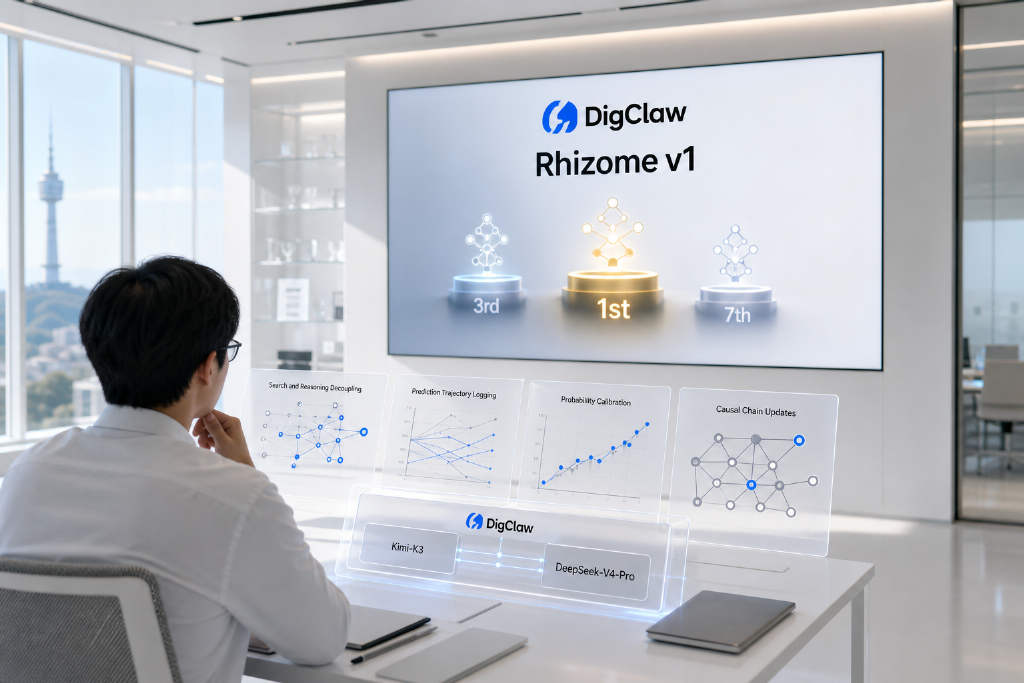
DigClaw称其 AI 预测框架 Rhizome 在 FutureX 拿下三个前十席位

DigClaw 表示,其预测框架 Rhizome v1 于 7 月在 FutureX 实时预测榜单上分别基于 Kimi-K3、DeepSeek-V4-Pro 等不同基础模型拿下第 1、第 3 和第 7 名。公司称,这是同一套框架在不同基座上的独立运行结果,指向预测能力可沉淀在基础模型之外。文章披露了 Rhizome 的三项设计,包括搜索与推理解耦、预测轨迹记录与概率校准,以及因果链感知的持续更新,并称相关系统已用于内部投资实践。

440
DigClaw称其 AI 预测框架 Rhizome 在 FutureX 拿下三个前十席位
人工智能
2026-08-20 11:03:11

陶哲轩与王虹聚焦 AI 数学证明“消化”环节

围绕 AI 大量介入数学证明,陶哲轩与王虹给出了接近一致的判断:数学界不能只停留在“证明已得出”,还需要理解、整理并消化成果。陶哲轩以 Sendov 猜想为例,说明 AI 更擅长生成与验证,后续的阐释、发表和知识沉淀仍依赖数学家。他还公开了面向 Lean 验证结果的登记库 Palomar,试图为 AI 证明建立从验证到发表之间的整理与协作机制。

390
陶哲轩与王虹聚焦 AI 数学证明“消化”环节
谷歌研究
2026-08-14 07:41:09

谷歌研究称 GPT-5 与 Gemini 3 存在“舌尖现象”

谷歌研究发现,GPT-5 和 Gemini 3 等模型对 95%–98% 的测试事实已完成参数存储,但在直接问答中仍有 26%–34% 的事实无法取出,即使开启 thinking 后仍有 11%–12% 无法回忆。研究基于新基准 WikiProfile,对 13 个模型累计生成约 450 万条回答。结果显示,前沿模型事实错误的主要瓶颈已从“没学到”转向“取不出”,冷门知识和反向提问是最明显的卡点。

640
谷歌研究称 GPT-5 与 Gemini 3 存在“舌尖现象”
OpenAI
2026-08-09 23:25:08

OpenAI研究员引发争议:前沿实验室为何越来越少读论文

围绕一位 OpenAI 研究员“我们都不读论文了”的表态,学界与产业界再次讨论顶会论文的可信度。由芝加哥大学副教授谭宸浩联合创办的 SAI 对 ICML 2026 的 168 篇 Oral 论文做复现实验,完成 105 篇完整复现后发现,只有 8 篇复现比例超过 80%。报告还提到代码缺失、结果对不上、依赖下线模型等问题,而高昂复现成本也让有缺陷的论文更难被外部核查。

1450
OpenAI研究员引发争议:前沿实验室为何越来越少读论文
AI论文复现
2026-08-09 08:20:07

AI复核论文掀出高比例问题,顶会复现审计结果引发关注

针对 ICML 2026 论文的两项 AI 复现与核查项目显示,论文可复现性和客观错误问题正在被集中暴露。一项审计称,168 篇口头报告中有 92 篇具备至少 5 条可验证结论,其中 58 篇无法复现;另一项基于 GPT-5 的检查系统则称,顶级 AI 会议和期刊论文平均每篇检出 4.7 个客观错误,99.2% 的论文至少被标记出一个问题。不过,报道同时强调,无法复现并不等同于造假,AI 工具结果仍需人工复核。

1290
AI复核论文掀出高比例问题,顶会复现审计结果引发关注
AI
2026-07-22 07:54:07

ICML 2026 论文提出 SSNA:随机噪声也能迁移出分类增益

发表于 ICML 2026 的 SSNA 研究提出,迁移学习中的源数据不必是真实图像或文本,随机生成的噪声也能在少量标注场景下带来正迁移。团队进一步给出 NAF 框架,在 CIFAR、Caltech、ImageNet 和 AG News 等任务上,相比 ERM 取得不同幅度提升。实验还显示,真正起作用的不是噪声的随机性,而是其在表征空间中的可分离类别结构。

350
ICML 2026 论文提出 SSNA:随机噪声也能迁移出分类增益
国际数学奥林匹克
2026-07-20 02:47:39

中国队获 IMO 2026 团体冠军,GPT-5.6 解题报道引发关注

第 67 届国际数学奥林匹克 7 月 13 日至 21 日在上海举行,中国队以全员金牌、团体总分 232 分夺冠,领先第二名美国队 25 分。邓乐言、张柏伦、刘澈以满分摘金。报道同时提到,GPT-5.6 Pro 被称在无人工提示下首次尝试解出 2026 年 IMO 全部 6 题,但截至成绩揭晓尚无官方公开结果。

2620
中国队获 IMO 2026 团体冠军,GPT-5.6 解题报道引发关注