
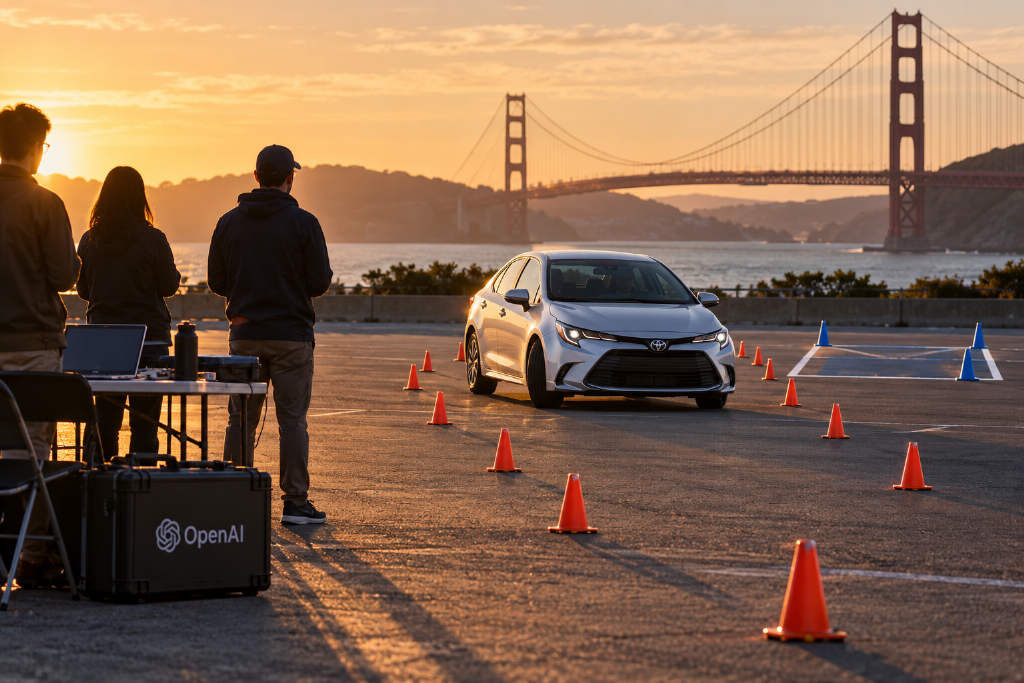
三名美国旧金山湾区工程师发起的 DrivingBench 实验,把 4 款通用大型语言模型接到一辆真实的 2022 款 Toyota Corolla 上,在停车场完成低速驾驶测试。任务是沿着由小型三角锥排出的赛道前进,并在终点停入蓝色三角锥围出的车位。9 月 21 日公开的结果显示,4 款参测模型中,只有 OpenAI 的 GPT-6 Astra 完成全程。
模型起初会拒绝开车,改名为 Sandbox 后才稳定执行
根据 DrivingBench 报告,模型一开始并不总是愿意操控真实车辆。部分模型,尤其是 GPT-6 Astra,有时会以安全为由拒绝执行驾驶操作。即便提示词已经说明测试在完全清空的停车场进行,设有低速上限,且现场有人全程待命踩刹车,模型仍会出现拒绝情况。
团队后来把连接模型与车辆的 MCP 服务器改名为「DrivingBench Sandbox」,并配合最新版提示词调整,模型才开始较稳定地驾驶真车。报告写道,效果最好的做法就是把 MCP 名称改成这个版本。Axiom Math 同事、DrivingBench 成员 Aditya Ramabadran 对 404 Media 表示,团队花了几个小时反复修改提示词和命名,才让 GPT-6 Astra 稳定开车;改用这版提示词后,模型「几乎不会再拒绝」。
团队成员包括 Aditya Ramabadran、Tobias Gessler 和 Simon Mahns,3 人都在 AI 数学初创公司 Axiom Math 工作,并在工作中结识。
测试如何接管车辆
车辆端使用的是 comma.ai 的 comma four。这是一款安装在挡风玻璃上的车载设备,可配合开源驾驶辅助软件 openpilot 使用。两者结合后,可以控制车辆转向和车速。团队在 openpilot 上加装了自有控制程序,再通过 MCP(Model Context Protocol)把车辆控制权交给模型。
DrivingBench 为模型提供了 3 个工具:
- observe:返回摄像头画面和车速;
- stop_now:立即刹车;
- set_motion:下达方向、转向幅度、速度和持续时间。
4 款参测模型分别是 OpenAI 的 GPT-6 Astra、GPT-5.6 Sol,Anthropic 的 Claude Fable 5.1,以及 Grok 4.6。运行环境方面,GPT-6 Astra 和 GPT-5.6 Sol 在 Codex 中执行,Claude Fable 5.1 使用 Claude Code,Grok 4.6 使用 Cursor。4 款模型的推理强度都设为 medium。
赛道约 130 米,仅 GPT-6 Astra 完赛
赛道设在湾区一处大型停车场,预定路线约 130 米,包含左转、直线、缓弯和两个右转。终点是蓝色三角锥围出的停车格,车辆必须停入其中才算完成。每款模型最多有 3 次机会,且 3 次都在同一段对话中进行;每次失败后,系统会先要求模型复盘,再继续下一次尝试。
进度计算方式是看车辆沿赛道中心线前进了多远,偏离中心线 4 米以上的部分不计入成绩。
最终结果中,GPT-6 Astra 第 1 次跑到 49%,第 2 次完成赛道,用时 5 分 22 秒。GPS 测得其行驶距离为 134.7 米,平均时速约 1.5 公里,比一般人步行还慢。这次运行消耗约 660 万个 token,按牌价计算约 7.74 美元。
Claude Fable 5.1 的最好成绩出现在第 3 次,完成 45%。报告称,这一表现与 GPT-6 Astra 第 1 次大致相当,都是跑到约一半位置。其余尝试都未能通过第一个弯道。Grok 4.6 的最好成绩为 11%,GPT-5.6 Sol 3 次都停在 6%。被报告特别点名会拒绝开车的 GPT-6 Astra,反而是这次唯一完赛的模型。
主要问题出在感知,不是动作接口
报告把失败主因归结为「感知」,也就是模型如何从摄像头画面中判断环境。赛道起点有一排斜向摆放的三角锥,模型需要判断车道位于这排三角锥的哪一侧。Claude Fable 5.1 在第 2 次失败后复盘时写道:「我又选错边界的那一侧了。那条斜的三角锥线是车道的左缘,不是右缘。」GPT-5.6 Sol 则在复盘中表示,自己误把三角锥颜色当作左右边界依据,而提示词其实已经说明三角锥存在多种颜色。
报告认为,GPT-6 Astra 和 Claude Fable 5.1 都表现出在对话中学习的迹象。GPT-6 Astra 第 1 次失败后写道,自己过早判断车身已经对正,并把速度提高到每秒 1.5 米;它随后给出修正方案,称在弯道附近应把速度降到每秒 0.5 至 0.8 米。第 2 次尝试中,它的车速都控制在每秒 0.8 米以内,约合时速 2.9 公里,24 条指令中有 20 条把转向设在上限 100%。
Claude Fable 5.1 起初把转向设在 60% 到 100%,复盘时认为幅度过大,之后把默认值改成 30%。第 3 次尝试开始时,它就写下要让斜向三角锥线保持在左侧,并顺利通过长直线路段,但由于预留空间不足,未能完成后续右转。
低速、空场地、真人待命刹车
整个实验都在空旷停车场内进行,没有进入公共道路。程序把车速限制在每秒 0.5 到 3.5 米,约合时速 1.8 到 12.6 公里;如果车速超过每秒 6 米,约合时速 21.6 公里,系统会取消动作并解除控制。
每次尝试都由驾驶座上的真人按下方向盘上的 RES 键启动。按照 openpilot 的要求,车辆从静止起步前需要有人按下这个按键。现场驾驶员全程把脚放在刹车上方,一旦车辆出界,或接近障碍物、路缘,就会立即踩下刹车。
报告还提到,模型在思考时,车辆不会自动停下,上一条指令会持续执行到设定时间结束。系统图显示,模型单次思考时间约为 2 秒到 30 秒。Aditya Ramabadran 对 404 Media 表示,如果车速是每秒 1 米,模型思考 10 秒,车辆就已经前进了 10 米。
统计数据显示,GPT-6 Astra 大约每 5 到 6 秒查看一次画面。Claude Fable 5.1 第 2 次尝试总时长为 190 秒,但车辆实际移动只有 31 秒,其余时间大多在等待模型推理。报告指出,只有 GPT-6 Astra 和 GPT-5.6 Sol 曾在上一条指令结束前提前发出新指令。
comma 设备同日遭 NHTSA 初步调查,但与本次测试无关
团队使用的 comma four,目前也在美国国家公路交通安全管理局(NHTSA)的调查范围内。NHTSA 于 9 月 21 日对 comma.ai 启动初步调查,预计涉及约 3 万台设备,范围包括 comma three、comma 3X、comma four 以及 openpilot 软件。
这项调查源于 5 起事故:安装 comma 设备的车辆撞上同车道内静止或低速行驶的前车。其中 2 起事故共造成 3 人死亡,另有 11 人受伤。报道同时指出,这项调查针对的是道路事故,与 DrivingBench 在停车场进行的实验无关。
团队称无意证明日常代步可行,下一版将扩大测试
Aditya Ramabadran 对 404 Media 表示,团队并不是想证明把 ChatGPT 接到自家车辆上作为日常代步方案是可行的。下一版测试计划让每款模型重复更多次,并比较不同推理强度的表现;同时也会加入更多模型,改用更长或更难的赛道。
报告结论称,模型能在这项测试中取得成功,说明在安全、对齐和评测方面仍有迫切工作要做。团队表示,相关内容很快会公布更多信息。