
GitHub 上一批开发者对英伟达 GPU 底层计算限制的探索,正在把部分 GeForce 显卡的「隐藏算力」挖出来。按照公开测试结果,在不更换硬件、不刷写显卡 BIOS、也不修改 NVIDIA 官方驱动的前提下,RTX 4090 在特定 Tensor Core 混合精度运算中的吞吐率可从 165.6 TFLOPS 提升到 331.6 TFLOPS,接近翻倍。

这次被验证的并不只有 RTX 4090。社区测试显示,RTX 3090 Ti、RTX 4070 Ti SUPER,以及 2018 年发布的 RTX 2080 Ti,也都出现了明显性能提升。相关项目目前已覆盖 RTX 20、30、40 三代显卡,部分开发者还在 Windows 11 环境中完成了实验。
RTX 4090:特定 Tensor Core 吞吐率接近翻倍
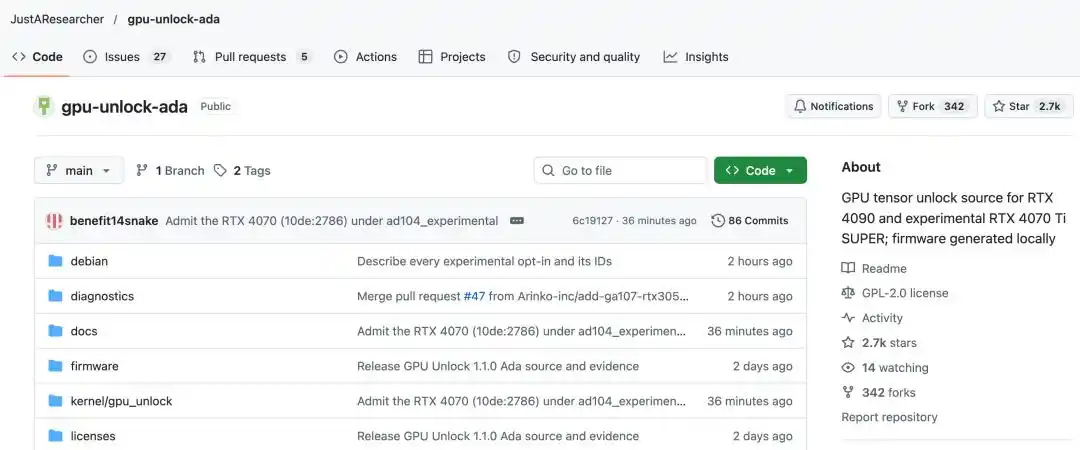
最受关注的结果来自开发者 JustAResearcher 的开源项目 gpu-unlock-ada。项目上线 2 天后,Star 数达到 2.7k。
项目地址:https://github.com/JustAResearcher/gpu-unlock-ada
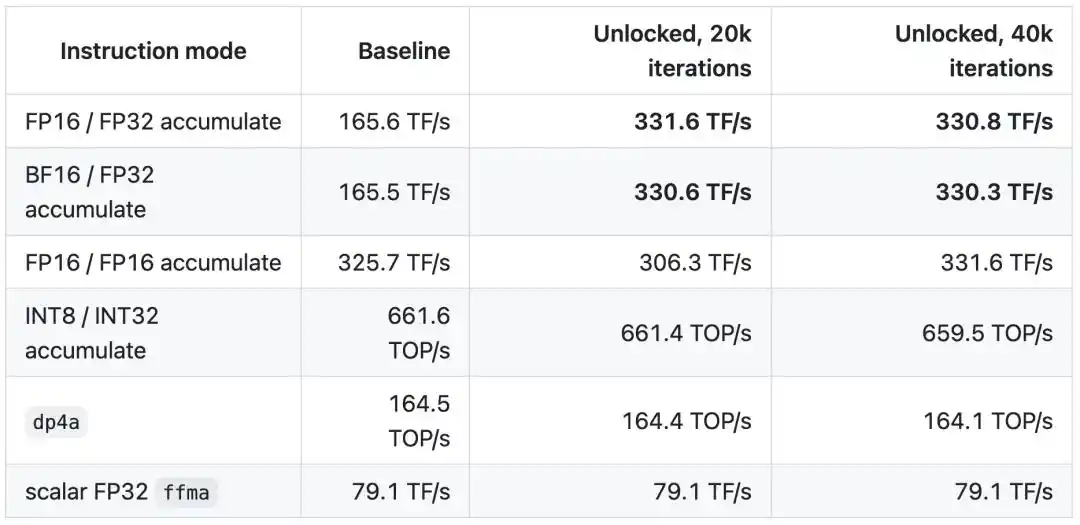
测试显示,在 FP16 输入、FP32 累加的 Tensor Core 运算中,RTX 4090 的吞吐率从 165.6 TFLOPS 提升至 331.6 TFLOPS;在 BF16 输入、FP32 累加测试中,吞吐率则从 165.5 TFLOPS 提升至 330.6 TFLOPS。两项结果都接近翻倍。
为排除偶然因素,开发者把测试循环次数从 2 万次增加到 4 万次,得到的 FP16/FP32 和 BF16/FP32 吞吐率分别为 330.8 TFLOPS 和 330.3 TFLOPS,与此前结果基本一致。
整个实验没有更换显卡硬件,也没有通过提高功耗上限、手动超频或修改 NVIDIA 官方驱动来获得性能提升。根据技术报告,测试显卡采用 AD102 芯片,拥有 128 个 SM,运行 Linux 7.2.4 内核,功耗上限保持在 450W。开发者利用 GPU 启动阶段的固件执行流程,打开受保护寄存器的写入权限,随后修改控制计算速率的寄存器配置。
配置完成后,显卡经历了一次 PCIe 功能级重置(FLR),随后由未经修改的 NVIDIA 615.78.08 驱动正常接管。驱动初始化和 CUDA 测试后的寄存器检查显示,解锁配置仍然生效。按项目披露的说法,RTX 4090 在部分 Tensor Core 运算模式下的速率限制被解除,FP16/BF16 输入、FP32 累加指令因此获得更高吞吐率。
不过,这种变化并没有覆盖所有运算类型。FP16 输入、FP16 累加的吞吐率在解锁前已经达到 325.7 TFLOPS,解锁后在较长循环测试中为 331.6 TFLOPS,没有出现类似翻倍的变化;INT8 运算吞吐率基本维持在 661 TOPS 左右,普通 FP32 标量运算也保持在约 79.1 TFLOPS。这说明,解锁主要影响的是此前受到速率限制的特定 Tensor Core 运算路径,而不是让 RTX 4090 的全部计算能力同时翻倍。
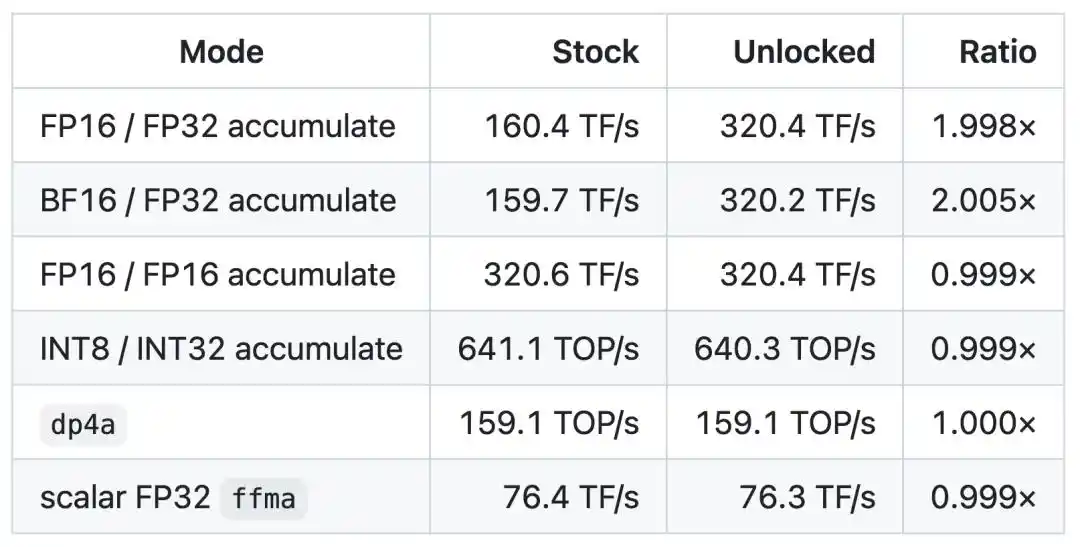
另一位 RTX 4090 持有者随后使用经过审查的项目代码完成了独立复测。该实验采用 Linux 7.2.11-arch1-1 内核和 NVIDIA 615.78.08 驱动,在同一张显卡、相同测试程序和 450W 功耗上限下,FP16 输入、FP32 累加的指令吞吐率从 160.4 TFLOPS 提升至 320.4 TFLOPS,BF16 输入、FP32 累加则从 159.7 TFLOPS 提升至 320.2 TFLOPS,两项结果同样接近翻倍。
复测地址:https://github.com/JustAResearcher/gpu-unlock-ada/blob/main/docs/evidence/rtx4090-pr1-matched/README.md
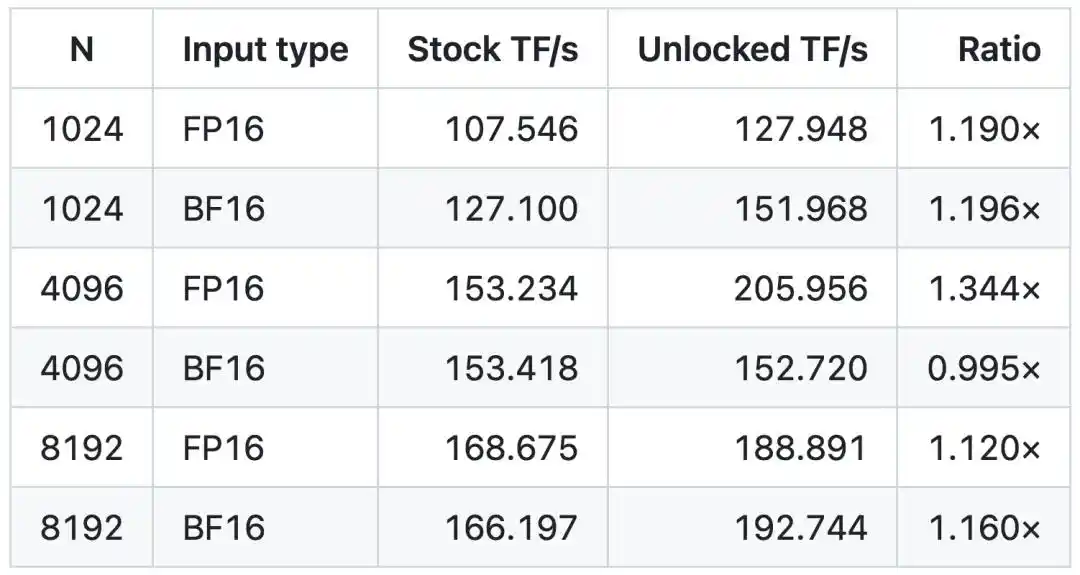
但当测试从底层指令吞吐率转向实际矩阵乘法时,增幅明显收窄。使用 cuBLAS 进行的矩阵乘法测试中,FP16 运算吞吐率随矩阵规模不同提升约 12% 至 34%。其中,4096×4096 矩阵乘法的吞吐率从 153.2 TFLOPS 提升至 206.0 TFLOPS,增幅约 34.4%。BF16 的结果差异更大:1024×1024 和 8192×8192 规模分别提升约 19.6% 和 16.0%,但在 4096×4096 测试中,性能基本没有变化。
这组差异与测试方式有关。底层指令吞吐率测试尽量减少了内存访问等因素的影响,而真实矩阵乘法还涉及数据搬运、计算调度以及不同规模下的运算效率。现有结果说明,RTX 4090 特定 Tensor Core 指令吞吐率翻倍已经得到独立复测支持,但这并不等于实际 AI 训练或推理速度也会同步翻倍。
RTX 30 系列:多款显卡出现 70% 以上增幅
RTX 30 系列的进展来自开发者 Zagitta 的开源项目 gpu-unlock。该项目已经在多款 RTX 30 系列显卡上完成验证。
项目地址:https://github.com/Zagitta/gpu-unlock
其中,RTX 3090 Ti 的表现较为突出。在 450W 功率上限下,BF16 矩阵运算吞吐率从 87.5 TFLOPS 提升至 157.4 TFLOPS,增幅接近 80%;TF32 的提升达到 94%。
RTX 3080、RTX 3070 和 RTX 3060 也陆续出现成功解锁的测试结果。RTX 3080 10GB 的 BF16 吞吐率从 65.4 TFLOPS 提升至 113.4 TFLOPS,增幅约 73%;RTX 3070 和 RTX 3060 的相关测试则分别取得约 81% 和 76% 的提升。
从实现方式看,gpu-unlock 与 RTX 4090 的方案相近,同样利用 GPU 启动阶段的固件执行流程,修改控制 Tensor Core 指令发射速率的寄存器配置。项目披露,NVIDIA GPU 内部存在用于控制不同指令执行速率的寄存器,包括 SS0 和 SS1,这些寄存器受到权限保护,普通驱动无法直接修改。
Zagitta 借鉴了此前 CMP 显卡解锁项目中的 V67 技术,利用 GPU 安全启动固件中的漏洞,通过返回导向编程(ROP)修改权限级别掩码(PLM),从而获得对相关寄存器的写入权限。随后,程序将 SS0 设置为 0*88888888,SS1 设置为 0*8,使对应运算路径切换到更高的指令发射速率。

与直接修改 NVIDIA 驱动不同,Zagitta 把整个解锁过程整合进 Linux 内核模块。系统启动时,该模块会在 NVIDIA 官方驱动接管显卡之前运行,先完成寄存器配置修改,再通过 PCIe 功能级重置使配置生效,之后未经修改的 NVIDIA 驱动仍可正常加载。按项目描述,这套方案可让部分 Ampere 架构显卡在执行 FP16/BF16 输入、FP32 累加指令时,达到原来两倍的指令发射速率。
随着项目传播,越来越多用户开始提交独立测试结果。一位使用 RTX 3080 10GB 的开发者在 320W 功率上限下进行了进一步测试。除了 BF16 吞吐率提升约 73%,FP16 输入、FP32 累加的矩阵运算吞吐率也从 64.88 TFLOPS 提升至 110.14 TFLOPS,增幅约 70%。
在持续 120 秒的 FP16/BF16 交替矩阵运算测试中,显卡完成的计算次数从 6940 次增加至 11860 次,平均吞吐率提升约 71%。两次测试的功耗都维持在约 318W,峰值温度分别为 78℃ 和 79℃。
测试还验证了计算结果的正确性。在 FP16、BF16 和 TF32 矩阵运算中,解锁前后的输出完全一致。但并不是所有计算任务都会出现类似提升。原本就以较高速率执行的 FP16 输入、FP16 累加运算,吞吐率基本保持在 112 TFLOPS 左右;INT8 运算和普通 FP32 运算也几乎没有变化。
除矩阵运算外,部分实际 AI 任务也出现加速。一位 RTX 3090 用户使用 vLLM 运行 27B BF16 大模型时,提示词预填充速度提升约 33%,首个 Token 的响应时间缩短约 24%。另一位使用两张显存扩容版 RTX 3080 的开发者,在大模型预填充测试中也取得约 33% 至 36% 的性能提升。
不过,两组实验中的逐 Token 生成速度都没有明显变化。公开说明给出的原因是,大模型预填充阶段需要进行大量矩阵计算,而逐 Token 生成往往更受显存带宽限制。
RTX 2080 Ti:Turing 架构也被验证
更早一代的 RTX 20 系列也出现了进展。开发者 nlzy 将 gpu-unlock 的相关技术移植到 NVIDIA Turing 架构,并在 GitHub 上开源了 turing-unlock 项目。
项目地址:https://github.com/nlzy/turing-unlock
开发者测试的是一张采用 22GB 非标准显存配置的 Dell RTX 2080 Ti。原版 RTX 2080 Ti 只有 11GB 显存,因此这张测试卡与普通零售版在硬件配置上存在区别。在 250W 功耗设置下,开发者使用 cuBLAS 进行了 FP16 输入、FP32 累加的矩阵乘法测试。当矩阵的 M、N、K 三个维度均为 2048 时,吞吐率从解锁前的 55.7 TFLOPS 提升至 91.4 TFLOPS,增幅约 64.1%。
其他矩阵规模也出现不同程度提升:
- 1024:从 50.3 TFLOPS 提升至 68.3 TFLOPS,提升约 35.8%;
- 4096:从 53.7 TFLOPS 提升至 81.7 TFLOPS,提升约 52.1%;
- 8192:从 52.8 TFLOPS 提升至 77.9 TFLOPS,提升约 47.5%。
作为对照,NVIDIA 在 Turing 架构白皮书中给出的 RTX 2080 Ti 对应 FP16 Tensor Core 峰值吞吐率为 56.9 TFLOPS。按这一数字计算,2048 规模下解锁前的测试结果达到标称峰值的 97.9%,解锁后则达到 160.6%。从公开测试看,原先的速率配置确实限制了这条计算路径的吞吐率,调整配置后,原有 Tensor Core 可以在相应运算模式下执行更多计算。
类似结果也出现在另一名开发者的实验中。GitHub 用户 haohervchb 发布了单独的 Turing-unlock 研究项目,针对一张 ASUS RTX 2080 Ti 进行了测试。这张显卡采用 TU102 芯片,拥有 68 个 SM,显存容量为标准的 11GB。与 nlzy 的 Linux 内核模块不同,该项目采用系统启动前的 UEFI 执行方案,在操作系统加载之前修改 GPU 的相关配置。
项目地址:https://github.com/haohervchb/Turing-unlock
在 FP16 输入、FP32 累加的底层 MMA(矩阵乘加)指令测试中,解锁前的吞吐率为 46.94 TFLOPS,解锁后达到 93.66 TFLOPS,接近翻倍。以每个 SM、每个时钟周期执行的浮点运算次数衡量,性能从约 511.7 FLOP/SM/clock 提升至 1022.4 FLOP/SM/clock。
换成实际 cuBLAS 矩阵乘法测试后,增幅有所收窄。在 8192×8192 规模的 GEMM 测试中,吞吐率从 48.15 TFLOPS 提升至 85.17 TFLOPS,增幅约 76.9%。虽然没有达到底层指令测试中接近两倍的水平,但对一张 2018 年发布的显卡来说,这仍是相当明显的提升。
目前,两项研究的验证范围仍然有限。现有证据只能说明,部分 TU102 显卡能够通过修改速率配置提高特定 Tensor Core 运算的吞吐率。其他 RTX 20 系列型号能否使用相同方法,不同驱动和固件版本下的兼容性如何,仍需继续验证。实际 AI 训练、推理和游戏性能能提升多少,也无法直接由这些测试数据推算。
Windows 11:已有实验性结果
目前公开探索主要集中在 Linux 环境,但 Windows 平台也已经出现实验性进展。开发者 TOTORONG 在 Hugging Face 上公开了 AD103_win_unlocker,展示了在 Windows 11 环境下修改 GPU 计算配置的实验。
项目地址:https://huggingface.co/TOTORONG/AD103_win_unlocker/blob/main/docs/INSTALL.en.md
测试使用的是一张经过显存扩容、容量达到 32GB 的 RTX 4080,采用 AD103 GPU。与前述 Linux 内核模块方案不同,这套方法使用 UEFI 程序,在 Windows 启动前执行相关配置修改,再将控制权交还 Windows。
项目公布的测试结果显示,在 4096 规模的矩阵乘法中,FP16/FP32 吞吐率从 91.54 TFLOPS 提升至 182.80 TFLOPS,BF16/FP32 则从 91.91 TFLOPS 提升至 184.49 TFLOPS,两项结果都接近翻倍。这表明,相关底层配置修改并不只局限于 Linux 系统。
不过,现阶段 Windows 11 的结果仍来自特定改装显卡,尚不能作为普通 RTX 4080 或整个 RTX 40 系列通用兼容的依据。
公开验证仍在继续
从目前披露的项目看,这轮开源探索的共同点很明确:开发者试图在 GPU 启动阶段修改受保护寄存器的配置,让部分原本受限的 Tensor Core 运算路径恢复更高的指令发射速率。已公开结果覆盖 Ada、Ampere 和 Turing 三代架构,Linux 方案中原版 NVIDIA 驱动也可以继续运行。
但这些结果同样有边界。现有测试主要证明,部分 GeForce 显卡在特定混合精度运算下的底层吞吐率可以显著提高;至于不同型号、不同驱动版本、不同固件版本的兼容性,以及真实 AI 训练、推理和游戏场景中的收益,还没有统一结论。
参考链接:https://x.com/Pirat_Nation/status/2114297495815704697
本文来自微信公众号「机器之心」(ID:almosthuman2014),作者:关注开源的。



