研究版 Claude 将黎曼猜想相关下界从 41.6% 提高至 67.2%
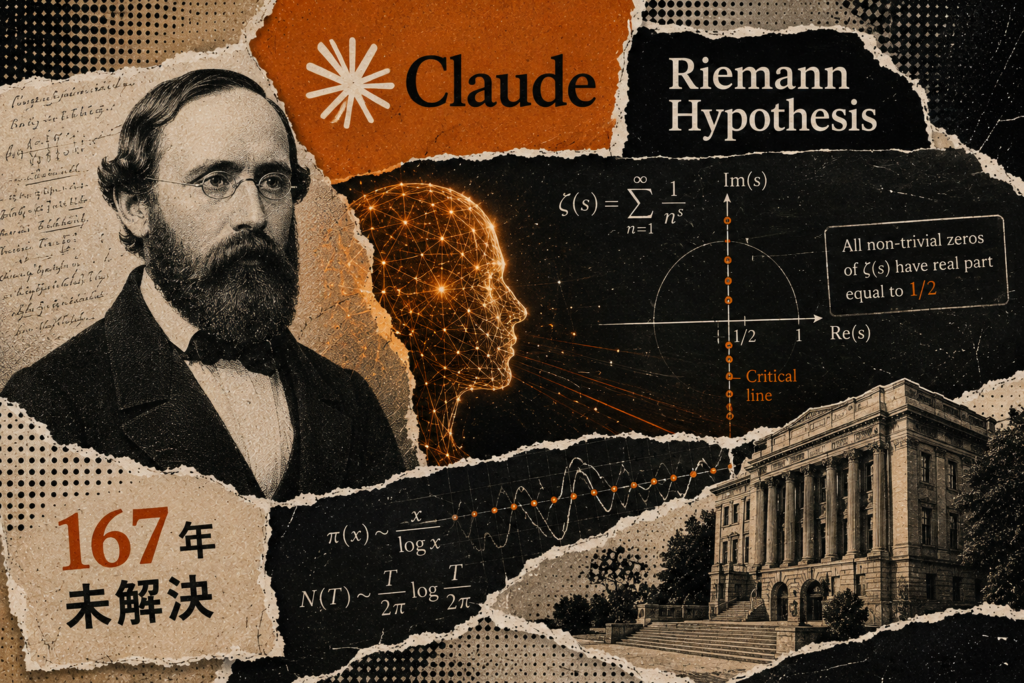
Anthropic 在官方研究公告中披露,一款尚未发布的研究版 Claude 在黎曼猜想相关指标上取得单次最大突破,把已被证明的下界从 41.6% 提高到 67.2%。Anthropic 表示,这一成果不能直接证明完整的黎曼猜想,但属于明确的量化进展。该结果由约 60 个自主子代理在约 36 小时内完成,经历约 650 个失败思路后形成,并最终产出一份以 Lean 形式化、可由机器验证的证明。

Anthropic 在官方研究公告中披露,一款尚未发布的研究版 Claude 在黎曼猜想相关指标上取得单次最大突破,把已被证明的下界从 41.6% 提高到 67.2%。Anthropic 表示,这一成果不能直接证明完整的黎曼猜想,但属于明确的量化进展。该结果由约 60 个自主子代理在约 36 小时内完成,经历约 650 个失败思路后形成,并最终产出一份以 Lean 形式化、可由机器验证的证明。

Anthropic 本周披露,尚未发布的 Claude 研究版本曾被要求尝试证明黎曼猜想,虽然未能完成证明,但把满足该猜想的 zeta 函数零点比例已知下界从 41.6% 提高到 67.2%。相关结果经过 Anthropic 内部数学家、外部专家审阅,并完成 Lean 形式化验证。研究过程横跨两个工作阶段,累计消耗 3100 万个输出 token。

AI 初创公司 Prime Intellect 推出采用 MIT 许可的开源自我改进代理框架 Prime Agent。根据其官方博客,在 Opus 5 驱动下,该框架在 ARC-AGI-3 测试中拿到 95.5%,略高于人类专家 95.4% 的基线。Prime Intellect 称,成绩提升来自重设计既有模型外层框架,而非训练新模型;其核心包括递归语言模型与可自我改写的持续框架。

Claude Opus 5发布两天后,Matt Shumer展示了一款由模型独立生成、可直接游玩的第一人称射击游戏,构建过程未使用外部素材。其公开的三段式提示词要求模型拆分子任务、引入独立批评器,并持续迭代到接近《使命召唤》画面标准。随后,James Altucher、Atom Tan Studio和Leon Lin分别用相同或更长提示复现类似结果。不过,报道也指出,这类作品尚未排除训练数据污染的可能,"从零构建"的说法仍需谨慎看待。

CryptoComLearn刊文梳理 Anthropic 围绕 Claude Fable 5 的自我改进代理方法,核心包括循环、动态工作流、Routines 与记忆机制,并给出 14 步搭建路径。

CryptoComLearn发布长文,梳理Fable 5自我改进代理的14步方法,核心围绕循环、动态工作流、Routines与记忆设计,强调系统复用与独立验证者。

OpenAI发布两款轻量模型GPT-5.4 Mini与Nano,主打子代理执行层场景。Mini推理速度较前代提升2倍,Nano输入价格低至每百万token 0.2美元。

Nous Research发布Hermes Desktop公开预览版,以MIT授权免费开源。桌面应用支持三大平台,整合持久记忆、自然语言排程和超300种模型,让开源AI代理脱离终端操作。